Intel 异构调度 Thread Director:P/E core 指令分类与 OS 协同机理
更新时间:2026-10-05。从 Alder Lake(第 12 代酷睿)开始,Intel 桌面与移动端处理器进入「性能核 P-core + 能效核 E-core」的混合架构时代:同一个封装里两类微架构不同、频率区间不同、每瓦性能曲线交错的核并存。这对操作系统调度器提出了一个全新问题——传统调度器假设所有 CPU 等价(SMP 同构),只需要均衡负载;异构平台上「把哪个线程放哪类核」直接决定性能与功耗的双重收益。Intel 给出的硬件答案是 Thread Director(英特尔线程导向器,简称 ITD):一个嵌入在每个核里、按纳秒级观察指令流的硬件反馈单元,它把「这个核上跑的负载是什么类型、换个核跑会快多少」量化后交给 OS。频率与功耗管理的大背景见 CPU 功耗与频率管理 与 硬件 P-state 与 C-state,单核并行度背景见 SMT 同时多线程。
本文要回答的问题
- Intel 异构调度 Thread Director 在硬件里到底是什么?它看到什么、输出什么?
- ITD 的指令分类表把负载分成哪四类?分类依据是什么?
- EHFI 反馈表如何告诉 OS「线程 A 换到另一类核会快多少」?
- Windows 与 Linux 各自怎么消费这份反馈?调度协同路径长什么样?
- 真实负载下 Thread Director 的表现如何?什么时候它帮倒忙?
一、为什么需要 Thread Director:异构平台上调度器变「瞎」了
同构 SMP 时代,Linux CFS 或 Windows 调度器的核心假设是「随便挑一个空闲核,跑起来速度一样」。这个假设在 Alder Lake 上彻底失效:P-core(Golden Cove/Raptor Cove 系)有 6 宽译码、512 项 ROB、支持 AVX-512 时代遗传下来的宽向量单元(消费级实际关闭),单线程 IPC 高但功耗上限也高;E-core(Gracemont 系)是同面积下塞四颗的小核,乱序窗口窄、频率低,单线程性能大约只有 P-core 的 60% 到 70%,但每瓦性能在低负载段显著更好。两者共享同一片 L3 和内存控制器,缓存一致性由 ring/mesh fabric 维持,拓扑背景见 片上 ring 与 mesh 互连。
这意味着同一段代码在两类核上的执行效率差距是 1.5 倍起步,而且比值随负载类型变化:标量整数、分支密集的代码在 P-core 上赚得最多;纯内存拷贝、等待为主的代码放哪类核差别不大;向量吞吐型代码甚至可能出现「E-core 集群总吞吐反超」的情形。调度器如果不知道「这个线程属于哪一类」,就只能瞎放——这就是 Thread Director 存在的理由。
| 维度 | P-core(性能核) | E-core(能效核) |
|---|---|---|
| 微架构目标 | 单线程峰值 IPC | 单位面积/功耗吞吐 |
| 乱序窗口 | 宽(ROB 500 项级) | 窄(ROB 200 项级) |
| 频率区间 | 高(可达 5GHz+) | 中低(3GHz 到 4GHz 级) |
| 单线程性能 | 基准 100% | 约 60% 到 70% |
| 优势负载 | 分支密集、延迟敏感 | 后台吞吐、批量并行 |
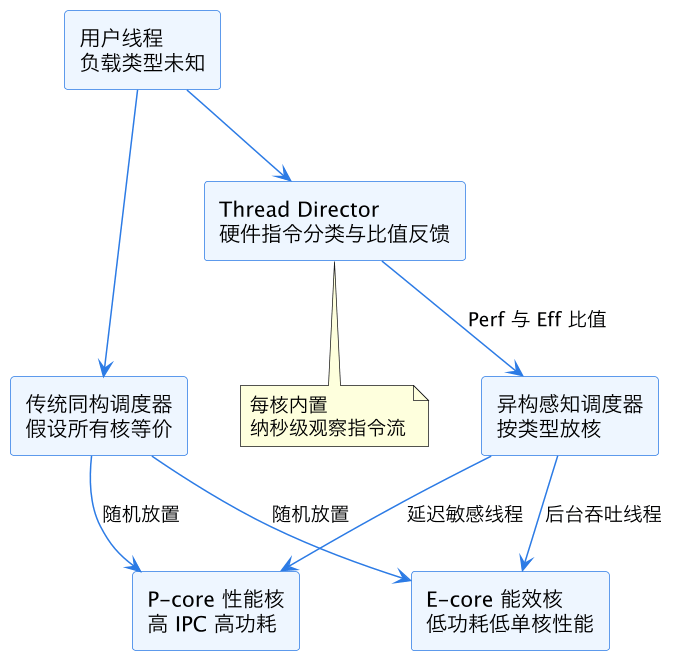
上图对比了两条世界线:左边没有 Thread Director 时调度器只能随机放核,放错了线程就跑不满;右边 ITD 把负载类型量化成比值交给调度器,放核变成有据可依的决策。注意 ITD 本身不做调度决策——它只提供「情报」,拍板的仍然是 OS。
二、指令分类表:ITD 把负载分成四类
Thread Director 的核心是一个硬件分类器:它在每个核上持续观察退休(retire)路径上的指令构成,按纳秒级时间窗把当前负载归入四个类(Class 0 到 Class 3)。分类不看「进程名」「优先级」这些软件概念,只看指令流的微观构成。
| 类 | 名称 | 判定特征 | 典型负载 |
|---|---|---|---|
| Class 0 | 标量整数/通用 | 常规 ALU、load/store 为主 | Web 服务、编译、游戏逻辑 |
| Class 1 | 向量整型/浮点 | SSE/AVX 向量指令占比高 | 媒体编解码、科学计算 |
| Class 2 | 专用加速类 | AI 推理相关(VNNI 等)指令密集 | 本地推理、图像增强 |
| Class 3 | 等待/低价值类 | pause、spin、大量 stall | 自旋锁等待、空闲轮询 |
分类的输出不是标签本身,而是两个比值:这个核上跑当前类的 Perf ratio(相对性能率)和 Efficiency ratio(相对能效比)。比如 Class 1 向量负载在 P-core 上的 Perf ratio 可能是 100,在 E-core 上只有 55,调度器一看就知道该往哪放;而 Class 3 等待型负载两边都接近,调度器可以放心把它赶到 E-core 上省电。
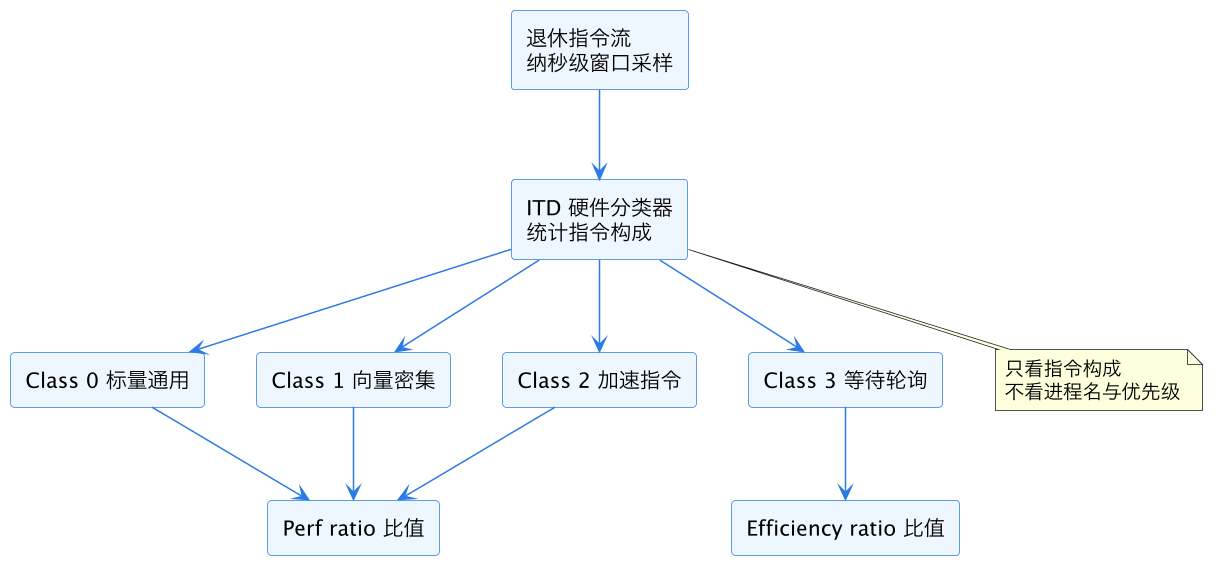
上图是分类器的数据流。值得强调两点:一是分类完全在硬件里完成,软件零开销,不像 PMU 采样那样要定期中断读计数器(PMU 路线的做法见 PMU 性能计数器编程);二是窗口极短,负载类型切换(比如游戏从物理计算切到渲染提交)能在毫秒级被重新归类,调度器迁移线程的决策延迟被压到调度 tick 量级。
三、EHFI 反馈表:硬件怎么把情报递给 OS
分类结果通过 HFI(Hardware Feedback Interface,硬件反馈接口;混合架构下常称 EHFI,Enhanced HFI)暴露给操作系统。机制上是一块由硬件维护、OS 映射只读的内存表:每核一行(逻辑 CPU 粒度),行内是该核跑当前类负载时的 Perf 与 Efficiency 两个 8 位相对比值。表在运行中由硬件动态更新——因为睿频、热限制、SMT 兄弟核竞争都会改变比值,热限制背景见 热节流与温度传感器。
除内存表外,硬件还可以在比值发生显著变化时触发 thermal interrupt(HFI 中断)通知 OS「表变了,该重新看一遍」。OS 侧的接力顺序是:固件/ACPI 宣告能力 → CPUID 叶 0x7/0x1A 暴露混合拓扑与 ITD 支持 → 内核启动时映射 EHFI 表 → 调度器在选核路径上查表。
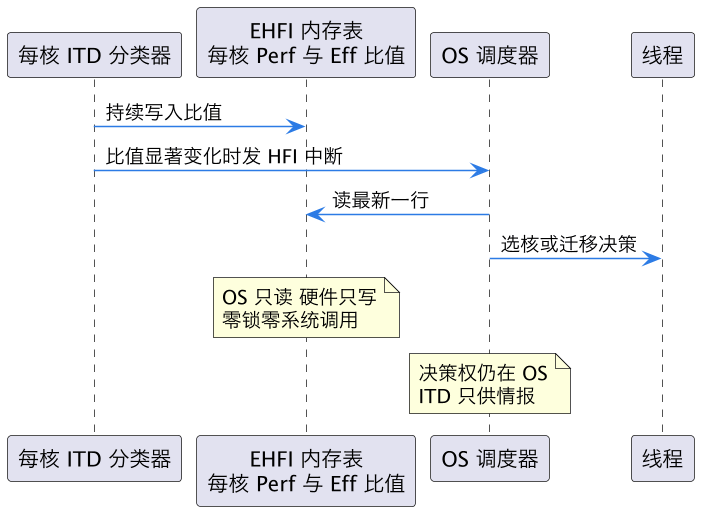
上图是反馈链路。两个设计取舍很讲究:用共享内存表而不是 MSR/中断高频通知,是因为调度器本来就高频查询,读内存几乎免费;把「拍板权」留给 OS,是因为线程优先级、cgroup、亲和性这些策略只有 OS 知道,硬件不应越权。
四、OS 调度协同:Windows 与 Linux 两条路
Windows 11 是最早消费 ITD 的系统:其调度器把 EHFI 比值直接纳入「选哪个核跑」的打分函数,前台窗口线程天然优先 P-core,后台服务和低 QoS 线程优先 E-core,整个策略与 Windows 既有的电源计划联动。实测表现是前台应用(游戏、浏览器活动标签)响应快,后台编译、索引、杀毒扫描被安静压到 E-core 集群。
Linux 侧的路更长。内核 5.16 起加入混合架构拓扑感知与 ITD 基础支持,intel_pstate 驱动在混合平台上启用 HWP 协同,调度器通过 sched_itmt(Intel Turbo Max Technology 路线的扩展)与 EHFI 表做偏好排序;lscpu 可以直接看到两类核的频率区间差异,/sys/devices/system/cpu/cpuN/cpufreq/ 下的区间就是证据。容器与虚拟机场景更复杂:vCPU pinning 到具体物理核类型成为运维动作,迁移代价见 per-core DVFS 频率控制 里讨论的频率-迁移耦合问题。
| 维度 | Windows 11 | Linux(5.16 起) |
|---|---|---|
| ITD 消费方 | 调度器内建打分 | intel_pstate 加调度器偏好 |
| 前台/后台区分 | 内建(窗口焦点) | 无原生概念,靠 cgroup/nice |
| 用户控制面 | 电源计划 | cpufreq、cgroup、affinity |
| 容器适配 | WSL2 透传 | 需手工 pin 或等内核策略 |
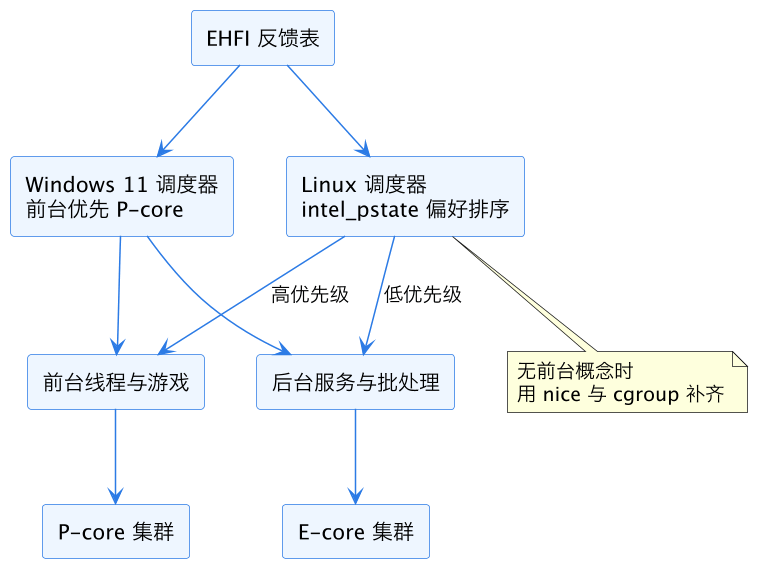
上图说明两条协同路径殊途同归:都读同一张 EHFI 表,差别在于「谁被定义为重要线程」。Windows 有窗口焦点这个现成信号,Linux 要靠 nice 值、cgroup 权重这些通用机制表达,运维时如果全部线程一个优先级,调度器就只能按负载类型均分,P-core 可能排不上真正的关键路径。
五、动手验证:在你自己的机器上看见 Thread Director
理论讲完,给一套可执行的观测路径。第一步确认拓扑:Linux 下 lscpu 的输出里如果看到两个不同的 CPU MHz 区间段(比如 800-3600 与 800-5200),就是混合平台;更精确的映射读 /sys/devices/system/cpu/cpuN/cpu_capacity(ARM big.LITTLE 风格)或对照核编号与手册,把「逻辑 CPU 号 → 核类型」列成一张小表。第二步确认 EHFI 表在不在:内核日志里 dmesg | grep -i hfi,出现 HFI/ITD 相关行说明硬件反馈接口已被内核接管;Windows 侧没有直接接口,但任务管理器的「效率模式」标记和核心停驻(core parking)状态能间接反映调度倾向。
第三步做个简单实验:起一个单线程 CPU 密集负载(stress-ng --cpu 1 或一段死循环脚本),用 top 按核展开(按 1)观察它被放到哪个逻辑 CPU 上;再放低优先级(nice -n 19)重跑,看它是否被赶到 E-core 编号段。这个迁移动作就是 ITD 比值表加调度器协同的直接证据——负载类型没变,优先级变了,放核结果跟着变。
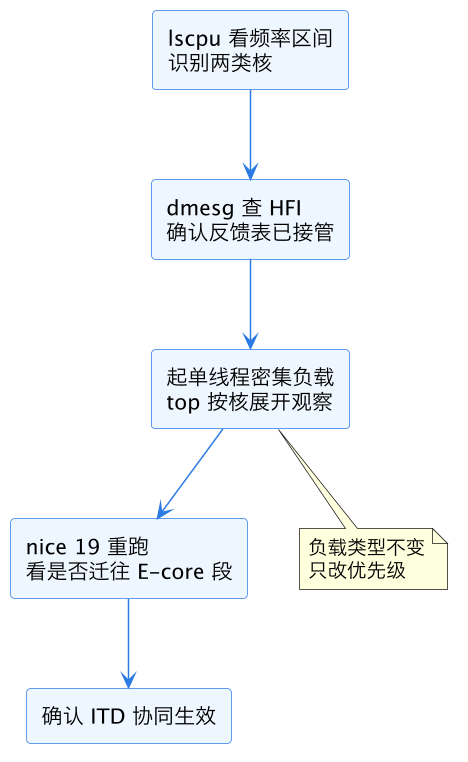
上图是四步验证链。它的价值在于把「硬件反馈」这个黑盒变成可见行为:一旦你在自己的机器上亲眼看到线程随优先级在两类核之间迁移,后面所有性能现象(为什么压测时监控进程不拖慢被测进程、为什么后台编译时前台依然流畅)都有了解释锚点。更深入的性能归因再上 PMU,采样方法见 PMU 性能计数器编程,瓶颈分层见 Top-down 微架构分析方法。
六、真实负载表现:什么时候省、什么时候帮倒忙
把理论落到数字。媒体编码(HandBrake 类)这类全核吞吐负载下,混合架构加 ITD 的表现通常漂亮:P-core 啃关键线程,E-core 集群提供额外 30% 到 50% 的总吞吐,功耗墙内性能超过同频纯 P-core 配置。游戏负载里,主线程放 P-core 保住了帧率下限,后台语音、录制、系统服务被赶到 E-core,干扰明显下降——这类收益用 Top-down 微架构分析方法 拆瓶颈时能直接看到 retire 占比的变化。
帮倒忙的场景同样真实存在。一是低线程数的专业软件(老 CAD、单线程为主的科学计算)如果被误判放 E-core,单线程性能直接打七折,只能靠进程亲和性手工救回;二是实时性敏感但优先级设置平平的负载(音频渲染、高频交易软路径),调度器按「类型」而非「deadline」放核,毛刺就来了;三是虚拟化环境里 hypervisor 未必透传 ITD,客户机看到的是被抽象掉的拓扑,所有协同全部失效。排查这类问题的入口是先确认线程实际跑在哪类核上(ps -eo pid,psr,comm 配合核编号映射),瓶颈定位方法论见 IPC 瓶颈分析。
再补一类容易被忽视的边界:电源模式切换会改写整张比值表。笔记本从电源拔掉切到电池时,P-core 的频率天花板被压低,Perf ratio 整体缩水,ITD 表里的数字随之更新,调度器的放核倾向也会跟着漂移——同一份负载在插电时该上 P-core,拔电后可能被判定「放 E-core 能效更划算」。这不是 bug,而是比值表「反映当前时刻真实能力」这一设计的自然推论,但做性能对比测试时必须固定电源状态,否则两次跑分根本不在同一张表上,结论无从谈起。
经验法则收敛成一句:Intel 异构调度 Thread Director 让「平均负载」放核质量显著提升,但「尾部延迟」和「少数关键线程」仍然是手工亲和性与优先级的领地——硬件给情报,策略永远是人定的。生产环境的混合平台上,关键服务显式 pin 核、其余交给 ITD 与调度器自由发挥,是目前最稳妥的组合拳。
这一篇在知识体系里的位置
本篇是微架构模块「功耗与调度协同线」的异构篇。上游是 CPU 功耗与频率管理 与 硬件 P-state 与 C-state——ITD 的比值表与 HWP 的自治调频共用同一套「硬件观测、OS 消费」的范式;同线的细粒度调频篇是 per-core DVFS 频率控制。单核性能背景见 SMT 同时多线程 与 IPC 瓶颈分析,观测工具侧见 PMU 性能计数器编程。全景地图见 CPU 微架构总览。
总结
Intel 异构调度 Thread Director 是 Alder Lake 起内置于每个核的硬件反馈单元:它按纳秒级把退休指令流分类成标量通用、向量密集、加速指令、等待轮询四类负载,算出该核跑当前类的 Perf 与 Efficiency 相对比值,通过 EHFI 共享内存表(必要时配 HFI 中断)交给操作系统;Windows 11 把它内建进前台/后台打分,Linux 从 5.16 起经 intel_pstate 与调度偏好消费。它让异构平台上的平均放核质量显著提升——P-core 保关键线程、E-core 集群补吞吐省电——但硬件只供情报不做决策,尾部延迟与少数关键线程仍要靠手工亲和性与优先级兜底。