load replay:数据未就绪与违例引发的装载重放机制、流水线恢复与 replay 风暴的 IPC 量化
更新时间:2026-10-04。乱序执行的核心赌注是「猜」:分支要猜方向,访存也要猜依赖。load 指令在地址算出来之后,往往等不及确认「前面那些 store 到底跟不跟我抢同一个地址」,就被调度器提前发射了——猜对了,load 提早拿到数据,后面一长串依赖它的指令跟着沾光;猜错了,或者数据根本没按预期就绪,这条 load 连同它的所有下游都要被作废,从头再来一遍。这个「作废重发」的动作就是 load replay(装载重放)。它是乱序引擎里最便宜的一种恢复机制——不像分支预测错误那样要冲刷整条流水线——但量变会引起质变:当 replay 频繁到以「风暴」的姿态出现时,发射槽被大量无效占用,IPC(Instructions Per Cycle,每周期指令数)可以无声无息地掉去两三成。上游机制见 load store queue 访存消歧 与 store to load forwarding 存储转发,流水线全貌见 uop pipeline 微指令流水线。
本文要回答的问题
- load replay 到底是什么?它和分支误预测的流水线冲刷差在哪?
- 哪些情况会触发 replay?五类触发源各自的硬件故事是什么?
- replay 发生时流水线内部做了什么恢复动作?代价按什么量级算?
- replay 风暴如何量化?IPC 被侵蚀的账怎么算?
- 用哪些 PMU 事件能定位 replay 是哪一种、来自哪段代码?
一、replay 是什么:介于「无事发生」与「全线冲刷」之间的恢复档
乱序核心里,指令被错误执行的频率远比直觉高。错误分三档处理。最重的一档是分支误预测:整条流水线冲刷,从正确的路径重新取指,代价 15 到 20 个周期起步,细节见 精确异常与流水线冲刷。最轻的一档是缓存未命中:load 不用作废,数据晚点来就行,乱序引擎靠 ROB(Reorder Buffer,重排序缓冲)窗口把延迟吞掉。load replay 卡在中间:load 本身已经发射、甚至已经拿到了一份「看似能用」的数据,下游指令可能已经消费了这份数据开始执行,但硬件随后发现这份数据不可信——于是只把 load 和它的依赖链作废,从发射阶段重来,前端取指、译码、重命名一概不动。
这就是为什么 replay 的单价便宜:一次 replay 的典型代价是 5 到 12 个周期的发射资源浪费,外加依赖链重新调度的开销,数量级远小于分支冲刷。但请注意「发射资源」这个词——乱序核的发射宽度是有限的(现代 Intel 核每周期最多发射 6 个左右微指令),replay 占掉的每一个发射槽,都是从别的有用指令嘴里抢走的。单次便宜,高频致命,这是理解 replay 的全部钥匙。
| 恢复机制 | 触发原因 | 作废范围 | 典型代价 |
|---|---|---|---|
| 分支误预测冲刷 | 预测方向或目标错 | 整条流水线含前端 | 15 到 20 周期起 |
| load replay | 数据未就绪或访存违例 | load 加依赖它的微指令 | 5 到 12 周期的发射资源 |
| 缓存未命中等待 | L1 未命中 | 不作废,仅延迟 | 由 MLP 能力吸收 |
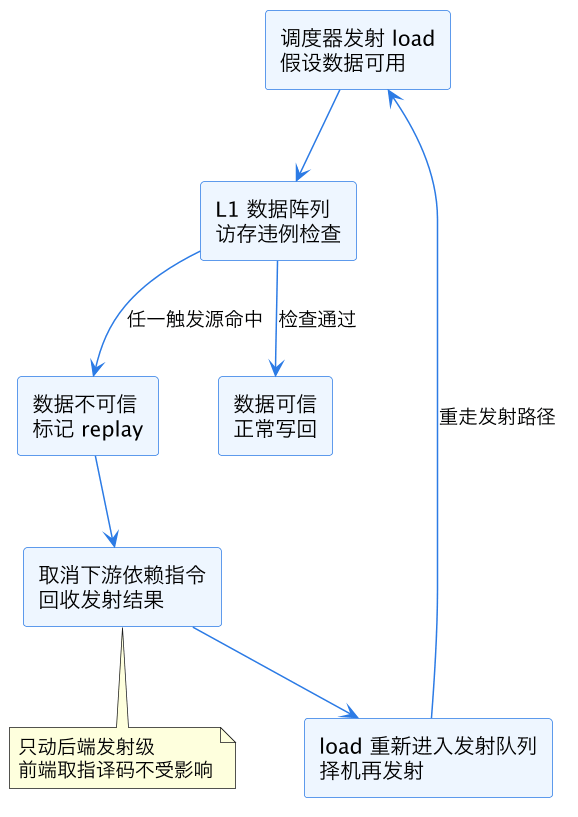
上图是 replay 的基本循环。注意那条回到「调度器发射」的回头边:replay 不是异常,没有陷入、没有微码辅助,纯粹是调度器层面的一次重排。这个循环每转一圈,发射槽就被消耗一轮,而程序员在源码层面完全看不见它——没有性能事件计数器的话,它唯一的痕迹就是 IPC 莫名偏低。
二、五类触发源:replay 从哪来
把 replay 的触发源按硬件故事分类,一共五种,前两种是本篇的主角。
第一类,memory disambiguation 违例,也称 4K aliasing 的近亲。load 提前发射时,流水线里还有更老的 store 没算出地址。硬件赌这些 store 与 load 不冲突;等 store 地址算出来一比对,发现撞上了同一个 cache line 甚至同一地址,load 拿到的数据就是旧值,必须 replay。更常见的一个变种是 4K 别名:load 与 store 的页内偏移相同(地址低 12 位一致)但页不同,部分微架构在低位匹配时就先保守 replay,免得承担真冲突的风险。两个线程的栈帧在不同页但页内布局雷同,是 4K 别名的高发场景。消歧机制本身见 load store queue 访存消歧,依赖预测怎么参与赌博见 内存依赖预测。
第二类,store to load forwarding 失败。理想情况下 load 可以直接从 store buffer 拿到前面 store 还没写回缓存的数据,省一趟 L1 访问。但转发有条件:store 的数据必须完整覆盖 load 的读取范围。一个 8 字节 load 压在一个 4 字节 store 上、或者 load 横跨两个 store,转发做不了,load 只能 replay 后等 store 写进缓存再读。这类失败在「先写小字段再读整个结构体」的代码里密集出现,转发成功的路径与限制见 store to load forwarding 存储转发。
第三类,L1 数据缓存的资源冲突。load 发射时假设 L1 的读端口和 bank 可用,实际撞上同周期的另一个访存争用同一个 bank,或者 TLB 查询与缓存访问时序对不上,load 拿不到数据,只能 replay。bank 冲突的细节见 缓存 bank 冲突。
第四类,数据未就绪的时序误判。调度器按「L1 命中 4 到 5 周期」的固定假设唤醒下游指令,某些微架构上 L1 实际延迟因电压频率状态或预取干扰变长了,下游指令到执行口时数据还没到,整条依赖链跟着 replay。
第五类,非对齐与跨行访问。一次 load 横跨两个 cache line 或跨页,需要拆成两次访存,部分场景以 replay 形式重发后半段。
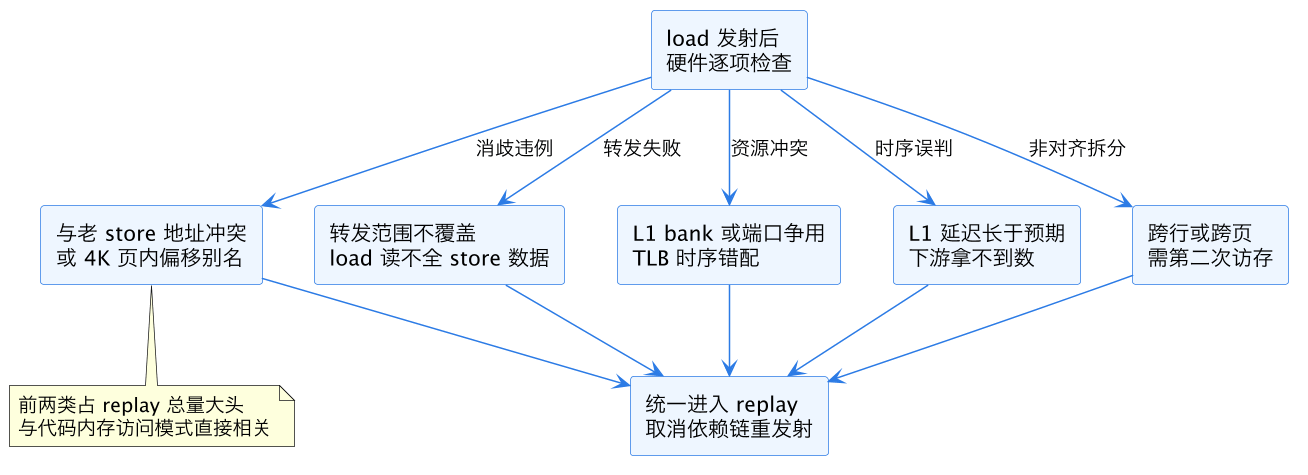
上图把五个触发源画成汇入同一出口的漏斗。实战中前两类(消歧违例与转发失败)通常占 replay 总量的大头,因为它们由代码的内存访问模式决定,会在热循环里以每个迭代一次的频率稳定复现;后三类更偏硬件状态的随机扰动。
三、replay 发生时的流水线动作:取消、重排队、再发射
replay 的恢复动作可以拆成三步看。第一步是标记:load 在执行级发现自己数据不可信,给自身打上 replay 标记,同时通过结果总线上的「取消信号」广播出去。第二步是取消:所有已经读取了这份不可信数据、正在执行或排队等待的下游微指令被作废——注意它们大多还在后端、没退休,所以不需要架构状态回滚,ROB 里的重命名映射完全不用动,这与分支冲刷要恢复 RAT(Register Alias Table,寄存器别名表)检查点形成鲜明对比,后者见 重命名检查点与分支恢复。第三步是重发射:load 重新进入调度器的就绪队列,等触发条件解除(比如那个更老的 store 地址算出来了、数据写回缓存了)再发射一次。
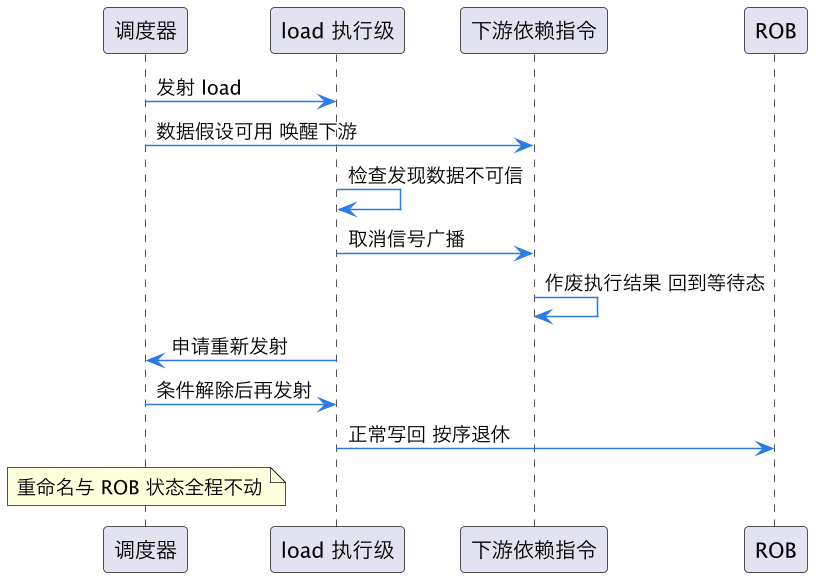
这张时序图里最值得盯的是取消信号和重发射之间的间隔。间隔多长,取决于触发源:消歧违例要等那个老 store 至少把地址算出来,通常几个周期;转发失败要等 store 数据真正写进 L1,十几个周期;如果倒霉撞上 L1 未命中后的重试,那已经是缓存未命命中延迟的范畴了。这也意味着同一个 replay 循环可以转好几圈——load 第二次发射时条件可能还没解除,再来一轮。连环 replay 是风暴的雏形。
四、replay 风暴:发射槽被吃掉的账怎么算
单看一次 replay 很便宜,风暴的破坏力来自频率。算一笔账:假设核心每周期能发射 6 个微指令,负载里 load 占 20%。如果每 20 条 load 有一条 replay 一次,发射带宽的损耗不到 1%,毫无感知。但如果热循环里有一条 load 每次迭代都 replay 两三轮——比如那个经典的「读整个结构体压在一个字段 store 上」模式——这条 load 一家就吃掉 3 倍于正常的发射槽,还连带取消下游一串指令的执行成果,这些下游之后也要重新发射。发射口被无效工作挤占,有用指令排不上队,IPC 就下来了。
Intel 在优化手册里给过一个量级参考:严重的 4K 别名或转发失败集中在热路径时,整体性能损失可达 10% 到 30%。这个量级与分支预测错误率 2% 左右的损失相当——但分支误预测人人都知道查,replay 风暴却经常在 profile 里以「IPC 偏低但 cache miss 不高、分支误预测也不高」的谜之形态出现。Top-down 分析里它藏在「核心绑定(core bound)」这一支,方法论见 Top-down 分析方法 与 IPC 瓶颈定位。
| 场景 | replay 频率 | IPC 影响 | 可感知症状 |
|---|---|---|---|
| 偶发 bank 冲突 | 千分之一量级 | 小于 1% | 无 |
| 热循环转发失败 | 每迭代 1 到 2 次 | 5% 到 15% | 同核性能莫名不如预期 |
| 4K 别名密集场景 | 每迭代多次 | 10% 到 30% | 数据布局微调后性能剧变 |
| 多线程伪共享叠加 | 风暴级 | 30% 以上 | 线程数增加反而不扩展 |
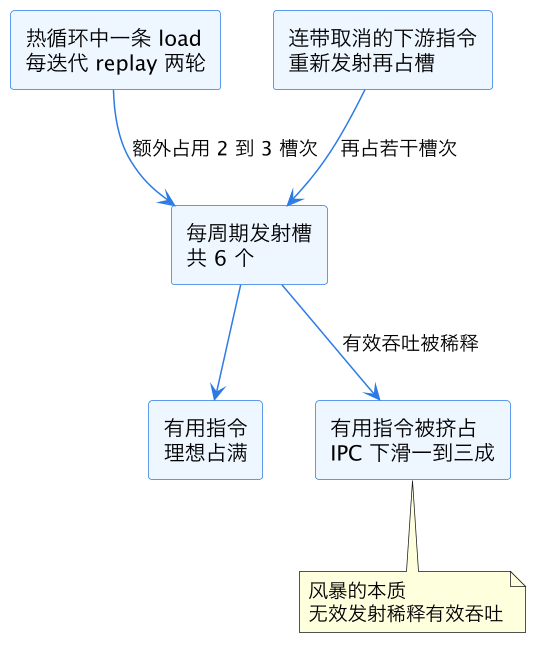
上图把风暴的账画在发射槽上:replay 本身加上被取消指令的重新发射,双重占用同一个有限资源。这也是为什么「减少 replay」的优化收益经常超预期——省下的不只是 replay 本身那几个周期,还有被它挤走的所有有用工作的机会成本。
五、观测与定位:PMU 事件、代码模式与修法
Intel 提供了一组直指 replay 的性能计数器(不同代微架构事件名略有出入,编程方法见 PMU 性能计数器编程):LD_BLOCKS.STORE_FORWARD 统计转发失败,LD_BLOCKS.NO_SR 统计 store 未就绪导致的阻塞,LD_BLOCKS_PARTIAL.ADDRESS_ALIAS 直接点名 4K 别名。用 perf stat -e 带上这些事件跑一遍负载,哪一类 replay 是主犯立刻现形;再用 perf record 采样定位到具体指令地址,对照源码看访存模式。
定位到之后的修法按触发源对症下药。4K 别名:调整数据布局,让频繁互访的 load 与 store 不要落在页内相同偏移上——给结构体加几十字节 padding、或者把两个缓冲区的分配错开一页内偏移,常常一行改动换 20% 性能。转发失败:让 store 与后续 load 的宽度对齐——写完整个 8 字节字段再按 8 字节读,不要写 4 读 8;结构上保证一次 store 完整覆盖之后的 load。时序误判类:减少 load 与最近 store 之间的调度紧密度,编译器选项或手工重排让 load 晚一点发射。伪共享叠加的风暴:治本在消除伪共享本身,见 cache MESI 一致性协议 与 store buffer 与写合并。
| 触发源 | 代表性 PMU 事件 | 典型代码模式 | 修法 |
|---|---|---|---|
| 消歧违例和 4K 别名 | LD_BLOCKS_PARTIAL.ADDRESS_ALIAS | 两个结构体页内偏移雷同 | 布局错开加 padding |
| 转发失败 | LD_BLOCKS.STORE_FORWARD | 写窄读宽或跨 store 读 | 宽窄对齐一次写全 |
| store 未就绪 | LD_BLOCKS.NO_SR | store 后紧跟依赖 load | 拉长 store 到 load 间距 |
| bank 冲突 | L1D 相关事件 | 同周期多访存撞 bank | 访问模式交错调整 |
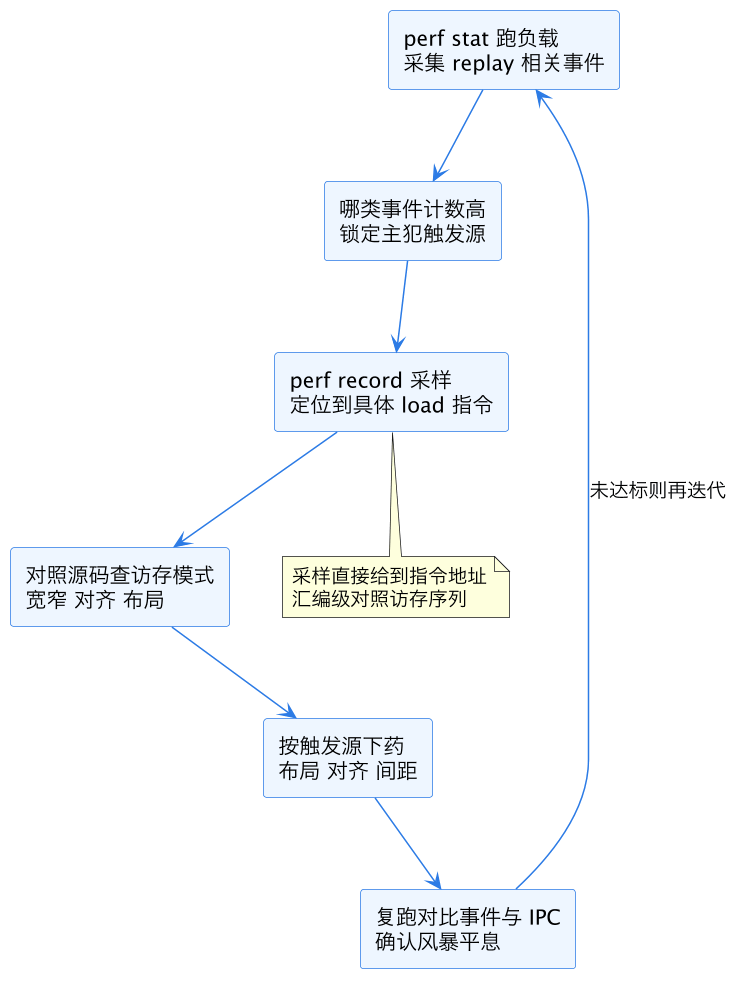
上图是完整的排查闭环。值得强调的是最后那条回头边:replay 类问题必须「改完复测事件计数」,因为布局调整可能把 4K 别名从一个变量对转移到另一个变量对——症状搬家而不是消失,只有计数器说了算。
这一篇在知识体系里的位置
本篇是微架构模块「访存执行线」的恢复机制专题。上游两篇直接铺垫:load store queue 访存消歧(load 为什么敢提前发射)与 store to load forwarding 存储转发(数据没进缓存时怎么救场,以及救场失败的边界)。同线相邻的机制是 内存依赖预测 与 缓存 bank 冲突;恢复机制的兄弟篇是分支侧的 重命名检查点与分支恢复 和 精确异常与流水线冲刷。观测手段见 PMU 性能计数器编程,瓶颈定位方法论见 Top-down 分析方法 与 IPC 瓶颈定位。全景地图见 CPU 微架构总览。
总结
load replay 是乱序核在 load 数据未就绪或访存违例时的局部恢复机制:只作废 load 及其依赖链、从发射级重来,单次代价仅 5 到 12 周期、远轻于分支冲刷;它由五类触发源引发——memory disambiguation 违例与 4K 别名、store to load forwarding 失败、L1 bank 与端口冲突、数据就绪时序误判、跨行拆分——前两类由代码访存模式决定、在热循环里稳定复现,是 replay 风暴的主力;风暴通过「replay 自身重发射加下游取消重发」双重挤占有限发射槽,可把 IPC 拖低 10% 到 30% 且在常规 profile 里隐形,唯有 LD_BLOCKS.* 系列 PMU 事件能指认主犯,再按布局错开、宽窄对齐、拉长 store 到 load 间距三味药对症根除。