Top-down 分析:frontend/backend bound 四层分解与瓶颈定位流程全解
更新时间:2026-10-02。 IPC 瓶颈分析 那篇给过一个判断框架:IPC 低只是症状,病灶可能在取指、译码、发射、执行、访存任何一环。问题是,拿到一串 IPC 数字之后,下一步往哪查?直觉做法是把几百个 PMU 事件挨个看一遍,很快淹没在数据里。Intel 的 Ahmad Yasin 在 2014 年提出的 Top-down 分析(自顶向下微架构分析方法,Top-down Microarchitecture Analysis Method,简称 TMAM)就是治这个病的:不从事件出发,而从「流水线槽位去哪了」出发,先分四大桶,再逐层下钻,每一层只用少数几个计数器就能把怀疑范围砍掉四分之三。它是现代性能分析里最值得先学会的一套方法论,PMU 硬件基础见 PMU 性能监控单元,计数器怎么读见 perf stat 硬件计数器。
本文要回答的问题
- Top-down 分析为什么用「流水线槽位」而不是「时钟周期」做分解的基本单位?
- 第一层的 frontend bound、bad speculation、retiring、backend bound 四个桶各自是什么意思、怎么算出来的?
- 判定「哪个桶是瓶颈」的阈值经验值是多少,为什么 retiring 高也可能是问题?
- 第二层往下怎么下钻,frontend bound 和 backend bound 各自拆成哪些子项?
- 在没有自顶向下事件的老机器上,如何用通用计数器近似实现这套分解?
一、为什么需要 Top-down:PMU 事件的「翻译困境」
现代处理器的 PMU 能数几百种事件:L1 缺失、分支误预测、译码气泡、发射端口占用、TLB walk……每个事件都如实记录,但没有一个事件直接回答「我的程序慢在哪」。这是性能分析里的翻译困境:硬件给你的词汇是「事件」,你想要的答案是「瓶颈」,中间缺一层系统的归因框架。
没有框架时,分析者容易犯两个典型错误。一个是「看到什么高就信什么」:某次采样里 branch-misses 绝对值很高,就断定是分支问题,结果花两周优化分支,IPC 纹丝不动——因为误预测虽然次数多,占总执行时间的比例其实很小。另一个是「平均主义」:把所有事件都采集一遍画成大表,每个都解释两句,最后没有结论。两种错法共同的根因是缺少一个统一的分母:这个事件造成的损失,占程序总可用执行资源的百分之几?
Top-down 分析的第一步就是确立这个分母。它选的不是时钟周期,而是流水线槽位(pipeline slot):一条微指令(uop)从取指到退休要经过的每一个「发射机会」。一个 4 发射(4-wide)的核,每个周期提供 4 个槽位;跑 N 个周期,总槽位就是 4N。每个槽位的命运只有四种:装着一个最终正常退休的 uop、装着一个后来被证明走在错误路径上被取消的 uop、因为前端喂不上料而空转、因为后端堵住了而被迫空置。四种命运两两互斥、合起来穷尽所有槽位——这就天然构成了一棵可以 100% 分解的树,每个槽位都算一次且只算一次,没有遗漏也没有重复计数。这个「互斥且穷尽」的性质,是整套方法论的数学地基。
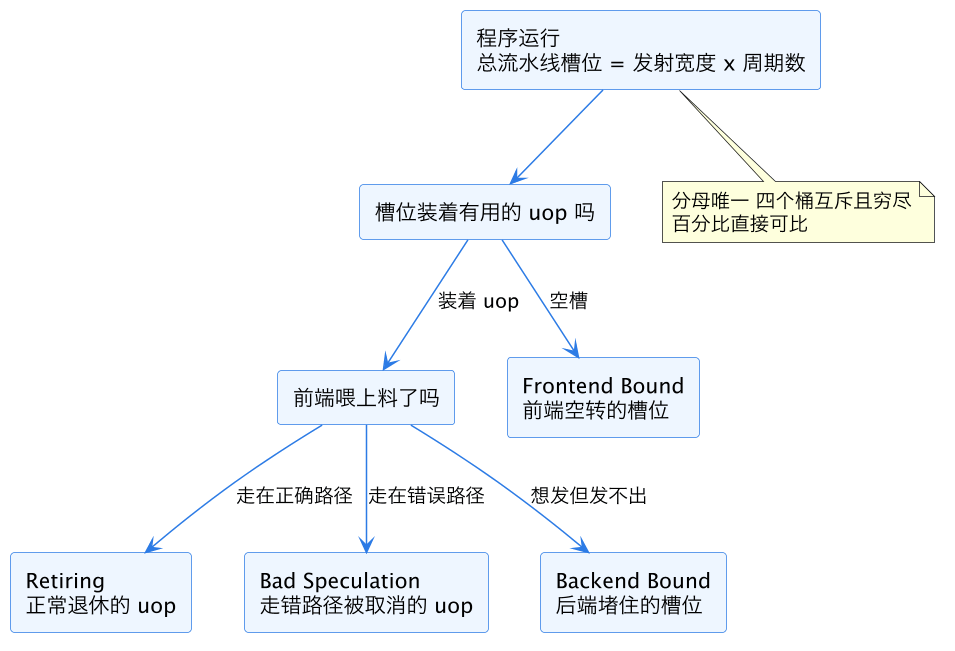
上图是第一层分解的逻辑结构。注意它的判定顺序:先问「这个槽位有没有被 uop 占用」,没占用的是 frontend bound(不是前端一定有病,而是「空槽的责任先记在前端头上」,后面会修正);占用了再问「这个 uop 最后退休了吗」,退休了是 retiring,被取消是 bad speculation;占用了、也想发射、但发射口拒收的,是 backend bound。四个桶加起来恒等于 100%,所以任何一个桶的百分比都可以直接和别的程序、别的机器对比——这正是 Top-down 分析相对裸事件计数的核心优势。
二、四个桶的语义与计算公式
把四个桶逐个展开,每个都对应一类明确的微架构病灶。
Retiring(退休占比)是「有效功」:槽位里的 uop 走完了全流程、在 ROB 里按序提交, Architectural 状态被真实更新。这个桶越高越好,但「高」的及格线因负载而异:高 IPC 的向量计算能到 70-80%,而访存密集的数据库负载可能 30% 就算健康。反直觉的一点是 retiring 高也可能是病——如果退休的全是没必要的 uop(比如能用一条 SIMD 指令干完的活用了八条标量指令),retiring 越高说明效率越低。所以 Top-down 分析里 retiring 超标本身是一个下钻方向,查「微指令效率」。
Bad speculation(错误投机占比)是被浪费的功:分支预测器猜错了方向,或者 内存依赖预测 猜错了 load 与 store 的先后关系,错误路径上取来、译码、发射的所有 uop 最后全部被清空。这些槽位装过 uop、消耗过功耗,但没有产生任何有效功。它和分支预测的关系最紧密,机制见 分支预测 与 TAGE 分支预测器。
Frontend bound(前端受限占比)是「饿死的」:后端明明吃得下,前端却没能把 uop 送进流水线。病因集中在取指与译码链路:取指分支气泡(见 取指阶段的 taken 分支气泡)、指令缓存缺失、ITLB 缺失、x86 复杂长度译码器的吞吐限制(见 x86 指令长度译码器)、uop cache 未命中走传统译码路径(见 uop cache 与传统译码前端)。
Backend bound(后端受限占比)是「堵死的」:uop 已经到了发射口,但执行资源或数据没就位,发射口拒收。这一桶再往下分两支:memory bound(等数据,各级缓存与 DRAM 延迟链条)和 core bound(等执行单元或依赖链,如端口争用,见 执行端口争用、除法器占用、长依赖链)。绝大多数访存密集的服务器程序,最后都落在这个桶的 memory bound 分支里。
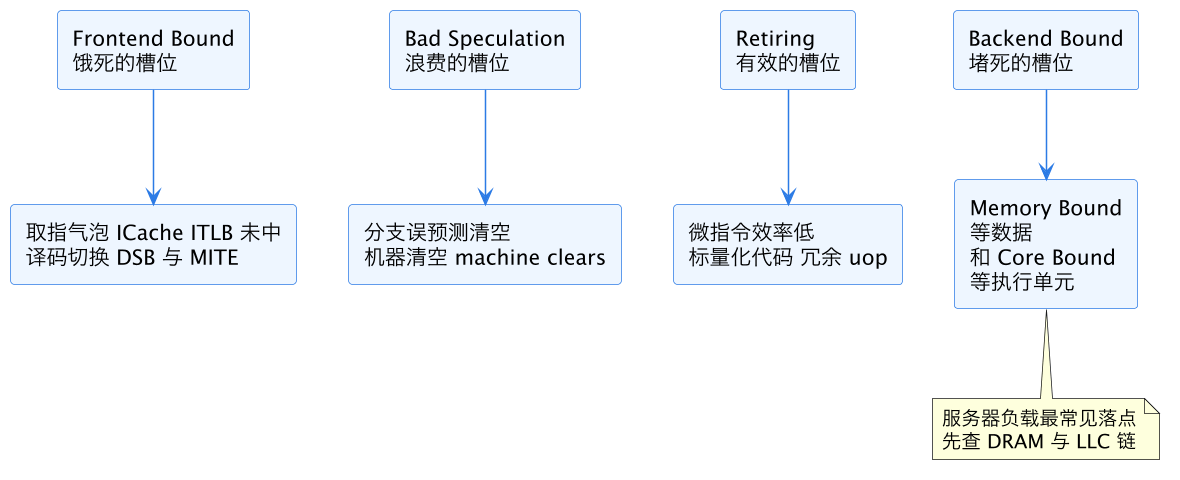
上图把四个桶各自的典型病灶标出来,这就是第二层下钻的地图。在 Intel 自 Sandy Bridge 起的实现里,这些桶不再是事后估算,而是由专用 PMU 事件直接计数:内核跟踪每个槽位的状态转换,事件名叫 topdown.fe_bound、topdown.be_bound、topdown.bad_spec、topdown.retiring 这一类。计算公式本身也值得一记,因为它们定义了「占比」的精确定义:
| 桶 | 计算口径 | 判读阈值(经验值) |
|---|---|---|
| Frontend bound | 前端未发射槽位 / 总槽位 | 超过 15% 值得下钻 |
| Bad speculation | (发射的 uop 减退休的 uop 加恢复补偿)/ 总槽位 | 超过 10% 值得下钻 |
| Retiring | 退休 uop 数 / 总槽位 | 视负载,30% 以下偏低 |
| Backend bound | 1 减前三项(发射口拒收周期折算) | 超过 20% 值得下钻 |
阈值只是初筛参考,不是判决标准。真正的判据是「这个桶的占比乘上它的可优化空间」:一个 40% 的 backend bound 如果是 DRAM 延迟造成的,优化空间可能很大;一个 20% 的 frontend bound 如果来自代码体积本身,压起来可能事倍功半。
三、下钻实战:从四大桶到具体事件
Top-down 分析的使用节奏是固定的:先跑第一层看四个桶的占比,选最大的桶(且 retiring 不超过负载应有水位)下钻一层,再看子项占比,如此递归两到三层,直到落到一个可以用普通 PMU 事件确认、可以用代码改动验证的具体机制上。
frontend bound 的下钻主要看两个子项。一是 fetch latency(取指延迟型空转):前端完全没东西可发,典型原因是 ICache 或 ITLB 缺失、分支 resteer(预测器在中途改主意,前端重定向)。对应的确认事件是 icache.misses、itlb_misses.walk_completed、br_misp_retired.all_branches 与前端重定向计数。二是 fetch bandwidth(取指带宽型空转):有东西可发但喂不够宽,典型原因是传统译码器(MITE)路径的吞吐上限、长度译码器在超长指令上卡顿、DSB(uop cache)命中率低导致频繁切换路径。确认事件是 DSB 与 MITE 路径各自供应的 uop 占比。两个子项的药方完全不同:延迟型要缩小代码 footprint、排布热代码块、用 大页缓解 TLB 压力;带宽型要让热循环落进 DSB 或 循环流检测器 LSD 的容量窗口。
backend bound 的下钻先分 memory bound 与 core bound,分界事件在 Intel 实现里看执行端口争用与各类停顿的配比。memory bound 继续按「数据在哪一级」逐层下:L1 bound(同缓存行的 store-to-load forwarding 失败、bank 冲突,机制见 store-to-load forwarding)、L2 bound、L3 bound、DRAM bound(还要再分带宽饱和还是延迟受限,带宽饱和的确认事件是 uncore 的内存控制器占用率)、store bound(store buffer 满,见 store buffer 与写合并)。core bound 则看 divider 占用、端口争用分布、以及长依赖链造成的发射空窗。SMT 场景还有一层特殊判读:开超线程时 backend bound 高但单线程资源没满,可能是兄弟线程互相挤占,参考 SMT 同时多线程 的资源分区表。
bad speculation 的下钻最直接:绝大多数是分支误预测,用 br_misp_retired 按类型拆(条件分支、间接分支、返回),间接分支高就去查虚函数表派发与函数指针热路径;少数是 machine clears(内存序机器清空、自修改代码清空等),各有专用计数器。
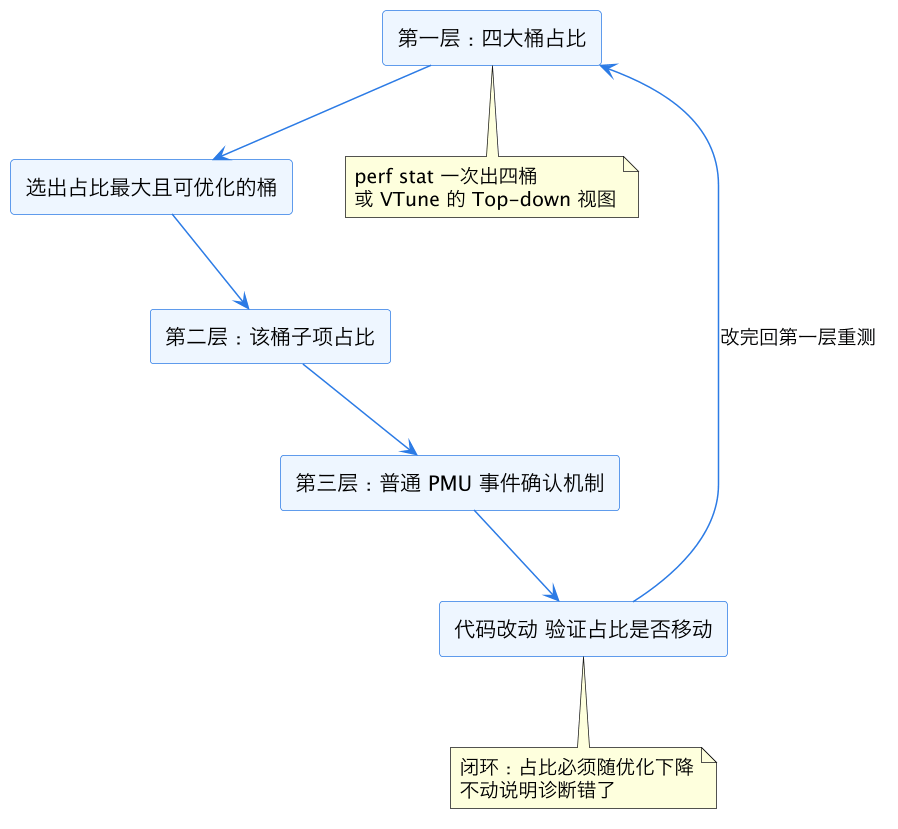
上图是整个实操闭环。最后那条回边最容易被忽略也最重要:Top-down 分析不是一次性的体检,而是迭代协议。每次优化完回到第一层重测,看目标桶的占比是否真的下降、retiring 是否真的上升。占比不动只有两种解释——诊断错了,或者改动没作用在热点路径上。这个闭环把性能优化从「靠感觉改代码」变成「假设、验证、再假设」的科学流程,和火焰图定位热点(见 perf record 与火焰图)是互补关系:火焰图回答「时间花在哪段代码」,Top-down 回答「这段代码为什么慢」,两者接起来才是完整链路。
四、没有自顶向下事件时:公式近似与工具链
专用 topdown 事件要 Sandy Bridge 之后的 Intel 核才有(而且是 Ice Lake 之后才真正固化成每一层都有硬件事件),AMD 在 Zen4 起提供了类似能力,ARM 与 RISC-V 生态多数还没有。在老机器或异构平台上,这套方法论照样能用,只是要自己用通用事件套公式。经典的手工近似公式是:总槽位 = 4 乘 cpu_clk_unhalted.thread(宽度按微架构调整);frontend bound 近似为 idq_uops_not_delivered.core 与总槽位之比;retiring 是 uops_retired.retire_slots 与总槽位之比;bad speculation 用「发射的 uop 减退休的 uop 再加上误预测恢复期间被占用的发射机会」估算;backend bound 用 1 减去前三项兜底。每一项都有对应的原始事件名,perf list 里能查到,工具用法见 perf 命令总览。
更省事的路径是直接用现成实现。perf 从较新版本开始支持 --topdown 选项,在支持的硬件上一次 perf stat --topdown 直接打印各层占比;Intel VTune 的 Microarchitecture Exploration 模式就是这套方法论的图形化完整版,每一层都能点进去看子项和对应源码行;开源侧还有 andikleen 的 pmu-tools,里面的 toplev 脚本把整棵分解树(到第三、第四层共几十个子项)全部实现成可跑的命令行工具,还能按进程、按函数粒度拆分占比。方法论是一样的,差别只在自动化程度。
用这套方法时有三个常见坑值得提前知道。第一,占比是按 CPU 周期归一的,如果程序大量时间在等锁、等 IO(线程根本没在跑),Top-down 看到的只是「在跑的那部分」的画像,要先确认 cpu_clk_unhalted 和墙钟时间的比例,别把调度问题误诊成微架构问题。第二,多线程程序的占比要分线程看,聚合平均值会把「一半线程 frontend bound、一半线程 backend bound」平均成「都不严重」,掩盖真实病灶。第三,不同代的公式宽度常数不同(4 发射、6 发射、8 发射),手工算之前先确认微架构,参数不清楚时查 CPU 微架构总览 里各代核的发射宽度演进。
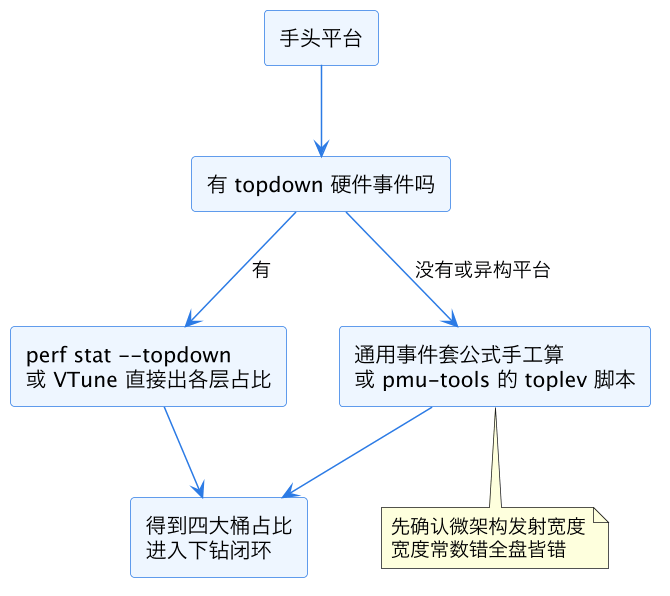
上图是工具选型决策。两条路终点相同,区别只在中间是硬件帮你记账还是软件帮你记账。掌握手工公式的价值在于:即使日常用自动工具,理解每个数字背后的原始事件,才能在工具输出可疑时(比如虚拟化环境里计数器被宿主动过手脚)识破并退回到原始事件自己验证。
这一篇在知识体系里的位置
本篇是微架构模块里「分析方法」线的枢纽篇,把散落在各模块文里的机制串成一套可执行的定位流程。动机上游是 IPC 瓶颈分析,硬件底座是 PMU 性能监控单元;frontend bound 下钻到的前端链路见 uop cache 与传统译码前端、x86 指令长度译码器、取指阶段的 taken 分支气泡;bad speculation 的机制见 分支预测 与 TAGE 分支预测器;backend bound 的子项见 执行端口争用、store buffer 与写合并、store-to-load forwarding、大页缓解 TLB 压力。工具侧的组合拳是 perf stat 硬件计数器 出占比、perf record 与火焰图 定热点;整机视角的入口见 系统诊断工具 与 微架构总目录。
总结
Top-down 分析把程序占用的全部流水线槽位按「互斥且穷尽」的原则分成 frontend bound、bad speculation、retiring、backend bound 四个桶,每个桶一个百分比、直接可比,然后沿分解树逐层下钻到具体微架构事件,优化后回到第一层重测占比形成闭环——它把性能分析从「在几百个 PMU 事件里碰运气」变成一套有分母、有阈值、有验证协议的标准流程,是现代处理器上定位「程序为什么慢」的第一把钥匙。