功耗病毒与 AVX offset:高功耗指令触发的降频机制全解
更新时间:2026-10-06。「这台机器标称 3.0GHz,怎么一跑 AVX-512 就掉到 2.3GHz?」——这是性能剖析现场的经典疑问,答案就是 AVX offset 机制。现代 x86 CPU 内置了一套工作负载分类器:发现核里在跑重向量指令,就主动把频率降一档甚至几档,把功耗和温度拉回安全区。而功耗病毒(power virus)则是人为构造的极端负载,专门用来把这套保护机制逼到墙角,验证供电和散热的极限。两者是同一枚硬币的两面:一个是硬件的自我防卫,一个是工程师的压力测试。本篇把机制、触发条件、恢复延迟和调优手段一次讲清,读完后你应能解释手头机器上任何一次「频率莫名掉了」的事件,上游背景见 CPU 电源与频率管理,相邻话题见 AVX10 融合向量 ISA 和 微架构时钟与功耗门控。
本文要回答的问题
- 为什么跑 AVX2/AVX-512 会降频,硬件是怎么「发现」你在跑重负载的?
- license 分档具体怎么分,各档 offset 多少,为什么高核数 SKU 降得更狠?
- 降频和恢复各有多快,对混合负载的毛刺影响有多大?
- 功耗病毒是什么,为什么烧机要用它,构造它有什么讲究?
一、为什么会有 AVX offset:功耗墙的硬约束
CPU 的频率不是想跑多高就跑多高,它被三面墙夹着:功耗(TDP 与瞬时电流限制)、温度(结温上限)、供电(主板的 VR 能稳定供多少电)。标量整数代码的功耗密度其实不高,真正耗电的是宽向量单元:一个 512 位的 FMA(乘加)单元每周期吞吐的数据量是标量的 16 倍,晶体管翻转数量随之暴涨。同样 3.0GHz,跑满 AVX-512 FMA 的核功耗可以是跑整数代码的两倍以上。
Intel 从 Haswell(AVX2 时代)开始引入分档频率机制:既然重向量负载必然要撞功耗墙,不如提前把频率降下来,让芯片稳在可持续的工作点上,而不是撞墙后被动 throttling 来回震荡。这个设计哲学叫「主动降频优于被动撞墙」——被动 throttling 的响应慢、震荡大,主动 offset 换来的是可预期的稳态性能。AMD 后来的 Zen 系列也有类似的功耗感知频率调整,只是不暴露「offset」这个旋钮,行为更连续、不分档。这套机制在 Intel 规格书里叫 AVX2/AVX-512 license 或 offset,在 BIOS 里常能配置,在 Linux 下可通过 MSR 观测。
还有个历史细节值得知道:早期(Skylake-SP)的 AVX-512 降频非常狠,全核 512 位负载能比标称频率低 30% 以上,以至于当时不少团队编译选项里主动 -mno-avx512f,宁可跑 AVX2。这个「AVX-512 恐惧症」影响了之后很多年的工程决策,包括 AVX10 融合向量 ISA 把 512 位做成可选项、强调 256 位与 512 位同构执行的设计,某种意义上就是对这段历史的回应——ISA 演进不光看吞吐,还要看功耗政治。
二、license 分档:硬件如何给负载分级
核心思想是按「指令重量」和「执行宽度」两个维度把负载分档。以 Intel Skylake-SP 及之后的服务器核为例,大致分三档:
| license 档 | 典型指令 | 频率行为 |
|---|---|---|
| L0(标量/轻向量) | 整数、标量浮点、128 位向量、轻量 256 位 | 跑标称 turbo,无 offset |
| L1(AVX2 重负载) | 256 位 FMA、256 位整数乘法等重 256 位指令 | 应用 AVX2 offset,降 1-3 档 |
| L2(AVX-512 重负载) | 512 位 FMA 等重 512 位指令 | 应用 AVX-512 offset,降更多档 |
「重」的判据是指令的能量特征:FMA、乘法这类打开整个向量单元全宽数据通路的指令算重,而 256/512 位的 load/store、shuffle、布尔逻辑算轻——轻指令即使宽度够也不触发降档。这个区分很重要:一条拷贝内存的 AVX-512 循环(vmovdqu64 为主)通常留在 L0,而一条 vfmadd 密集循环立刻进 L2。分类器是硬件里的计数逻辑:核内统计最近一段时间重指令的比例,超过阈值就申请降档,低于阈值一段时间后再申请升回来。
分档的具体 offset 值随代际和 SKU 而变:Skylake-SP 时代 AVX-512 重负载 offset 常见 4-6 个倍频(每档 100MHz),Cascade Lake 有所缓和,Ice Lake 之后明显收窄。同一代里,高核数 SKU 的 offset 通常比低核数大——核越多全核功耗余量越紧,这是「旗舰 CPU 跑 AVX-512 反而降得更狠」这个反直觉现象的根源。查自己机器的分档行为,最权威的是 turbostat 的实测而不是规格书的静态表。
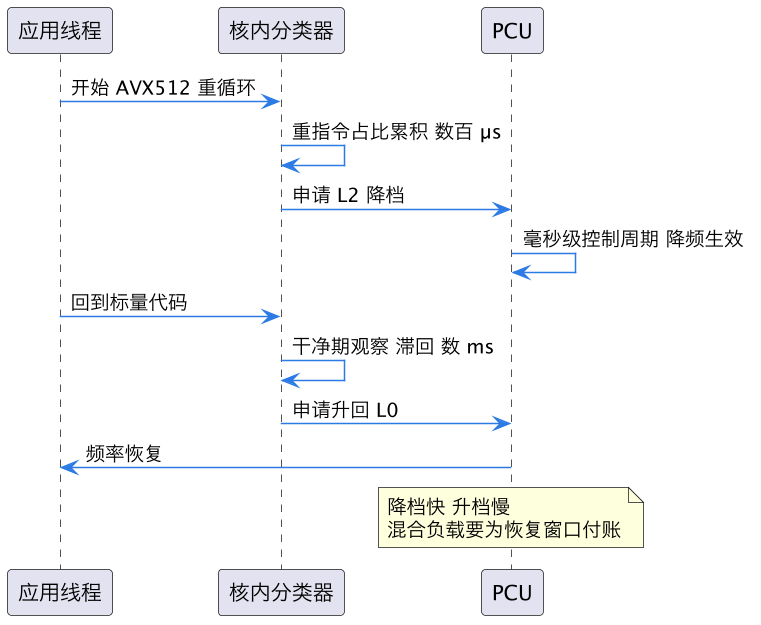
上图里最后一站 PCU(Power Control Unit,功耗控制单元)是 uncore 里的一个小微控制器,它汇总所有核的 license 申请,再叠加整包功耗、温度、电流(ICCmax)约束,算出最终全核频率。所以实际频率 = f(负载分档, 核数, 温度, 供电),规格书上那张「AVX-512 全核 turbo 表」就是这套逻辑的静态投影。
三、触发与恢复:两个不对称的时间常数
降频不是即时的,升频更慢,这两个时间常数的不对称对混合负载影响很大。
降档一侧:重指令要先在核里「积累」一小段时间(微秒量级)分类器才确认,然后 PCU 在毫秒级的控制周期里调整频率。所以从第一条重向量指令到频率真正掉下来,中间有几百微秒到几毫秒的窗口——短促的 AVX-512 突发可能根本不触发降频,这是好事,突发性能不受罚。
升档一侧:分类器要观察到足够长的「干净期」才敢升回来,这个滞回(hysteresis)是故意设计的,防止负载在两个档之间高频抖动——如果升降都快,一个每 2 毫秒在标量和向量之间切换的负载会让频率调节器空转,永远在错误的工作点上。滞回的代价转嫁给了真正混合的负载:实测恢复延迟常见在毫秒级,部分平台可到十毫秒以上。后果是:一段 1 毫秒的 AVX-512 计算,可能让后续 10 毫秒的标量代码也跟着吃降频——尾延迟毛刺的经典来源之一。对延迟敏感服务,把向量化的批处理任务和标量的在线请求混部在同一个核上,就要为这种「降频传染」留预算。
一个真实的排查场景:某在线服务 P99 延迟周期性地从 5ms 跳到 8ms,周期与一台同机部署的日志压缩任务的运行节奏吻合。压缩用了 AVX-512 优化库,每次运行把共享核拉进 L2 档,压缩结束后数毫秒内在线请求的标量代码仍在低频上跑。解决手段不是改代码,而是调度隔离——把压缩任务 taskset 到专用核,在线核的频率立刻稳定。这类问题的麻烦之处在于 perf top 里看不到任何异常:指令数没变多,只是每条指令更贵了,必须把频率时间线和负载时间线对齐才能看出因果。
观测这套行为最直接的手段是读计数器:perf stat 的 cycles 对 ref-cycles 比值能推实际频率;更精确的是 Intel 的 core_frequency 类 PMU 事件或直接看 turbostat 输出里按 license 分列的频率(turbostat 会报告 L0/L1/L2 各档的实际运行频率与时间占比)。如果发现服务的标量阶段频率被压在 AVX 档位,就是恢复延迟在收税。
四、功耗病毒:把保护机制逼到极限
功耗病毒(power virus)是专门构造的、让芯片功耗冲顶的程序,典型代表是 Prime95 的 small FFT 模式、Linpack(HPL)、以及专用的 mprime/stressapptest 配置。它们的共同点:全核同步跑最重的指令(512 位 FMA)、数据全在 L1/L2 里命中(不为内存停顿让出功耗余量)、循环体里没有任何空闲周期。这种负载下电流冲到 ICCmax 边缘,电压被拉低(droop),PCU 把频率压到 AVX-512 基频附近,散热器全速运转——芯片在最恶劣但「合法」的工况下运行。
构造一个朴素功耗病毒的内核就几行:准备两组常驻 L1 的 __m512d 数据,循环里交替执行 _mm512_fmadd_pd 累积到多个独立累加器(至少要拉开 FMA 延迟链,四到八个累加器才能让流水线饱和),编译时确保不被优化掉。烧机测试的意义在于验证三件事:供电设计是否在极限电流下稳住电压(否则触发更狠的 throttling 甚至掉电)、散热能否压住结温、以及整机在长时间极限功耗下是否出错(配合 ECC 与 RAS 检查,见 Machine Check 与 RAS)。

要注意功耗病毒是硬件验证工具,不是应用性能基准。它的功耗数字代表设计极限,不代表任何真实负载;反过来,如果一个服务的实测功耗逼近功耗病毒的某个百分比,说明它的向量化程度已经很高,继续优化的空间在算法而不是指令。
实际验证流程里有几个坑。其一,单核功耗病毒不等于全核功耗病毒——PCU 对全包功耗的限制意味着单核跑 FMA 可能根本不降频(余量够),只有全核同步跑才能测出真正的极限频率地板,所以烧机工具都要全核拉起。其二,功耗病毒要和错误检测配套:Prime95 的卖点就是每轮 FFT 做校验和,压不住温度的机器会先算出错误结果再死机,这比看蓝屏有信息量得多。其三,数据中心运维用功耗病毒做「上架前筛机」,把供电或散热有缺陷的机器在入网前筛掉——这是它最大的工业价值。其四,别忘了电压维度:重负载瞬间的电流变化率(di/dt)会在供电网络上砸出电压下陷(voltage droop),主板 VR 设计余量不足的机器,功耗病毒第一个暴露的就是这个。
五、对性能剖析的实际影响与对策
把机制落到工程实践,几条对策按场景分:
| 场景 | 问题 | 对策 |
|---|---|---|
| HPC/批计算 | AVX-512 全核跑频率低 | 对比 AVX2 版吞吐,部分核数/代际上 AVX2 总吞吐反而更高 |
| 在线服务 | 邻居向量化任务降频传染 | 核隔离:向量批处理绑专用核,在线核不进 L1/L2 档 |
| 基准测试 | 频率漂移导致数字不可比 | 测试前锁定频率(cpupower frequency-set),或报告频率归一化后的周期数 |
| 烧机/硬件验证 | 需要极限功耗 | Prime95/Linpack 全核跑,监控 turbostat 与 IPMI 功耗 |
| 延迟敏感 | 短向量突发无辜躺枪 | 确认突发短到不触发降档;必要时降档 offset 在 BIOS 调小 |
最后一条展开说:不少服务器 BIOS 提供 AVX offset 的可配置项(常见于「AVX2/AVX-512 Frequency Offset」或类似命名),把 offset 调小能减轻降频传染,代价是重向量负载下可能撞温度墙触发更不可控的硬件 throttling。改这个旋钮前先在目标负载下实测温度与频率曲线,没有免费的午餐。另外从 Ice Lake 开始的客户端/新服务器核,AVX-512 的功耗惩罚已经比 Skylake 时代小很多,判断要不要躲 AVX-512 必须按具体代际实测,不能拿老经验套新平台。
再补一个方法论提醒:评估任何「向量化能加速多少」的提案时,收益公式里必须扣掉降频因子。理论加速比是宽度翻倍,实际加速比是「宽度 × 降档后频率 / 原频率」,全核场景下这个修正项经常吃掉 20-40% 的账面收益。正确的实验姿势是:同一算法分别编译 AVX2 和 AVX-512 两个版本,在目标机器上以目标并发度跑真实数据集,perf stat 同时记录指令数、周期数和实际频率,用每字节周期数(cycles per byte)而不是墙钟时间做最终判据——墙钟会被邻居负载的降频传染污染,周期数不会。这也呼应了 CPU 电源与频率管理 里反复强调的一点:频率在现代 CPU 上是个因变量,任何把它当常量的性能模型都会出错。
这一篇在知识体系里的位置
本篇属于 microarch 层「功耗与频率」专题的机制核心:向上回到 CPU 电源与频率管理;横向与 微架构时钟与功耗门控(空闲时的省电半边)、AVX10 融合向量 ISA(向量 ISA 的演进方向,功耗正是驱动力之一)、SMT 同时多线程(共享核资源的功耗账)互补。可靠性验证侧衔接 Machine Check 与 RAS。
总结
AVX offset 是 CPU 应对重向量负载的内置分档降频机制:核内分类器按指令宽度与重量把负载分进 L0/L1/L2 档,PCU 据此叠加功耗温度约束定频率;降档快、升档有数毫秒滞回,混合负载要为「降频传染」付账;功耗病毒则是全核 512 位 FMA 加 L1 驻留数据构造的极限负载,与 offset 机制一体两面,用来验证供电散热的底线。