PEBS 精确事件采样:DS 区域如何消除采样偏移并画出内存访问画像
更新时间:2026-10-05。用
perf record做采样剖析时,几乎每个人都踩过同一个坑:热点报告的指令地址和真实出问题的指令「对不上」——明明是某条 cache miss 的 load 把流水线拖垮了,采样点却落在它后面几条甚至几十条指令上。这不是 perf 的 bug,而是普通 PMU(Performance Monitoring Unit,性能监控单元)中断采样的物理宿命:计数器溢出到 CPU 真正响应中断之间,流水线还在往前跑,等内核读到 RIP 时,现场早就漂移了,这段漂移叫 skid(采样偏移)。Intel 从 Core 微架构开始给出的解法是 PEBS(Precise Event Based Sampling,精确事件采样):不等中断,由硬件在事件触发的瞬间把指令指针和寄存器现场直接写进内存里的一块 DS 区域。PMU 计数器编程的基础见 PMU 性能计数器编程,采样数据如何喂给方法论见 Top-down 分析方法。
本文要回答的问题
- 普通 PMU 中断采样为什么一定有 skid?漂移量能有多大?
- PEBS 的 DS(Debug Store)区域是什么?硬件往里面写了什么?
- PEBS 凭什么叫「精确」?skid 真的能压到零吗?
- PEBS 记录的访存地址和延迟信息如何构成内存访问画像?
- perf 里怎么开 PEBS?
:p/:pp/:ppp修饰符各是什么意思?
一、普通 PMU 采样的 skid 问题:中断永远迟到
先看普通采样的工作流程。PMU 计数器配置成「每 N 次事件溢出一次」:比如 cycles 事件采样周期设 100 万,计数器倒数到 0 触发 PMU 中断,内核中断处理程序读出当时的 RIP(指令指针)和各种寄存器,写成一条采样记录。整个链条里有一个无法消除的时间窗:从计数器溢出,到中断被 CPU 响应、现场被冻结,中间隔着中断投递延迟、流水线排空、微码辅助流程,动辄几十到几百个周期。
问题是现代超标量处理器在这几十周期里能退休几十甚至上百条指令。等内核读到 RIP 时,它指向的是「中断被处理那一刻」流水线里的某条指令,而不是「真正造成事件计数的那条指令」。后果有三层:
- 热点指令错位:某条 load 造成 L3 miss,采样点却记在 5 条指令之后的
add上,annotate 出来的汇编热点满篇「冤案」。 - 热点函数错位:skid 大到跨越函数边界时(内联展开、短函数接连排列),采样会记到隔壁函数头上。
- 事件归因失真:对
br_misp_retired这类事件,错位的 RIP 让你根本找不到是哪条分支在误预测。
一个真实感更强的例子:某 JSON 解析服务的 perf annotate 显示热点集中在一条无辜的 mov %rax,%rbx 上,占 40% 样本,而紧邻它的 cmp 和内存访问指令却「干净」得反常。有经验的剖析者看到这种「热点落在不耗能指令上」的模式就该警觉——这是 skid 的典型指纹:真正昂贵的是前面那条触发 cache miss 的 load,样本被整体后移,记账记到了流水线里恰好排在中断时刻的指令头上。新手则容易被带进沟里,去优化那条 mov,结果一无所获。
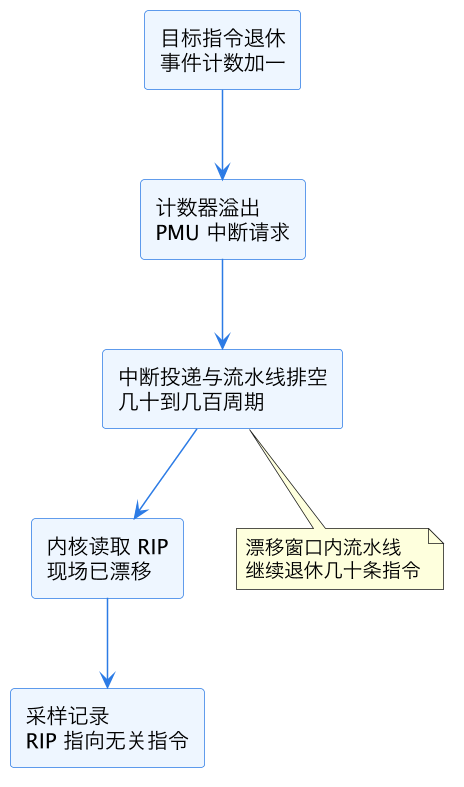
上图是普通采样的漂移链。漂移不是固定值——它随微架构、事件类型、当时的流水线拥堵程度浮动,所以也不能靠「软件统一往回扣几条指令」来补偿。某些事件(如 INST_RETIRED)在部分微架构上被定义成「精确事件」,中断由硬件辅助延迟到指令边界,但覆盖面很窄,绝大多数事件仍然带 skid。
二、PEBS 的硬件机理:DS 区域与硬件直写
PEBS 换了一个根本思路:既然「等中断再读现场」必然漂移,那就不要中断——事件触发的瞬间,由硬件自己把现场写进内存。
这套机制的载体是 DS(Debug Store,调试存储)区域:一块由软件提前分配、通过 MSR 登记给 CPU 的内存区,里面包含管理结构和 PEBS 记录缓冲区。工作流程如下:
- 软件在 DS 管理区(BTS/PEBS buffer management area)里填好缓冲区的基址、大小、阈值(threshold)和索引。
- 硬件监控到 PEBS 使能的计数器溢出时,由微码或专用硬件把「触发指令」的现场打包成一条 PEBS 记录,直接写入缓冲区当前索引位置,索引前移。
- 缓冲区写到阈值水位时,才触发一次 PMI(PMU 中断)或协助(assist),内核一次性把攒下的一批记录取走、重置索引。
关键差异在于第 2 步:写记录的是硬件,时机紧贴触发指令退休,而不是几十周期后的中断处理。每条 PEBS 记录是一个固定布局的结构体,基础字段包括:
| 字段组 | 内容 | 用途 |
|---|---|---|
| 通用寄存器 | RIP、RAX、RBX、RSP、FLAGS 等 | 精确定位触发指令与上下文 |
| 事件信息 | EventingIP(触发指令的 IP) | 替代被 skid 污染的中断 RIP |
| 访存扩展(PEBS v2+) | Data Linear Address | 触发 load/store 访问的线性地址 |
| 延迟与数据源 | Data Source Encoding、Latency | 命中层级、是否跨核/跨 NUMA、停顿周期数 |
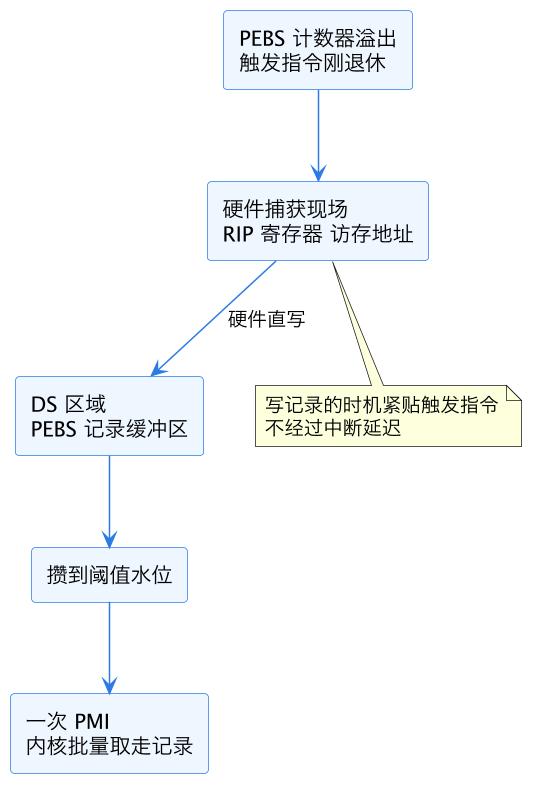
上图是 PEBS 的数据通路。和普通采样相比,「每次溢出一次中断」变成「每次溢出一次硬件内存写」,中断频率从每样本一次降到每缓冲批次一次——附带收益是采样开销本身也大幅下降,高频采样(短周期)下的扰动明显小于中断方案。
DS 区域本身也是一段值得记住的历史遗产:它最早在 Pentium 4 时代为 BTS(Branch Trace Store,分支轨迹存储)设计,用来把分支记录直接倒进内存;PEBS 复用了同一套缓冲管理机制,所以你在 Intel SDM 里会看到 PEBS 的初始化和 BTS 共用 IA32_DS_AREA MSR。从 NetBurst 到 Core、Nehalem、Sandy Bridge,再到近年的 Icelake、Sapphire Rapids,PEBS 记录格式一路扩容:v1 只有寄存器现场,v2 加了访存地址,v3 补齐了延迟与更细的数据源编码,Sapphire Rapids 的 v5 还把 TSX 中止原因、更多辅助标志也塞了进去。内核 perf 子系统按 CPU 型号解析不同版本的记录布局,用户态基本无感。
还有一个不常被提起的细节:PEBS 写 DS 缓冲区走的是普通的内存写路径,意味着它会占用 load/store 单元和缓存带宽,且 DS 页必须常驻(被换出会直接出错)。所以 DS 缓冲一般按每 CPU 几十 KB 到几百 KB 的量级分配、用锁定内存承载,perf 在 mmap 环形缓冲之上又包了一层搬运逻辑。
三、「精确」到底精确在哪:EventingIP 与 skid 消除
PEBS 的精确性核心是一个概念:EventingIP。普通采样记录的是「中断响应时的 IP」,PEBS 记录的是「造成事件的那条指令的 IP」——硬件在写记录时回填的是触发指令本身的地址。
但要注意两个工程现实,避免把 PEBS 神化:
- PEBS 不是零 skid,是「 skid 压到指令粒度」。硬件写记录仍然发生在触发指令退休之后的一小段微码流程里,但记录的 IP 由硬件保证指向触发指令,而不是任意漂移后的流水线位置。社区一般说 PEBS 的 skid 为 0 到 1 条指令,对比普通采样动辄几十条,精度是两个数量级的提升。
- 只有被标记为 PEBS-capable 的事件才能用。不是随便哪个 PMU 事件都支持 PEBS,每个微架构的 PEBS 事件列表写在 Intel SDM 的表格里,常见的有
INST_RETIRED、BR_MISP_RETIRED、MEM_UOPS_RETIRED系列、前端停顿事件等。用perf list看到的xxx:p可修饰事件,就是这颗 CPU 上 PEBS 可用的集合。
普通采样与 PEBS 采样的精度对比如下:
| 维度 | 普通 PMU 中断采样 | PEBS 精确采样 |
|---|---|---|
| 记录 IP 来源 | 中断响应时的流水线 RIP | 硬件回填的 EventingIP |
| skid 量级 | 几十到几百周期、几十条指令 | 0 到 1 条指令 |
| 每样本成本 | 一次中断加内核现场保存 | 一次硬件内存写 |
| 附加信息 | 仅寄存器现场 | 访存地址、延迟、数据源 |
| 可用事件 | 几乎全部 PMU 事件 | 仅 PEBS-capable 事件子集 |
这张表解释了实际工作中的取舍:要「什么事件都能采」用普通采样,要「指令级精确归因」用 PEBS,两者不是替代关系而是互补。做 Top-down 分解时用普通采样收集各层级计数(方法见 Top-down 分析方法),锁定「Memory Bound 由哪条 load 造成」时再上 PEBS。
判定手头机器的 skid 是否严重有个土办法:同一个负载,分别用 cycles 和 cycles:pp 各采一次,对比 annotate 的热点分布。如果前者热点发散、大片样本落在相邻指令上,后者收成清晰的山峰,说明普通采样的漂移已经足以误导结论;如果两者分布几乎一致,说明该负载的热点粒度本来就很粗(比如一个大循环体均匀发热),skid 不影响决策。这个对照实验五分钟就能做完,比背理论更有说服力。
四、内存访问画像:Data Address、Latency 与 Data Source
PEBS 最值钱的能力不是修 skid,而是从 Nehalem 之后逐步扩展出的访存记录——对触发事件的 load/store,硬件顺手把这次访存的完整画像写进记录:
- Data Linear Address:这次访问的线性地址。有了它,就能把「哪条指令热」升级成「哪个数据结构、哪段内存热」,配合页表甚至能还原到变量级。
- Data Source Encoding:这次访存命中了哪一级——L1、L2、L3、本地 DRAM、远端 NUMA 节点、还是另一个核的缓存(HITM)。这是定位伪共享(false sharing)和 NUMA 远程访问的直接证据。
- Latency:从 load 发射到数据就绪的周期数(MEM_LOAD_RETIRED 类事件可配最小延迟阈值,比如只记录延迟超过 30 周期的访问,过滤掉 L1/L2 命中的噪音)。
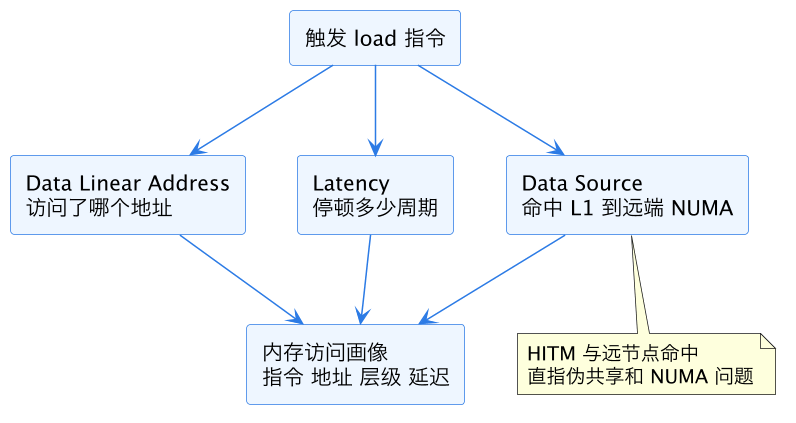
上图是内存画像的三个维度如何拼成完整证据链。一个典型实战场景:某多线程服务 p99 延迟抖动,普通采样只能告诉你「某函数很热」,开 PEBS 的 mem-loads 采样后,Data Source 字段直接显示大量样本命中「remote socket DRAM」,Latency 集中在 200 周期以上——远程 NUMA 访问实锤,修复方向从「优化代码」立刻转向「绑核加本地分配」。伪共享场景同理:不同核反复 HITM 同一缓存行,地址字段聚类在同一个 64 字节对齐区间,病灶一目了然。
perf mem 子命令把这套画像做成了一等公民:perf mem record 等价于同时对 load 和 store 开 PEBS 采样,perf mem report 则按数据源分层汇总(Local RAM、Remote Cache、LFB 命中等),并按符号和地址聚合。配合 perf c2c(cache-to-cache 分析,底层同样吃 PEBS 的地址与数据源字段),还能直接列出「哪些缓存行被哪些核反复争抢」,这是目前定位伪共享最锋利的开源工具链。
延迟阈值(ldlat)是个容易被低估的旋钮。默认不设阈值时,大量 L1 命中(4 到 5 周期)的样本会淹没真正昂贵的访问;把阈值设到 30 周期以上,基本等价于「只记录 L2 miss 及更慢的访问」,样本量骤减、信号骤纯。代价是引入了偏置——你看到的分布不再代表全部访存,而只代表慢访问的分布,解读报告时心里要有这根弦。
五、perf 实战::p 修饰符、PEBS 事件与 perf mem
Linux perf 对 PEBS 的暴露方式是事件修饰符:在事件名后加 :p 表示启用 PEBS,p 的个数表示精度级别——
:p:请求精确采样,允许内核在无 PEBS 时回退;:pp:请求 skid 尽可能小(PEBS 可用时启用);:ppp:要求 skid 必须为 0,硬件不支持则失败。
常用命令组合:
# 指令级精确的热点采样(cycles 事件走 PEBS)
perf record -e cycles:pp -g ./app

# 只记录延迟超过 50 周期的 load,含访存画像
perf record -e cpu/mem-loads,ldlat=50/pp ./app
perf mem report          # 按数据源层级汇总画像

# 看采样落在汇编哪一行(PEBS 下 annotate 不再冤枉邻居指令)
perf annotate --no-source
PMU 计数器与事件的底层配置方法(/proc/sys/kernel/perf_event_paranoid、MSR 编程模型)见 PMU 性能计数器编程,这里只强调 PEBS 特有的注意点:
- PEBS 采样要独占 PMU 资源,
perf record用了 PEBS 的事件组里不要再混排普通事件,否则调度器可能整组失败。 - DS 缓冲区在内核里是每 CPU 的映射,高频采样时注意
perf.data体积膨胀——PEBS 记录比普通样本大得多(几十到上百字节一条)。 - 虚拟化环境里 PEBS 依赖宿主机透传,云上部分实例类型不可用,
perf record -e cycles:ppp直接报错就是信号。
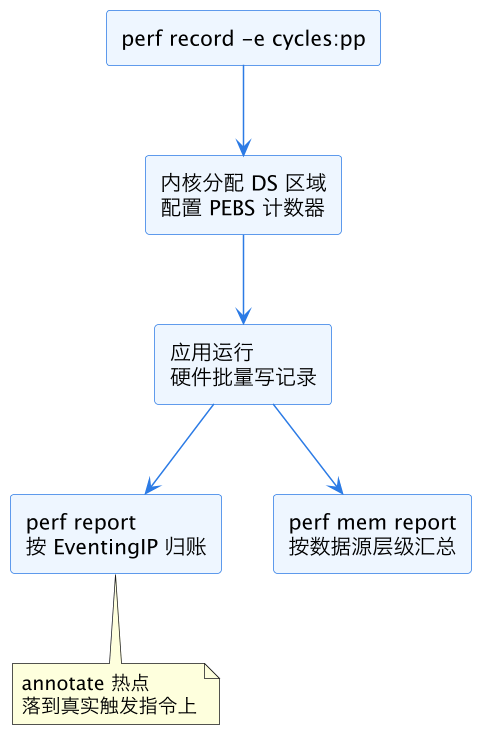
上图是 perf 使用 PEBS 的完整链路:从命令行修饰符到内核 DS 配置,再到两条消费路径——perf report 按精确 IP 归账解决「是谁」,perf mem report 按数据源汇总解决「卡在哪一级」。
这一篇在知识体系里的位置
本篇是微架构模块「观测方法线」的精度篇,归宿于 /concepts/microarch/。上游基础是 PMU 性能计数器编程——计数器、MSR、事件选择的概念都在那里;PEBS 采到的精确数据是 Top-down 分析方法 里 Memory Bound 归因的证据来源。微架构全景见 CPU 微架构总览;采样数据的可视化与火焰图消费属于工具线,见 perf 工具文档。
总结
PEBS 精确事件采样把「中断响应时读 RIP」改成「事件触发瞬间由硬件把现场直写 DS 区域」:EventingIP 由硬件回填、skid 从几十条指令压到 0 到 1 条,热点归账不再冤枉邻居指令;PEBS 记录还附带访存线性地址、延迟周期与命中层级(L1 到远端 NUMA、HITM),构成直接指证伪共享与 NUMA 远程访问的内存访问画像。perf 里用 :p/:pp/:ppp 修饰符开启,配合 perf mem report 消费画像,代价是仅 PEBS-capable 事件可用且记录体积更大——普通采样管覆盖面,PEBS 管精确归因,两者互补构成完整的硬件采样观测体系。