HLT/MWAIT 空转成本:空闲循环三条路的唤醒延迟与功耗对比
承 MONITOR/MWAIT 与 TPAUSE/UMWAIT 等待指令族 对指令语义的拆解,以及 C-state/P-state 硬件功耗管理 对睡眠状态的分类。本篇把视角收窄到一个具体问题:核没事干的那几百纳秒到几毫秒里,HLT/MWAIT 空转成本到底差在哪——同样是「等」,忙等、HLT、MWAIT 的唤醒延迟能差出三个数量级。
本文要回答的问题
- HLT/MWAIT 空转成本的差异本质是什么?为什么同样空闲,功耗能从 30W 掉到 1W?
- PAUSE 忙等、HLT、MWAIT 三条路径的唤醒延迟分别是什么量级?
- 深睡(C6)省电但醒得慢,这个 trade-off 的拐点在哪?
- 对延迟敏感服务(游戏服、交易、网卡轮询),idle 循环该怎么选?
一、空闲不是免费的:三种「等」的物理本质
核没有活干时,软件有三条路:忙等(spin loop 里插 PAUSE,占着流水线空转)、HLT(halt,停机指令,让核进入 C1 睡眠直到中断到来)、MWAIT(monitor wait,先 MONITOR 布一个地址的写监视,再 MWAIT 睡到有人写这个地址或被中断)。
三者的区别不在「等不等」,而在核睡多深。忙等时流水线照跑,频率照顶,功耗接近满载;HLT 只关掉核内时钟(C1),LLC 与核外还醒着;MWAIT 可以带提示位(hint,写在 ECX 里的目标状态编码)请求进 C1E、C3、C6——C6 会把核电压降到接近零、上下文状态压进片上 SRAM,省得最狠,醒来也最贵。
先解释几个术语。PAUSE 是自旋等待提示指令,告诉流水线「我在空转,别按正常 load 流水猜测调度我」,Skylake 之后一次 PAUSE 的延迟从约 10 周期拉长到约 140 周期,本身就是一次「微型睡眠」。HLT 是停机指令,执行后核停在当前指令边界,等中断把它敲醒;因为能改特权状态,它是 ring 0 专属。MWAIT 必须和 MONITOR 成对用:MONITOR 在缓存一致性协议里挂一个「武装位」,盯着一个地址(实际是一条 cache line)的写事件;MWAIT 睡下后,任何核写这条 line,一致性流量就会触发唤醒——这是它能用来做「核间事件通知」的原因,比如内核的 idle 循环和用户态的 UMWAIT 定时等待。
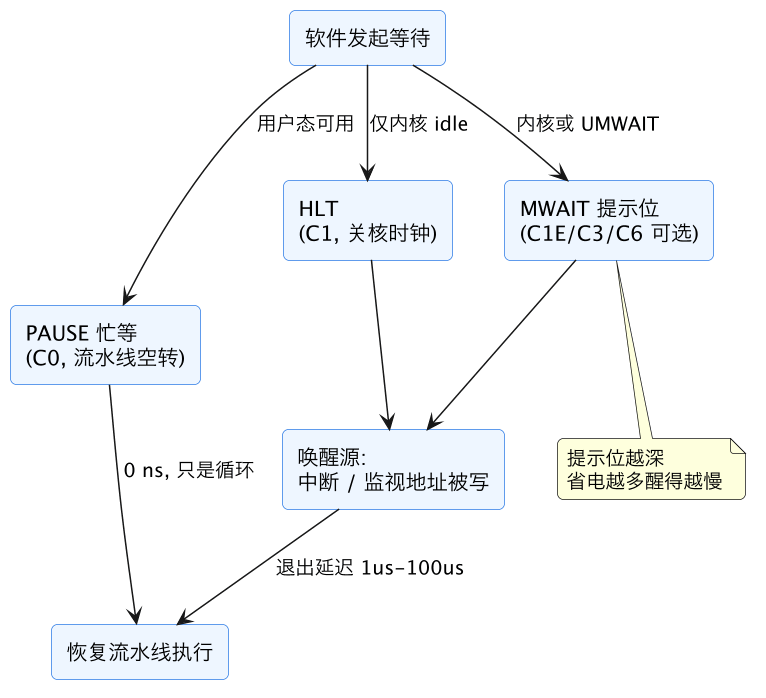
这张图的关键在右侧那条「唤醒源 → 恢复执行」的边:忙等根本没有这条边(核从没睡),而 HLT/MWAIT 必须经过它,边上挂着的就是 C-state 退出延迟。HLT/MWAIT 空转成本的全部学问,就是给这条边估价格。
还有一个图里画不下的细节:MWAIT 的唤醒源比 HLT 多一类。HLT 只认中断;MWAIT 除了中断,还认 MONITOR 武装的 cache line 被写、被无效化。这意味着生产者-消费者队列可以用「消费者 MWAIT 睡在尾指针 line 上,生产者写完数据顺手写尾指针」的零中断通知链路,省掉一次 IPI(处理器间中断)的开销——一次 IPI 本身就要 1-2 µs,对微秒级空转场景这是大头。
二、三个数量级的唤醒延迟
具体数字(x86 服务器量级,精确值查 C-state 退出延迟对照表):
| 等待方式 | 睡眠状态 | 唤醒延迟 | 空闲功耗(单核口径) | 谁能用 |
|---|---|---|---|---|
| PAUSE 忙等 | C0 | ~0 ns(循环开销几 ns) | 接近满载,数瓦到十几瓦 | 用户态任意线程 |
| HLT | C1 | ~1 µs 以内 | 核心时钟停,省约一半 | 仅内核(特权指令) |
| MWAIT C1E | C1 增强 | 1-3 µs | 比 C1 再省一截 | 内核 idle / UMWAIT |
| MWAIT C3 | C3 | 10-30 µs | LLC .flush 前停在核级 | 内核 idle |
| MWAIT C6 | C6 | 50-100+ µs | 核电压近零,<1W | 内核 idle |
注意三点。第一,HLT 是特权指令,用户态执行直接 #GP 异常——应用层想睡只能靠 Linux 暴露的 umwait/tpause(若 CPU 支持且内核开启)或者干脆系统调用让调度器代劳。第二,C6 的 100 µs 不是最坏情况:深睡时 L1/L2 已断电或刷掉,唤醒后的前几千条指令全在冷缓存上跑,业务感知的「真实成本」还要再加几个微秒的抖动尾巴,这才是 P99 毛刺的来源。第三,多核封装里核 C-state 和封装 C-state(package C-state)是两本账:只有当所有核都进了深睡,封装级才断电 LLC 和核外,收益最大;只要有一个核在忙等,其他 31 个核的深睡收益就被拖累——这也是「一个 DPDK 轮询线程拉高整机功耗」现象的根因。
实测这些数字不需要示波器:turbostat 直接按核列出 C1/C1E/C3/C6 的驻留百分比与平均驻留时长,perf 的 power:cpu_idle tracepoint 能逐次记录每次进出的状态与耗时。发现「C6 驻留率很高但平均驻留只有 300 µs」就是典型的 governor 误判——睡得勤但每次都没回本。
三、拐点计算:睡多久才值得进深 C-state
深睡的账很好算:进 C6 省功率 ΔP,但进出各付一次延迟与能量开销(电压转换、状态保存恢复)。假设 C6 比 C1E 每毫秒省 20 mW,而进出 C6 的固定能量开销相当于空跑 200 µs 的 C0 功耗,那么预计空闲时间低于几百微秒时,进 C6 是净亏——电没省回来,延迟先赔进去了。
Linux 的 idle 治理器(menu/ladder governor)干的就是这个预测:根据历史空闲间隔分布猜下一次睡多久,选「能回本的最深状态」。猜错的代价就是延迟毛刺——这也是为什么延迟敏感机型常见 intel_idle.max_cstate=1 或 idle=poll 的内核参数:宁可烧钱,把 HLT/MWAIT 空转成本里的唤醒延迟项直接清零。
还有两个更精细的旋钮。/dev/cpu_dma_latency 接口允许进程声明「我能容忍的最大唤醒延迟是 X µs」,电源管理QoS 会据此给 C-state 深度封顶——tuned 的 latency-performance profile 就是把它写成 0。TPAUSE/UMWAIT 则给了用户态一个折中:带 32 位 TSC 截止时间的定时浅睡,睡 C0.1/C0.2 这种「时钟门控但状态全留」的极浅状态,唤醒延迟压到亚微秒,功耗仍比纯忙等低不少,是用户态延迟敏感等待的现代答案。
四、按业务选型:一张决策表
| 业务类型 | 空闲时长分布 | 推荐路径 | 理由 |
|---|---|---|---|
| 自旋锁短临界区 | 十到几百 ns | PAUSE 忙等 | 睡一觉的零头都不够 |
| 网卡轮询/DPDK | 微秒级连续 | 纯轮询,禁 C-state | 任何睡眠都是 P99 杀手 |
| 交易/游戏主循环 | 微秒到毫秒 | UMWAIT C0.2/C1 或限时忙等 | 唤醒 <1 µs,功耗略降 |
| 普通服务线程池 | 毫秒级以上 | 内核 idle(HLT/MWAIT 自动选 C-state) | 省的电远超延迟损失 |
| 离线批处理/闲时整机 | 秒级 | 放开到 C6 | 功耗账压倒延迟账 |
工程上最常见的错误不是选错,而是不知道自己选的是什么:JVM、Go runtime 的自旋策略、内核 idle governor、/dev/cpu_dma_latency 约束会叠加生效,最后用 turbostat 看到的实际 C-state 驻留分布才是真相。一个真实案例:某低延迟网关升级内核后 P99 从 80 µs 涨到 180 µs,业务代码零改动——最后查到新内核默认 governor 从 performance 换成了 powersave,空闲核开始进 C6,每个网络包的第一跳都要付一次深睡唤醒费;改回 max_cstate=1 后毛刺消失。排查此类问题的固定动作是:先看 turbostat 的 C-state 驻留分布,再对 perf 的 power:cpu_idle 做直方图,延迟毛刺与深睡事件在时间上几乎总是一一对应。
虚拟机里还有一层放大:guest 执行 MWAIT 可能触发 VM-exit 落到宿主机模拟,一次退出往返就是几微秒,深睡语义还经常打折扣。云上跑延迟敏感业务时,HLT/MWAIT 空转成本里的「唤醒延迟」一列要按虚拟化口径重新测,别信裸机手册值。
这一篇在知识体系里的位置
本篇是 MONITOR/MWAIT 与 TPAUSE/UMWAIT 等待指令族 的成本篇;睡眠状态的硬件分类见 C-state/P-state 硬件功耗管理;各代 CPU 的精确退出延迟数字查 C-state 退出延迟对照表;对 HLT/MWAIT 空转成本的实测手段可结合 turbostat 与 perf 的 power:cpu_idle tracepoint。
总结
HLT/MWAIT 空转成本的本质是「睡眠深度换功耗、退出延迟做利息」:忙等零延迟但烧满功耗,HLT 进 C1 微秒内醒来,MWAIT 可睡到 C6 省电一个数量级但要付 50-100 µs 唤醒费——选型的唯一依据是业务空闲时长的分布,空闲短于几百微秒就老实忙等或浅睡,毫秒级以上才轮到深 C-state 登场。