clflushopt 与 clwb:持久内存刷缓存三兄弟的差异、fence 配对与性能排序
更新时间:2026-10-04。普通 DRAM 编程里,CPU 缓存对程序员是透明的:写进缓存行的数据迟早会被硬件写回内存,掉电丢了也就丢了,反正 DRAM 本来就是易失的。可一旦内存换成持久内存(PMem,Persistent Memory,掉电不丢数据的内存,典型代表是 Intel Optane DCPMM),这套透明性就成了陷阱——数据躺在 CPU 缓存里时还没有真正持久化,此刻掉电,缓存里的脏行全部蒸发,你以为已经落盘的日志其实根本没写到介质上。于是 x86 提供了一组把缓存行显式刷向持久域的指令:clflush、clflushopt、clwb,人称「刷缓存三兄弟」。这三条指令语义相近、性能迥异、fence 配对要求各不相同,选错一条,持久化路径的延迟能差出好几倍。本篇把它讲透。上游背景见 缓存一致性协议 MESI 与 MOESIF、内存屏障的开销 与 x86 TSO 内存模型。
本文要回答的问题
- 为什么持久内存编程必须手动刷缓存行?硬件自动写回为什么不够?
- clflush、clflushopt、clwb 三条指令在语义上到底差在哪?
- 为什么 clflushopt 和 clwb 之后必须配 sfence,而 clflush 不需要?
- 三条指令的性能排序是什么?差异从哪个微架构环节来?
- 实际写持久化数据结构时该怎么选、怎么搭配 fence?
一、问题从哪来:缓存行是持久化的盲区
先明确「持久域」(persistence domain)这个概念:掉电后数据仍然安全的最远边界。对 Optane DCPMM 而言,持久域在内存控制器里的写未决队列(WPQ,Write Pending Queue)——数据进了 WPQ,内存控制器有掉电保护电容兜底,保证把它写进介质。而 CPU 的 L1/L2/L3 缓存在持久域之外:脏行留在缓存里时掉电,数据就没了。
正常的缓存写回是被动的:缓存行被替换时才写回内存(背景见 写分配与写回策略)。你刚写完一条日志,它可能要在缓存里躺到下次被挤出去才落到 WPQ——这个时延完全不可控。所以持久内存编程多了一道显式动作:写完关键数据后,用指令把对应缓存行主动刷出缓存层次,送到持久域,然后用 fence 保证刷的顺序被全局观察到。三兄弟干的都是这件「主动刷」的事,差别在怎么刷、刷完缓存行留不留。
上图里最关键的分界线在 WPQ:蓝线以上(L1/L2/L3)都是易失的,数据只有跨过这条线才算真正落盘。三兄弟指令的作用就是把脏行从上面三层「推」过这条线,区别只在推的方式和推完之后的缓存状态。
二、三兄弟的语义差异:evict、优化 evict、write back
clflush 是老前辈,SSE2 时代就有,原本不是为持久内存设计的,语义是「使该缓存行在所有核的所有级缓存中失效,如果是脏行则先写回内存」。两个关键词:全核生效(整条一致性域都查一遍)、失效(刷完这行就不在缓存里了)。它还被定义为有序指令:clflush 相对其他访存和 clflush 操作有完整的顺序保证,后随的 store 不会越过它先被看到,所以它后面不需要再补 fence。
clflushopt 是为持久内存专门加的新指令(随 Optane 平台引入)。语义和 clflush 几乎一样——刷脏行并失效——但砍掉了强排序保证:它被定义为弱序指令,可以被前后的 store、load 重排,多条 clflushopt 之间也可以并发执行。换来的是显著更高的吞吐。代价是:顺序保证要程序员自己补,必须在适当位置插 sfence,语义是「sfence 之前发出的所有 clflushopt 都已完成,之前的 store 全局可见」。
clwb(Cache Line Write Back)走得更远一步:只把脏行写回内存,但不失效——刷完之后这行以干净状态继续留在缓存里。这对「刷完很快还要再读或再写」的数据是天大的好消息:下次访问还是缓存命中,不用从持久内存重新拉行。clwb 同样是弱序指令,必须配 sfence。
三条指令一句话各概括:clflush 是「刷并踢出,自带顺序」,clflushopt 是「刷并踢出,顺序自理」,clwb 是「只刷不踢,顺序自理」。
| 维度 | clflush | clflushopt | clwb |
|---|---|---|---|
| 引入时代 | SSE2(持久内存之前) | Optane 平台 | Optane 平台 |
| 刷脏行到持久域 | 是 | 是 | 是 |
| 刷后缓存行状态 | 失效(踢出缓存) | 失效 | 保留为干净行 |
| 顺序语义 | 强序,无需 fence | 弱序,必须配 sfence | 弱序,必须配 sfence |
| 多条并发能力 | 差(串行化倾向) | 好 | 好 |
| 适用场景 | 兼容性兜底 | 刷完不再访问的冷数据 | 刷完还要热用的数据 |
三、fence 配对:最容易写错的一步
fence 配对是三兄弟用法上最实质的分水岭,写错就是数据正确性 bug,不是性能问题。
clflush 路径最简单:store; clflush,完事。指令本身有序,下一条 store 不会被观察到发生在 clflush 完成之前——但要注意这只覆盖「单线程内持久化顺序」,跨线程发布指针之类的场景仍需常规内存序手段(见 内存屏障的开销)。
clflushopt 和 clwb 路径的固定套路是三段式:
store 数据
clwb 或 clflushopt  地址
sfence
sfence 在这里承担两个职责:一是把前面的弱序刷行指令「收拢」——sfence 返回时,之前所有 clflushopt/clwb 刷的行保证已到达持久域;二是把 store 与刷行绑定成原子般的顺序单元,保证「数据先到介质,后续动作才发生」。漏掉 sfence 的典型后果:崩溃恢复时发现数据行已持久化、但元数据(比如日志头里的长度字段)还没刷下去,或者反过来,恢复逻辑读到自相矛盾的半个状态。
还有一个容易忽略的细节:持久化的粒度是缓存行(64 字节)。如果你的记录不足 64 字节、和别的记录共享一行,刷行没问题(多刷无害);但如果一次 store 跨了两行,就得刷两个地址。工程上更常见的做法是干脆把关键记录对齐到 64 字节,一条 clwb 解决,顺便避免伪共享(见 缓存行与原子锁实现)。
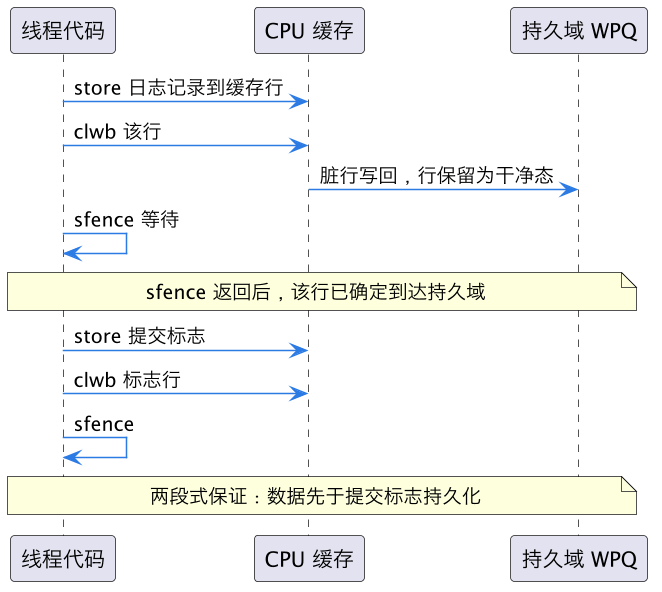
上图是持久内存编程里最经典的「数据-标志」两段式:先刷数据、sfence、再刷提交标志、再 sfence。恢复时只要看到提交标志,就能信任数据完整。两个 sfence 一个都不能省——省了第一个,标志可能先于数据到达介质,崩溃窗口里就留下了「标志说有效、数据是垃圾」的致命状态。
四、性能排序与选型
性能排序在真实 Optane 平台上相当稳定:clwb 最快,clflushopt 居中,clflush 最慢。
clflush 慢在两个地方:强序语义让它倾向于把流水线里的并发刷行压成串行;「全核失效」要在一致性域里走更重的失效路径(背景见 缓存一致性协议)。实测里它的单条延迟常常比 clflushopt 高出数倍,批量刷行时吞吐差距更大。
clflushopt 把排序责任转嫁给 sfence,多条 clflushopt 可以在缓存层次里并行飞,吞吐立刻上去。clwb 在 clflushopt 的基础上再省一步:不失效意味着后续访问不用重新从 Optane 介质拉行——Optane 读延迟本来就比 DRAM 高两三倍,这一省在「刷完马上又写同一行」的日志追加类负载里非常可观。
选型经验法则可以浓缩成三条:
- 默认用 clwb + sfence:除非有特殊理由,这是持久内存刷行的标准答案。
- 刷的是一次性冷数据、确定短期不会再碰(比如大块写透后交给后台),可以用 clflushopt + sfence,把缓存容量让给热数据。
- clflush 只作兼容兜底:目标平台不确定有没有新指令时用它(用户态库如 PMDK 内部就是按 CPUID 探测在三者间切换的),新代码不要主动选。
另外两个正交提醒。其一,sfence 本身有成本(参见 内存屏障的开销),批量刷多行后共用一次 sfence 是基本优化,不要每行一 fence。其二,若整个缓存行都是新数据、不想付「先读进行再修改」的读带宽,可以考虑非时态 store(见 非时态 load 与 store)——它绕过缓存直接进写合并缓冲区(见 store buffer 与写合并),对 PMem 同样具有持久化语义,大块顺序写场景常比「store + clwb」更省。
这一篇在知识体系里的位置
本篇属于微架构层的「缓存与内存序」支线的持久内存专题:向上承接 缓存一致性协议 MESI 与 MOESIF(脏行为什么是问题)、x86 TSO 内存模型(弱序指令为什么需要 fence)、内存屏障的开销(sfence 的成本模型);横向关联 写分配与写回策略(被动写回与主动刷行的对照)、非时态 load 与 store(另一种持久化路径)与 CXL 内存扩展的延迟(持久内存之后的内存形态演进)。往下游,它是使用 PMDK、编写崩溃一致数据结构、分析 PMem 数据库尾延迟时的必备微架构底稿。
总结
clflushopt 与 clwb 是为持久内存而生的刷缓存指令:clflush 强序但慢、clflushopt 弱序快但要配 sfence、clwb 刷完保留缓存行性能最好——记牢「写数据、clwb、sfence」三段式和「数据先于标志」两段式,持久化路径的正确性与性能就都握在手里了。