原子操作实现:LOCK 前缀与 cache line 锁定,LL/SC 和 CAS 两条路
承 coherence-directory-vs-snoop 对缓存一致性两种目录结构的讨论,以及 mesi-false-sharing 对伪共享的拆解。本篇往下再走一层:C++ 的
std::atomic::fetch_add、Go 的atomic.AddInt64、Java 的AtomicInteger.incrementAndGet,落到硬件上到底发生了什么?答案一句话就能说完——原子操作实现的核心,是让一个核心在极短的窗口里独占一条 cache line——但这一句背后有 LOCK 前缀、LL/SC、缓存一致性协议三股力量的缠斗,每一股都有实打实的性能账单。
本文要回答的问题
- 原子操作为什么离不开 cache line?「锁住一个 8 字节变量」为什么实际是锁 64 字节?
- x86 的 LOCK 前缀在硬件上做了什么?为什么现代 CPU 不再锁总线?
- ARM 的 LL/SC 和 x86 的 CAS 是两条什么样的实现路线?各自代价在哪?
- 跨核对同一个原子变量做操作时,延迟和吞吐会被一致性协议拖到什么程度?
- false sharing 下两个「互不相关」的原子变量为什么会让性能塌方?
一、原子性的最小单位:一条 cache line
直觉上,原子加一只动一个 8 字节的计数器,锁住的应该就那 8 字节。硬件不是这么干活的。一致性协议的粒度是 cache line(通常 64 字节),一个核心想「独占」某块内存,它独占的永远是装着这块内存的整条 line。
以 x86 的 lock add [mem], reg 为例,执行流程大致是:
- 核心发现这条指令带 LOCK 前缀且目标是可缓存内存(WB 类型,正常堆栈数据都是)。
- 向一致性协议申请这条 line 的 M 状态(Modified,本核独占)——如果 line 在别的核手里,先发起一次失效/回写把它抢过来。
- 在 M 状态期间完成「读-改-写」三步,期间拒绝把 line 交出去:别的核发来的窥探请求被延迟应答,或者被标记为「等我这步走完」。
- 写完释放独占,其他核的访问恢复排队。
关键在于第 3 步:现代 x86(P6 之后)不锁总线、不锁 ring/mesh,只锁这一条 line。这就是为什么两颗核对两个不同地址的原子变量做 fetch_add,只要不在同一条 line 上,就能完全并行、互不干扰——一致性协议的并行度被保留了下来。早年的 LOCK 真的是拉起一条总线锁定信号、全系统内存访问停摆,那种实现今天的服务器根本没法用。
这张图想表达的核心:原子操作实现 = 一致性状态机里的一段「M 状态不放手」窗口。窗口本身只要十几到几十个周期,贵的是「抢 M 状态」那一下——如果 line 不在本核手里,就要走一次跨核一致性事务,这就是下一节要算的账。
二、两条实现路线:CAS 与 LL/SC
各家 ISA 在「怎么把读-改-写表达成原子」上分成了两派。
x86 / 部分 ARMv8.1+:CAS(Compare-And-Swap)路线。硬件直接提供一条复合指令 lock cmpxchg,一次完成「比较旧值 + 条件写入」。这条路线语义强、编程简单,C++ 的 compare_exchange 直接映射过去;fetch_add、xchg 也都有对应指令。代价是:失败重试是软件层面的循环,高竞争下一个 CAS 循环可能空转几十次,每次失败都伴随着 line 在核间倒手。
ARM 经典实现 / RISC-V:LL/SC(Load-Linked / Store-Conditional)路线。硬件给一对指令:LDXR(读并在这条 line 上装一个「监视器」)+ STXR(仅当监视器没被打碎时才写入,返回成败标志)。从 LL 到 SC 之间,只要这条 line 被别的核碰过(哪怕是同 line 的不同字节)、或者本核发生了上下文切换、或者监视器容量溢出,SC 就失败重试。硬件实现上更简单(不用在指令里塞复合语义),但失败面比 CAS 更宽——同 line 的无关写入也能打碎监视器,这让 LL/SC 对 false sharing 格外敏感。
| 维度 | CAS(x86 lock cmpxchg) | LL/SC(ARM LDXR/STXR) |
|---|---|---|
| 原子粒度 | 一条 cache line 的独占窗口 | 监视器覆盖的一条 cache line |
| 失败原因 | 旧值被改(值层面) | line 被动过 / 切核 / 监视器溢出(面更宽) |
| 复合指令 | 单条指令完成 RMW | 两条指令 + 软件循环 |
| ABA 问题 | 有(值相同≠没被动过) | 同样有 |
| false sharing 敏感度 | 高竞争时 line 乒乓,重试多 | 更敏感:同 line 无关写也会打碎 SC |
| 典型延迟(无竞争,line 已在 M 态) | ~10-20 周期 | ~10-20 周期 |
| 典型延迟(跨核抢 line) | ~50-150+ 周期 | ~50-150+ 周期 |
值得记一笔的趋势:ARMv8.1 引入 LSE(Large System Extensions),直接加了 LDADD、CASAL 这类单指令原子,向 x86 的 CAS 路线靠拢——因为在大核数机器上,「让一条指令独占 line」比「LL/SC 反复装/碎监视器」对一致性流量更友好。
三、跨核原子串行化:一致性协议收的过路费
无竞争时原子操作很便宜:line 已经在本核 M 态,整条 RMW 十几个周期搞定,只比普通 load/store 贵一点(还要加上它隐含的内存序约束,见 fence-memory-barrier-cost 对屏障代价的分析)。真正的账在跨核。
假设核 0 和核 1 都对同一个原子计数器 fetch_add,一致性协议会强制这样串行化:
- 核 0 拿到 M 态,完成 RMW,释放;
- 核 1 的窥探发现 line 在核 0 手里且是脏的,发起回写或直接从核 0 的缓存转发;
- line 物理上(或逻辑上)从核 0 的 L1 倒到核 1 的 L1;
- 核 1 完成 RMW,下一轮又来。
每倒一次手就是一次跨核一致性事务:snoop 广播/目录查找 + 数据转发,典型 50-150 周期,跨 socket(走 ring/mesh 或 UPI/Infinity Fabric,见 uncore-ring-mesh-interconnect)还要再翻几倍。64 个核抢同一个原子变量时,吞吐不再随核数增长,而是被钉死在「1 / 单次倒手延迟」上——这就是教科书里说的原子串行化瓶颈:不是算术慢,是 line 的独木桥只能一次过一个。
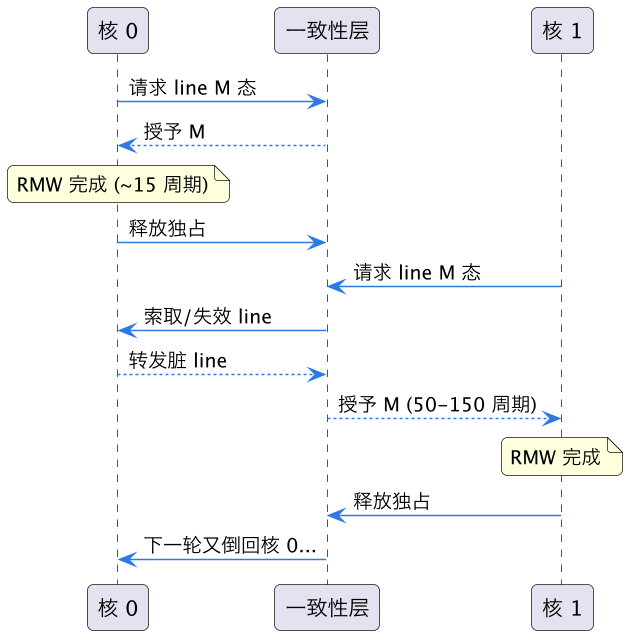
这张时序图解释了为什么 perf 里高竞争原子变量表现为「IPC 暴跌 + 大量 mem_load_l3_hit / 跨核 snoop 事件」:每条原子指令的有效延迟都被拉长到了跨核事务级别。
四、false sharing 下的原子抖动
把第二节的「粒度是 64 字节」和第三节的「倒手要花钱」拼起来,就得到一个经典事故配方:两个原子变量躺在同一条 cache line 上。
比如这样一个线程局部计数器数组:
struct Counter { std::atomic<long> v; };        // 8 字节
Counter counters[8];                             // 8 个挤在 1 条 line 里
// 线程 i 只更新 counters[i] —— 逻辑上零共享
逻辑上每个线程各写各的,物理上 8 个线程抢同一条 line 的 M 态。每个 fetch_add 都把 line 从上一个核手里抢过来,下一拍又被抢走——line 像乒乓球一样在核间弹,吞吐塌方到单核的几分之一。LL/SC 机器上更惨:连「只读同 line 的其他变量」都可能打碎监视器,让无关的 SC 反复失败。
修法标准且廉价:把每个原子变量对齐填充到 64 字节(C++17 的 alignas(64)、std::hardware_destructive_interference_size),让每个 hot 原子独占一条 line。更根本的做法是改数据结构——每个核先本地累加、最后归并(类似 Linux percpu 计数器、Go 的 sync.Pool 分片思路),把「共享原子」从热路径上彻底拿走。对 false sharing 本身更全面的分析见 mesi-false-sharing,对 store buffer 一侧的配合机制见 store-buffer-write-combining。
实践中定位这类问题的三板斧:
perf stat -e cycles,instructions看 IPC 是否随核数增长反而下降;perf c2c record/report(x86)直接抓 HITM(Hit Modified)热点,按 cache line 聚合看哪条 line 在核间被反复倒手;- 对照源码检查 hot 原子变量的地址间距——
&counters[i+1] - &counters[i]小于 64 字节基本就坐实了。
这一篇在知识体系里的位置
原子操作实现是「一致性协议 → 内存序 → 并发编程」这条链上的中间一层:往上看,memory-consistency-models-tso 解释为什么 x86 的原子指令天然带 acquire/release 语义;往下走,coherence-directory-vs-snoop 决定了跨核抢 line 的具体路径和延迟量级;横向的 lsu 和 store-to-load-forwarding 讲普通 load/store 的旁路世界,正好和本篇「独占、串行、不旁路」的原子世界形成对照。
总结
原子操作实现的硬件本质是让一个核心短暂独占一整条 cache line 完成读-改-写:x86 用 LOCK 前缀的 CAS 单指令、ARM 用 LL/SC 监视器(ARMv8.1 起也转向单指令 LSE),无竞争时只要十几周期,跨核抢 line 时被一致性事务拉到几十上百周期,而 false sharing 会让同 line 的原子变量互相乒乓、把多核吞吐打回单核水平——对齐到 64 字节、能本地累加就不共享,是对抗原子抖动最廉价的两招。