KPTI 与 PCID 的微架构成本:页表隔离的 CR3 切换与 TLB 抖动如何被压回个位数
更新时间:2026-10-03。Spectre 与 Meltdown 瞬态执行攻击 那篇讲了 Meltdown 的攻击原理:用户态一条看似普通的加载指令,在乱序窗口里能短暂读到内核页的数据,再靠缓存侧信道把字节偷出来。软件层面的止血方案就是 KPTI(Kernel Page-Table Isolation,内核页表隔离):既然用户态不该碰到内核数据,那就干脆在用户态运行时把内核从页表里「摘出去」,让非法访问在地址翻译阶段就直接缺页,乱序投机连读的机会都没有。代价是每次进出内核都要切一次 CR3、抖一次 TLB——2018 年初刚合入时,syscall 密集负载的性能损失一度高达 30%。后来 PCID(Process-Context Identifier,进程上下文标识符)这个早在 Westmere 时代就存在、一直没人用的指令集特性被翻了出来,把开销压回到个位数百分比。本篇把这段攻防史背后的微架构账算清楚。TLB 本身的工作原理见 TLB 与页表遍历缓存,两级 TLB 结构见 TLB 两级设计与 STLB。
本文要回答的问题
- KPTI 的双页表到底长什么样?「用户页表」和「内核页表」各映射了什么?
- 为什么切换 CR3 会导致 TLB 大面积失效?失效的代价具体是多少周期?
- 没有 PCID 时,一次系统调用的完整开销由哪几部分组成?
- PCID/ASID 给 TLB 项贴「标签」的机制是什么?它怎么让两套页表在 TLB 里和平共处?
- 开了 PCID 之后还有哪些残余开销?什么负载该考虑
pti=off?
一、双页表:用户态能看见什么,内核态能看见什么
KPTI 的核心结构改动一句话说完:原来每进程一份页表(用户空间和内核空间都映射在内),改成每进程两份页表。
- 用户页表(user page table):映射全部用户空间,加上进出内核必需的「跳板」——一小段内核入口代码、栈、IDT(中断描述符表)、GDT 以及 trampoline 段。这一小段通常只占几个页,而且被精心设计成不含任何敏感数据。用户态运行时就挂这份页表,Meltdown 式的投机加载想去读内核数据,地址翻译直接不命中页表,乱序窗口里连数据都拿不到。
- 内核页表(kernel page table):完整映射——用户空间加全部内核空间,跟 KPTI 之前那份一样。只有真正进入内核后才切到这份。
每次 syscall 指令陷入内核,入口汇编做的第一件事就是把 CR3(页表基址寄存器)从用户页表切到内核页表;sysret/iret 返回用户态前再切回来。中断、异常、NMI 同理。也就是说,一次系统调用至少发生两次 CR3 写,而 CR3 写正是后面全部成本故事的起点。
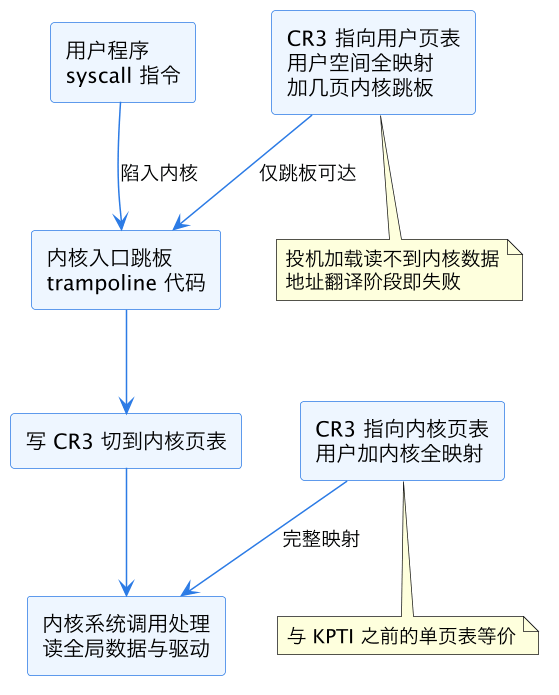
上图是双页表的运行形态。关键点在左侧:用户页表不是「没有内核映射」那么简单,它必须保留进出内核的通道,否则 syscall 陷入后连入口代码都取不到。设计难点全在怎么把这条通道削到最薄——薄到里面没有任何值得偷的数据。x86 上这段跳板最终只有一两个页,这也是 KPTI 能在不修改 ABI 的前提下上线的原因。顺带一提,跳板薄还有第二层动机:它处在每次陷入与返回的关键路径上,代码越少,取指与解码的固定开销越小,后面第三节算总账时这一项会再次出现。
二、CR3 切换为什么贵:TLB 失效的连锁反应
写 CR3 这条指令本身的流水代价很小,真正贵的是它的副作用:TLB(Translation Lookaside Buffer,地址翻译快表,工作原理见 TLB 与页表遍历缓存)里的旧表项在新页表下全部失去意义。
在没有 PCID 的传统 x86 语义里,写 CR3 会把整个 TLB 中所有非 global 表项无条件冲刷(invalidate)。道理很朴素:TLB 项记录的是「虚拟页 → 物理页」的翻译,而这套翻译是跟着 CR3 指向的页表走的;换了页表,同一个虚拟地址的含义完全变了,旧翻译必须作废。唯一豁免的是标记了 Global 位的表项(内核里那些所有进程共享、从不换页的映射,比如直接映射区),它们跨 CR3 切换保留。
KPTI 场景下这个冲刷是毁灭性的。用户页表和内核页表对「用户虚拟地址」的翻译其实一模一样(用户部分两边映射相同),但硬件不知道这件事——它只知道 CR3 变了,于是一次系统调用的两次 CR3 写,把用户态辛苦攒下的 TLB 热度冲掉两遍。返回用户态后,接下来几百上千条指令的每次访存都可能撞上 TLB miss,触发页表遍历(page walk):四级页表就是四次内存级访问,命中各级页表遍历缓存(见 TLB 与页表遍历缓存)时约 20-30 周期,走到内存则要上百周期,还会挤占 L1/L2 缓存把数据顶出去,造成二次伤害(大页缓解 TLB 压力的思路见 大页与 TLB 压力)。
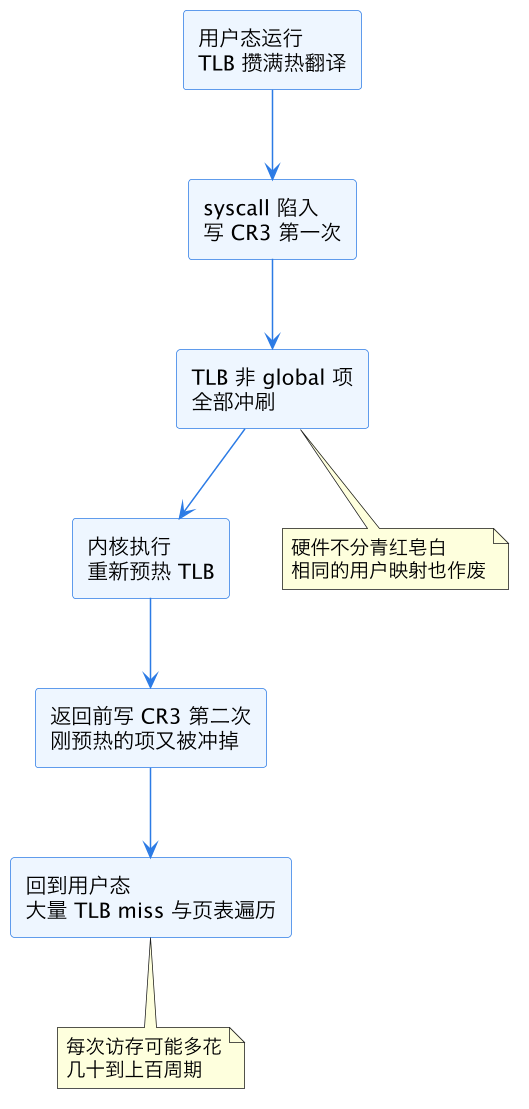
上图是「冲两遍」的全过程。注意最伤的不是第一次冲刷(反正内核要跑一阵,可以慢慢预热),而是返回前那第二次冲刷——内核刚帮用户把 TLB 焐热,一写 CR3 全白搭。这就是为什么 KPTI 对 syscall 密集负载的伤害远大于计算密集负载:getpid() 这种「秒回」的系统调用,内核段几乎没干活,两次冲刷的成本却一次不少,全由用户态的冷启动买单。
下面这张表把无 PCID 时一次系统调用的开销拆一下(以 2018 年初的 Skylake 实测为参照量级):
| 开销项 | 无 KPTI | KPTI 无 PCID | 说明 |
|---|---|---|---|
| syscall 陷入与返回本身 | 约 50 到 100 周期 | 同左 | 指令流水代价,与 KPTI 无关 |
| 两次 CR3 写 | 0 | 数十周期 | 加上 trampoline 代码的执行 |
| TLB 冲刷后的重填 | 0 | 数百到数千周期 | 取决于工作集大小,摊在返回后的访存里 |
| 内核数据结构的缓存污染 | 轻微 | 明显加重 | 页表遍历挤占 L1 和 L2 |
| 合计(getpid 级调用) | 约 100 周期 | 300 到 800 周期 | 短系统调用翻 3 到 8 倍 |
三、PCID:给 TLB 项贴标签,让两套页表共存
PCID 的思路简单到让人奇怪为什么 2018 年才想起来用:既然 TLB 冲刷的根源是「硬件不知道哪些表项属于哪份页表」,那就给每个 TLB 项贴一个 12 位的标签(PCID 值),CR3 写的时候带上 PCID,硬件只认「当前 CR3 加当前 PCID」组合下的表项,切换时一项都不用冲。
Linux 的用法很固定:用户页表用 PCID A,内核页表用 PCID B(同一进程两个值只差一位)。陷入内核时写「CR3 = 内核页表,PCID = B」,返回时写「CR3 = 用户页表,PCID = A」。因为 PCID 不同,写 CR3 不再触发全局冲刷,两边各自攒的 TLB 热度原样保留。用户态返回后,上次运行留下的翻译还在 TLB 里等着,访存直接命中。
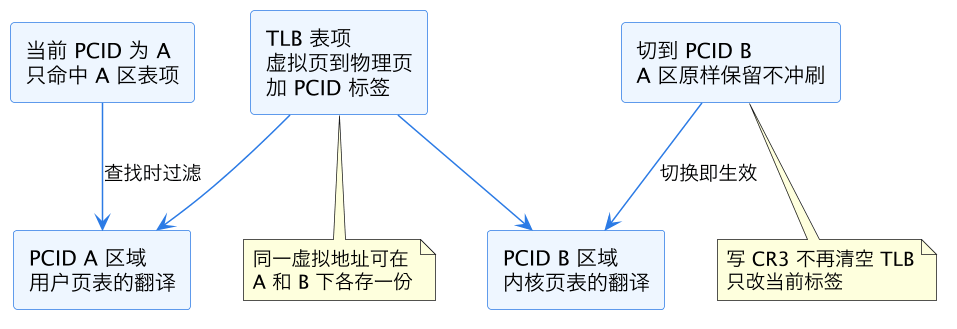
上图是 PCID 的「标签共存」模型。TLB 从「一份页表的私有缓存」变成「多份页表共享、按标签分区的缓存」。这里有个隐形代价:同一虚拟地址可能在两个 PCID 下各存一份,等于 TLB 有效容量对半劈——但两级 TLB 设计里 STLB(第二级 TLB,1536 项量级,见 TLB 两级设计与 STLB)容量足够大,这个稀释效应远小于全局冲刷。
PCID 还有一条容易踩的使用纪律:写 CR3 分「冲刷型」和「不冲刷型」两种,由 CR3 值里第 63 位(PCID 上下文中的 no-flush 位)控制。内核每次切换都走不冲刷型,但有两种情况必须强制冲刷——一是该 PCID 被回收改指别的页表了,旧标签下的表项必须清掉;二是页表内容本身被修改(比如 munmap 拆掉一段映射),同一 PCID 下的对应表项作废。第二种情况用 INVPCID 指令做精准失效:可以只清某 PCID 下某一个虚拟地址的表项,也可以清某 PCID 的全部表项,粒度比「整体冲刷」细得多。这套定向失效语义后来被 TLB shootdown 优化大量复用。
ARM 世界有同构机制 ASID(Address Space Identifier,地址空间标识符),用来区分不同进程的 TLB 项;ARM64 的 KPTI 实现同样靠「内核段与用户段用不同 ASID/TTBR」避免冲刷。RISC-V 的 satp 寄存器也带 ASID 字段。这套「给地址空间贴标签」的思路是全行业共识,只是 x86 的 PCID 此前一直被闲置——进程切换本来就要刷 TLB,标签省了冲刷却增加了表项竞争,收益不明显;直到 KPTI 把「每秒几十万次页表切换」变成现实,PCID 才从鸡肋变成救命稻草。
四、完整账:从翻倍到个位数
把 PCID 放进整条系统调用路径,账就变成下面这样。硬件支持 PCID 且内核启用后,一次 getpid() 的额外开销从「300-800 周期」收缩到「两次带 PCID 的 CR3 写加跳板代码」,大约几十到一百多周期;对真实负载,syscall 密集型的 perf bench 与数据库基准显示,KPTI+PCID 相对无 KPTI 的退化普遍落在 1% 到 5%,而无 PCID 时是 10% 到 30%。
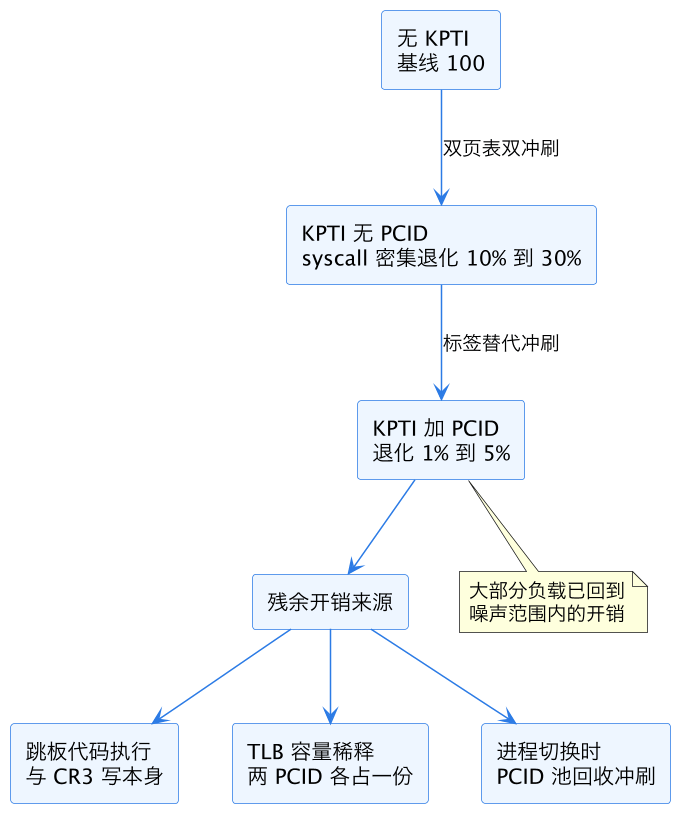
上图收拢了三种配置的性能台阶与 PCID 之后仍然存在的三项残余开销。第三项值得展开:PCID 只有 12 位、4096 个值,而系统里的进程数远超此数,Linux 只能给「最近活跃的少量上下文」动态分配 PCID(每 CPU 一个小池子)。进程切换时如果新进程的页表不在池里,就要回收一个旧 PCID——回收意味着按标签定向冲刷那一撮表项(INVPCID 指令按 PCID 或按地址精准失效,这正是 PCID 配套的原语)。好在进程切换的频率比系统调用低几个数量级,这笔账摊下来很小。与之相关的「远端核 TLB 清理」问题见 TLB Shootdown 失效广播。
实测侧还有一个值得知道的现象:PCID 的收益和 CPU 代际强相关。Westmere 到 Broadwell 时代的 PCID 实现有个怪癖——不冲刷型 CR3 写本身要等几个周期的额外延迟,而且部分型号的 INVPCID 微码很慢;Skylake 之后这些路径被重新打磨,PCID 才真正「免费」。这也是为什么同一份内核,在 2012 年的老至强上开 KPTI+PCID 仍然肉疼、在 2017 年后的机器上几乎无感。做容量规划时把「CPU 是否支持 PCID 且微码已更新」列为 KPTI 成本评估的第一项,比对着通用百分比拍脑袋靠谱得多。
给运维决策留一张对照表,什么场景该在意、什么场景可以放手:
| 负载特征 | KPTI+PCID 影响 | 建议 |
|---|---|---|
| 计算密集(科学计算、编译) | 接近 0,常被噪声淹没 | 保持开启,安心 |
| syscall 密集(strace 类、高频小 IO) | 1% 到 5%,短调用占比越高越明显 | 保持开启,必要时用批量 IO 降调用频率 |
| 上下文切换密集(高并发短连接) | PCID 池回收带来少量额外冲刷 | 保持开启,关注 perf stat 的 dTLB miss |
| 可信内网、无不可信代码的老机器 | 无 PCID 的老 CPU 损失可达两成以上 | 评估风险后可 pti=off 或升级硬件 |
这一篇在知识体系里的位置
本篇是微架构模块「瞬态执行攻击与缓解」线的成本篇。上游攻击原理见 Spectre 与 Meltdown 瞬态执行攻击,地址翻译基础设施见 TLB 与页表遍历缓存、TLB 两级设计与 STLB 与 大页与 TLB 压力,跨核失效广播见 TLB Shootdown 失效广播。相邻的隔离成本话题还有 EPT 与 NPT 二级地址翻译 和 VMExit 的微架构成本——虚拟化场景下 KPTI 的 CR3 切换还会和 EPT 切换叠加。全景地图见 CPU 微架构总览。
总结
KPTI 为堵 Meltdown 把每进程页表拆成「用户页表加内核页表」两份,用户态只挂削到只剩几页跳板的用户页表,让投机加载在地址翻译阶段就失败;代价是每次系统调用两次 CR3 写,而无 PCID 时写 CR3 会把 TLB 非 global 项全部冲刷,返回用户态后大量 TLB miss 让短系统调用开销翻 3 到 8 倍、syscall 密集负载退化一到三成;PCID/ASID 给每条 TLB 项贴 12 位地址空间标签,写 CR3 只切标签不清表项,两套页表的翻译在 TLB 里共存,KPTI 开销被压回 1% 到 5% 的个位数区间——这是「安全缓解措施的软件结构改动,最终要靠一个沉睡多年的微架构特性来买单」的经典案例。