解耦前端与 FDIP:BTB 主导的取指预取如何隐藏指令侧延迟
更新时间:2026-10-05。讲乱序执行时我们反复强调「后端窗口再大,前端供不上指令也是白搭」,这个供给问题的根源在指令侧内存层次:代码 footprint 一大,L1I 装不下,取指流水线就得等 L2 甚至 LLC 送指令过来,一次停顿几十拍起步。传统的应对是把 L1I 做大、把预取器做激进,但指令访问的模式和数据完全不同——数据预取器看地址流,指令预取的有效信息却藏在分支预测器里。解耦前端(decoupled front-end)正是把「预测往哪走」和「真正去取指」拆成两段、中间用队列缓冲的结构;FDIP(Fetch Directed Instruction Prefetch,取指定向指令预取)则是跑在这个结构之上的预取策略:让 BTB 主导的预测流顺便给 L1I 下发预取。分支预测器本身见 TAGE 分支预测器 与 分支目标缓冲 BTB,前端停顿的观测见 ITLB 未命中与前端停顿。
本文要回答的问题
- 解耦前端把哪两段拆开了?中间的 FTQ 到底缓冲什么?
- 为什么指令侧预取不能照搬数据侧 stride/stream 预取器的思路?
- FDIP 如何利用 BTB 的预测流向 L1I 发预取?「看多远」由什么决定?
- 预测出错时预取会不会白做?FDIP 的代价和边界在哪里?
- 如何在真实机器上确认自己的负载吃的是指令侧延迟、FDIP 类机制帮没帮上忙?
一、耦合前端的问题:预测器和取指被绑在一根绳上
先看传统(耦合式)前端的节奏:每个周期,分支预测器根据当前取指 PC 查 BTB 和方向预测器,给出「下一个取指块在哪」;取指单元立刻拿这个地址去访问 L1I;取回来的指令送进译码;下一轮预测基于刚取到的指令继续。预测、取指、译码像三节连挂的车厢,任何一节卡住,整列车停。
卡住的原因主要有两种。第一种是 L1I 未命中:取指地址不在 L1I,要等 L2,十几到二十拍,期间预测器也闲着——因为它的输入依赖取指结果推进(对非 taken 分支可以继续按顺序猜,但 taken 分支的目标、间接分支的目标都得等指令到手才知道细节)。第二种是 taken 分支气泡:每个 taken 分支都会让取指方向折一次,折向本身要消耗周期,细节见 taken 分支取指气泡。
服务器类负载把第一种问题放大到极致。一个数据库或 Java 后端进程的指令热 footprint 轻松上到几百 KB 甚至数 MB,32KB 或 64KB 的 L1I 覆盖率惨淡,L1I 未命中率可以到每千条指令几十次。Topdown 方法论里这类负载大量周期落在 Front-End Bound 的 Fetch Latency 子项上,观测方法见 Topdown 分析方法论。
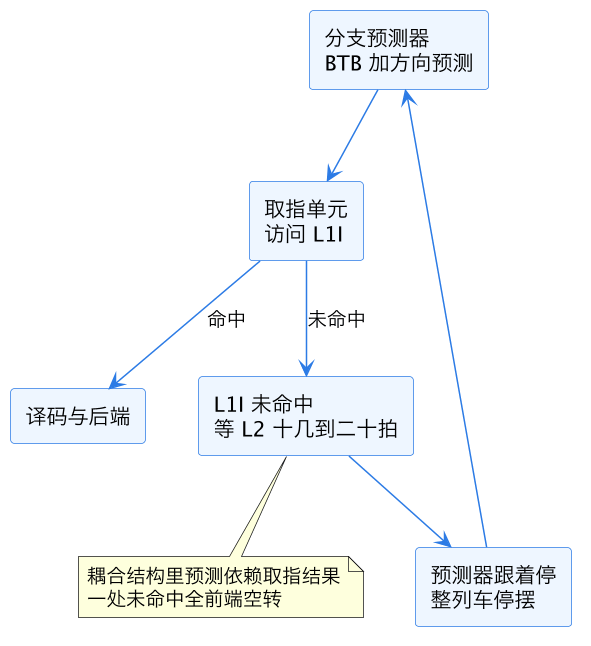
上图是耦合前端的死结:预测器的推进依赖取指的产出,而取指随时可能被内存层次卡住。问题的本质是「两件事情被强行同步」——知道「该往哪走」其实不需要等指令取回来,BTB 里存的目标地址本来就够推演出后面一长串取指地址。这个观察就是解耦的出发点。
二、解耦前端:FTQ 把「往哪走」和「去取指」拉开
解耦前端在预测器和取指单元之间插一个队列:FTQ(Fetch Target Queue,取指目标队列,专篇见 FTQ 取指目标队列)。预测器不再直接把地址塞给取指单元,而是每个周期产出一个或多个「取指目标」——本质上是「下一个基本块的起始地址、块内到分支为止的长度、预测方向」这样的条目——压进 FTQ,然后就自顾自继续往下预测。取指单元从 FTQ 另一头弹出条目,按自己的节奏访问 L1I。
这一插,两个时钟域就解开了:
- 预测侧只要 FTQ 没满,就能一直往前跑。L1I 未命中堵的是取指侧,预测器可以越过这个停顿点,把后面几十条基本块的地址都提前算好,堆在 FTQ 里。
- 取指侧只要 FTQ 没空,就有活干。预测器偶尔被复杂间接分支卡一下(比如 ITTAGE 要多级查表,见 间接分支预测器 ITTAGE),取指侧靠队列里攒下的目标照样满速。
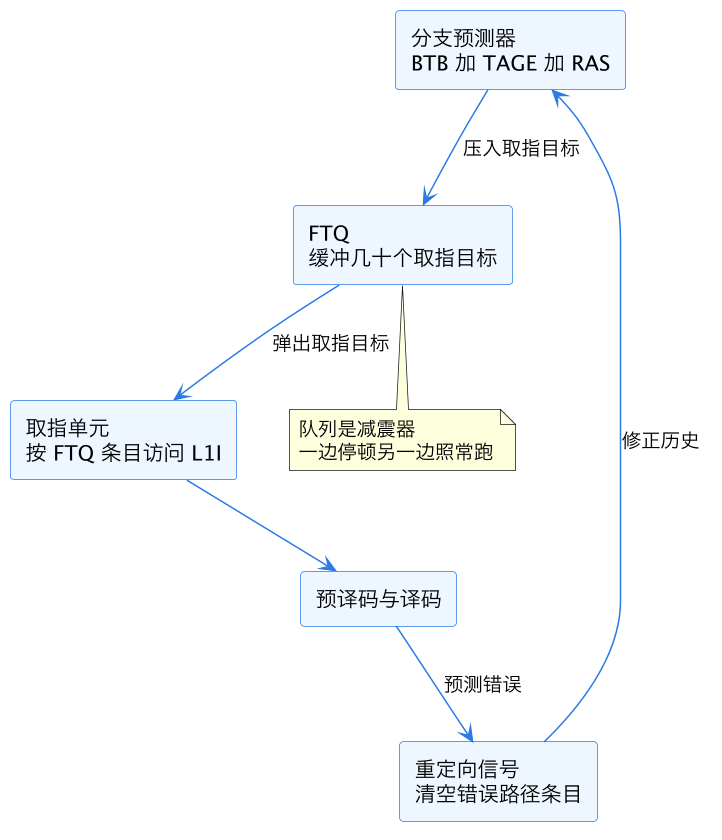
上图的核心是 FTQ 这个减震器。它同时还承担了投机状态管理的职责:每个条目都挂在某条预测路径上,一旦后端发现预测错误,重定向信号把错误路径上的 FTQ 条目清空、预测器用真实结果重新训练历史,再沿着正确路径重新填充。这个恢复流程的细节见 取指重定向与恢复。
注意一个分寸:解耦并没有消除 L1I 未命中的延迟,只是把它的杀伤力从「全前端停摆」降成「取指侧独自消化」。如果 L1I 未命中是常态而不是偶发,FTQ 攒得再多也有被取空的一天,到时候预测侧还是得等。要把未命中的代价真正藏起来,得让指令提前进 L1I——这就是 FDIP 的活。
三、为什么指令预取不能照搬数据预取
数据侧的硬件预取器(stride、stream 之类,见 硬件预取器 stride 与 stream)靠观察 load 的地址流找规律:等差、跨步、连续流。这套搬到指令侧会水土不服,原因有三:
- 指令访问模式由控制流决定。代码里跳来跳去,取指地址序列是「基本块 A、基本块 X、基本块 M……」,块内连续、块间乱跳,stride 预取器看到的是一团乱码。
- 规律其实存在,但藏在预测器里。分支预测器(TAGE、BTB、RAS)恰恰是专门学控制流规律的硬件,准确率 95% 以上。另起一个预取器重新学一遍,既重复又学不过它。
- 时序要求不同。数据预取晚一点只是没帮上忙;指令预取如果发得过早,可能把正热的代码行挤出去,或者预取进一条根本不会执行的路径,纯污染。
所以正确的姿势是「预取器不猜,直接抄预测器的作业」。解耦前端天然提供了这个接口:预测器往 FTQ 里压的每个取指目标,本身就是一个「将来大概率要访问的指令地址」,而且带时间序——FTQ 里越靠后的条目,离真正执行越远,提前量越大。
| 维度 | 数据侧预取 | FDIP 指令侧预取 |
|---|---|---|
| 规律来源 | 观察 load 地址流 | 直接复用分支预测结果 |
| 主要预测硬件 | stride/stream 引擎 | BTB 加 TAGE 加 RAS |
| 地址模式 | 等差与连续流 | 基本块链加控制流跳转 |
| 准确性上限 | 模式明显才高 | 与分支预测准确率同源 |
| 错误代价 | 浪费带宽加缓存污染 | 同样,且可能挤掉热代码 |
这张表解释了 FDIP 的设计哲学:指令侧预取的正确性天花板就是分支预测的准确率,与其再造一个更差的预测器,不如把最好的那个(已经在为推测执行服务的分支预测器)的输出直接拿来驱动预取。
四、FDIP 的机理:BTB 主导的预取流
FDIP 的经典形态(Reinman 等人在 1999 年前后的工作中提出,近年被 ARM Neoverse、AMD Zen 的服务器核广泛实现并强化)可以概括成一条流水线:
- 预测器按当前预测路径推进,产生一串取指目标地址(就是 FTQ 条目的来源)。
- 预取逻辑挂在这条预测流的旁边,对其中每个目标地址做 L1I 查找——注意只是查 tag,不占用取指端口的关键资源,或用空闲周期查。
- 查到了,什么都不做;没查到,向 L2 发一个预取请求,把这一行填进 L1I(或填进 L1I 旁的预取缓冲)。
- 等真正的取指单元走到这个地址时,行已经在 L1I 里,未命中被「提前消化」了。
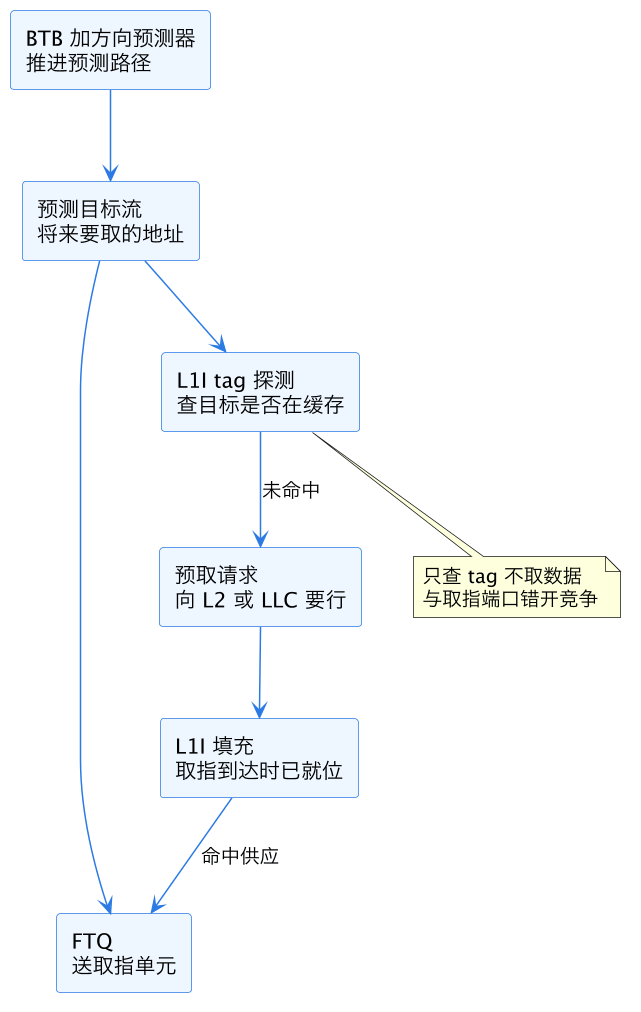
上图里预取流和取指流共享同一个预测源头,但探的是不同时间点:取指探「现在」,预取探「将来」。「将来多远」是 FDIP 最关键的旋钮。预取距离太近(比如只看 FTQ 里下一两个条目),请求发出去还没来得及回来,取指就到了,等于没预取;距离太远,则预测准确率随路径深度指数衰减(每多一层分支,可信度乘一次预测准确率),预取一堆错误路径的行纯浪费。工程上常见的折中是让预取流领先取指流若干条 FTQ 条目,或者用专门的「预取 PC」以固定块数跑在取指 PC 前面,这个领先量往往动态可调。
间接分支是 FDIP 的难点也是亮点。直接分支的目标地址在 BTB 里现成;间接分支(虚函数、函数指针、switch 跳转表)的目标要靠 ITTAGE 这类预测器现算,而服务器负载(Java、解释器、回调密集的框架)恰恰是间接分支大户。现代实现让 FDIP 的预取流同样消费间接预测的结果,等于把间接预测器「多远能看准」的能力直接折算成指令预取的覆盖深度。
RAS(返回地址栈)也参与这场游戏:函数调用的返回路径由 RAS 预测,预取流顺着 RAS 给出的返回目标继续往前探,跨函数的指令行也能提前拉进来。RAS 的结构见 返回地址栈 RAS。
五、预测错了怎么办:FDIP 的代价与边界
预取是投机,投机的代价要算清。
第一个代价是错误路径污染。分支预测有 3% 到 5% 的错误率,FDIP 沿着错误路径预取的行会被填进 L1I,挤占正确路径的位置。好在指令工作集的复用通常不错——错误路径往往也是近期会走到的路径(比如循环的另一个分支方向),很多「错取」的行不久后会真的用上。实测里 FDIP 的预取准确率(预取的行最终被使用的比例)普遍在 70% 以上,代价可接受。
第二个代价是带宽与端口竞争。预取请求要和取指、数据侧的 L2 请求抢 Miss 队列与带宽(MSHR 资源的背景见 MSHR 未命中状态寄存器)。激进 FDIP 在 L2 带宽紧张的场景会反过来拖慢数据侧。所以实现上通常给预取请求低优先级:MSHR 有空闲才发、取指真实未命中优先。
第三个边界是 L1I 未命中本身的量级。如果你的 workload L1I 命中率 99.9%(小热循环、微基准),FDIP 没有用武之地,预取流查 tag 全命中,纯空转——好在空转成本极低。FDIP 的主战场是指令 footprint 大的服务器负载:数据库、Web 服务、Java/Go 运行时、编译器。学术评测里 FDIP 对这类负载的 IPC 提升常见 10% 到 20%,个别未命中重灾区更高;商用核心里,ARM Neoverse N/V 系列的 L1I 预取就是 FDIP 思路的直系后代,AMD 也在服务器 SKU 上强调类似的「取指先行」机制。
| 场景 | FDIP 收益 | 原因 |
|---|---|---|
| 微基准与小热循环 | 接近零 | L1I 本来全命中 |
| 通用桌面应用 | 小到中 | footprint 中等,偶发未命中 |
| 数据库与 Java 后端 | 中到高 | 代码热区几百 KB 以上 |
| 编译器与解释器 | 高 | 控制流碎加间接分支密集 |
| L2 带宽已饱和场景 | 可能为负 | 预取抢数据侧资源 |
六、观测:怎么确认指令侧延迟与预取效果
落到调优实操,怎么判断自己的工作负载吃不吃这一套?
第一步,用 Topdown 确认前端瓶颈。perf stat -M TopDownL1(Intel)或对应的 PMU 事件看 Frontend_Bound 占比,再下钻到 Fetch Latency 类事件(ICACHE_16B.IFDATA_STALL、FRONTEND_RETIRED.L1I_MISS 等)。事件体系见 PMU 性能计数器编程。
第二步,看指令侧未命中的量级。perf stat -e L1-icache-load-misses 粗看,更细的用 ICACHE_64B.IFTAG_MISS 这类事件区分「取指真未命中」和「预取流探测未命中」——后者的存在本身就说明核心在跑 FDIP 类机制,且它如果能大量「提前接住」未命中,前者的停顿就会小。
第三步,从软件侧配合。既然 FDIP 把赌注押在预测器的准确性上,任何让分支更好预测、让代码布局更紧凑的手段都在给 FDIP 铺路:PGO/BOLT 重排基本块让热路径连续(减少 taken 跳转和 L1I 行碎片)、减少函数指针散乱间接跳转、控制代码膨胀。ITLB 也是同一链条上的环节——预取流同样要查 ITLB,大页代码段(huge pages for text)能把 ITLB 未命中压下去,让预取流跑得更远,相关背景见 大页与 TLB 压力。
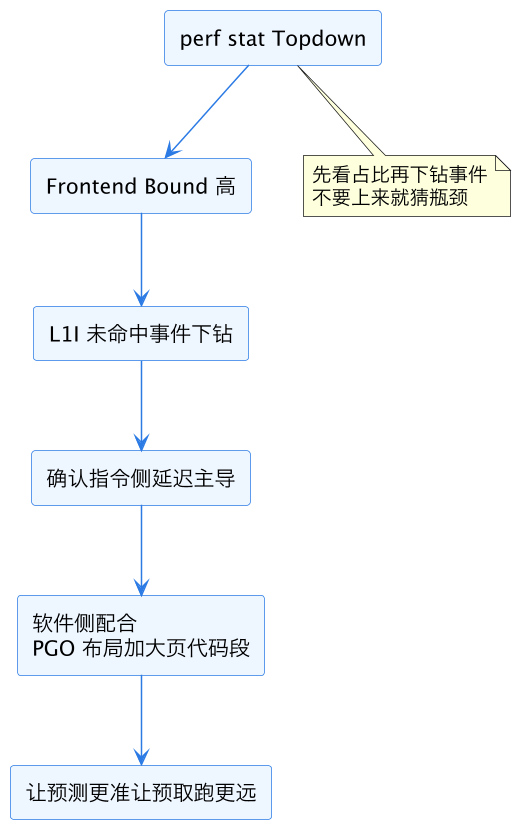
上图是排查顺序:从 Topdown 占比下钻到具体事件,确认指令侧延迟是主因之后,再谈配合手段。硬件侧的 FDIP 你改不了(它是核内机制,没有开关可调),但软件侧的每一项——布局、间接跳转密度、代码段大页——都在改变 FDIP 的输入质量。
这一篇在知识体系里的位置
本篇属于微架构模块「前端供给线」。上游基础是 分支目标缓冲 BTB、TAGE 分支预测器 与 返回地址栈 RAS——FDIP 的预取流完全复用这三者的输出;同线的邻居是 FTQ 取指目标队列(解耦结构的队列本体)、taken 分支取指气泡 与 取指重定向与恢复。对照面是数据侧的 硬件预取器 stride 与 stream,预取效果的量化口径见 预取准确率与覆盖率指标。瓶颈定位方法见 Topdown 分析方法论 与 IPC 瓶颈分析,全景地图见 CPU 微架构总览。
总结
解耦前端把分支预测器和取指流水线用 FTQ 拉开:预测侧只管把「将来要走的取指目标」源源不断压进队列,取指侧按自己的节奏消费,L1I 未命中堵住的只是取指一侧而不再拖停整个前端。FDIP 更进一步,让 BTB(连同 TAGE、ITTAGE、RAS)主导的预测流旁路探测 L1I tag、对未命中目标提前向 L2 发预取,把指令缓存未命中的几十拍延迟藏进预测窗口里——代价是少量错误路径污染和带宽竞争,换来数据库、Java 后端等大指令 footprint 负载上一成到两成的 IPC 提升;它的本质洞见是:指令侧最好的预取器不是新造的地址模式引擎,而是已经在为推测执行服务的分支预测器本身。