内存序 litmus 测试全景:从 x86-TSO 到 ARM/RISC-V 的最小剧本族谱
更新时间:2026-10-06。本站在内存序方向已经攒下几篇零件级深文:ARM 与 x86 内存屏障差异 讲两套指令集的屏障语义差在哪,内存屏障的真实开销 用 perf 数出 fence 到底吃多少个周期,内存一致性模型与 TSO 讲 x86 的全序存储模型是什么,store buffer 与写合并 和 store-to-load 转发 讲重排的硬件源头。零件都在,缺的是一张族谱:两个核各执行三四条指令的最小剧本(litmus test),就能把「这个架构允许多离谱的乱序」钉死在纸上。这篇枢纽文把这族剧本一次讲全。
本文要回答的问题
- litmus 测试到底是什么,为什么三四条汇编就能暴露一个架构的内存模型底线?
- x86-TSO、ARM、RISC-V 三种内存模型各自允许哪些重排,不允许哪些?
- SB、LB、MP、WRC、IRIW 这五个经典剧本各自考哪一种重排?
- 屏障(fence)分哪几类,编译器乱序和硬件乱序为什么要分开堵?
- 想在真机上亲手复现这些剧本,该用什么工具、看哪些计数器?
- 日常写无锁代码时,怎么把「认剧本、查架构、堵口子」变成肌肉记忆?
一、为什么需要 litmus 测试:把内存模型变成可判卷的题目
内存一致性模型回答的问题是:多个核对同一块内存又读又写时,每个核观察到的写入顺序可以有多不一样。教科书里的定义(顺序一致性、TSO、弱序)都是抽象的,抽象定义的毛病是无法执行——你没法把「x86 是 TSO」这句话喂给机器,让它告诉你某段无锁代码会不会出事。
litmus 测试(石蕊测试)的思路是把问题反过来:不写定义,写剧本。给两个或更多核各安排一小段精确的访存序列,给内存位置预设初值,然后问一个是非题:「某种结果组合可不可能出现?」比如两个核各写一个变量、再读对方的变量,问「两个核都读到旧值 0」可不可能。可能,剧本就「通过」——注意这里「通过」意味着架构允许这种反常结果,是件坏事被证实了。
这种形式化有三个好处。第一,剧本极小,三四条指令,可以穷举所有交错执行,学术工具(herd7、diy7)能直接算出「该架构下所有允许的结果」。第二,剧本可以直接编译成汇编码在真机上跑几百万次,理论允许的结果跑不出来、理论禁止的结果却跑出来了,那就是硬件或工具链的 bug——ARM 和 RISC-V 早期芯片都靠这招抓过实现错误。第三,它把「内存模型」从哲学讨论变成了工程师的判卷标准:你的无锁队列对不对,等价于它在哪几个 litmus 剧本的变体上会不会翻车。
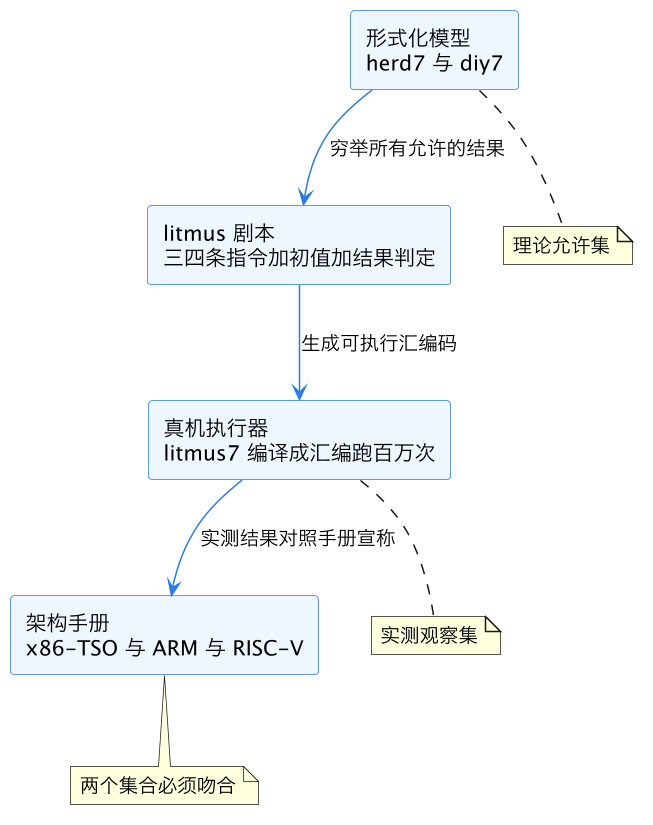
上图是 litmus 方法论的三脚架:形式化模型算出「允许集」,真机执行器跑出「观察集」,两者必须严丝合缝地落在架构手册的宣称上。任何一边对不上,都是值得发论文或召回芯片的事故——历史上 ARMv7 多拷贝原子的含糊、某款商用芯片的 TLB 与屏障交互 errata,都是在这个三脚架的失衡中被发现的。这张图也解释了为什么 litmus 测试是硬件验证和编译器验证的公共语言——它是唯一能被机器执行、被穷举验证、被逐周期追责的内存模型表达,从芯片设计签收(sign-off)到编译器后端测试,再到内核无锁原语的 review,全链路说的是同一套剧本语言。
二、三种内存模型的底色:谁允许哪种乱序
在进剧本之前,先把三位选手的底色摆清楚。内存模型的宽松程度可以用四种「重排是否允许」来刻画:读-读乱序、读-写乱序、写-读乱序(按程序序,前面的读能不能被后面的写超过)、写-写乱序,外加两个全局性质:写后读转发(store 还没进缓存就被后面的 load 看到)和多拷贝原子性(一个核对某地址的写,是所有核同时看到,还是不同核可以在不同时间看到)。
| 架构 | 写-读重排(SB 型) | 读-读/读-写重排 | 写-写重排 | 多拷贝原子 | 一句话画像 |
|---|---|---|---|---|---|
| x86-TSO | 允许(store buffer 导致) | 基本不允许 | 不允许 | 是 | 只松一个口子的强模型 |
| ARM(AArch64) | 允许 | 允许 | 允许 | 是(ARMv8 起) | 几乎全松,靠屏障按需收紧 |
| RISC-V(RVWMO) | 允许 | 允许 | 允许 | 是 | 与 ARM 同档,规则写得更形式化 |
| IBM Power | 允许 | 允许 | 允许 | 否 | 最弱,IRIW 剧本都会翻车 |
这张表是全篇的索引,后面每个剧本就是在表里的某一个格子上打钩或打叉。先记住两个要点。第一,x86 比你以为的弱:唯一的口子「写-读重排」恰恰是无锁编程里最常见的坑——Dekker 互斥、双检查锁(double-checked locking)在 x86 上翻车,根子都在这一个口子,内存一致性模型与 TSO 对这个模型有完整刻画。第二,ARM 和 RISC-V 的「弱」不是混乱:它们允许重排,但提供依赖规则(地址依赖、控制依赖)和分级屏障让你精确地按需堵口,语义是严格的,只是默认值宽松。
历史上有两个细节值得记住。其一,ARM 的多拷贝原子性是 ARMv8 才立字据的——ARMv7 时代手册对此含糊其辞,早期多核 ARM 芯片在 WRC 类剧本上实测出现过非原子行为,后来架构修订干脆把「多拷贝原子」写进了合同正文,可见 litmus 测试反过来塑造过架构标准本身。其二,RISC-V 的 RVWMO 是第一个「生下来就带形式化定义」的主流内存模型:规范直接以 herd7 可执行的公理化模型写成,允许集没有任何自然语言的模糊空间,这等于把 litmus 方法论从验证工具升格成了规范载体。
还要强调一个经常被混淆的点:内存模型管的是「核观察内存的顺序」,不是「指令在核内执行的顺序」。乱序核内部早就把指令重排得天花乱坠,但只要 store buffer 和 load/store queue 的提交机制配合得当,对外呈现的可以是严格的 TSO——load-store queue 与访存消歧 讲的就是这套「内部乱、外部稳」的机制。
三、SB 与 LB:最基础的两个剧本,store buffer 的直接证词
SB(Store Buffer)剧本是内存序世界的「Hello World」:
初值: x = 0, y = 0
P0:  Sx=1 ; Ly    (写 x,读 y)
P1:  Sy=1 ; Lx    (写 y,读 x)
判定: P0 的读 = 0 且 P1 的读 = 0,可能吗?
直觉上不可能:两个核总有一个先写,后读的那个核至少该看到一个 1。但在 x86、ARM、RISC-V 上,「都读到 0」是合法结果,真机上轻松复现。机制就是 store buffer:每个核的写先进自己的 store buffer,对其他核还不可见;随后的读直接去缓存拿,拿到的是旧值。两边的「写」都趴在各自的 buffer 里没出厂,「读」却已经完成了——对外看,就像「写被推迟到了读之后」,即写-读重排。store buffer 与写合并 对这个结构的组织方式有详细拆解。
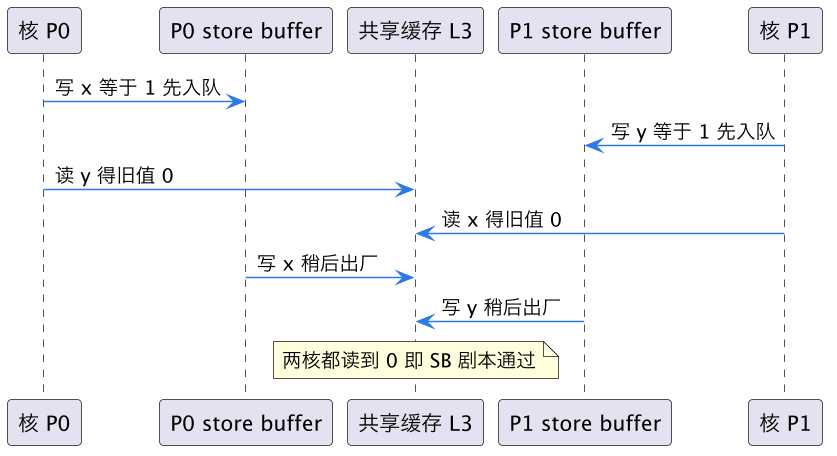
上图里两个写事务「出厂太晚」是全剧的关键。要堵住它,x86 在两条指令之间放 mfence(或改用 xchg 这种带 lock 前缀的指令,lock 自带全屏障语义,见 原子操作的缓存行实现),ARM 放 dmb sy,作用都是先把 store buffer 排空再放行后续的读。代价可量:内存屏障的真实开销 实测全屏障在几十到几百周期量级,取决于 buffer 里积压多少写。
LB(Load Buffer)是 SB 的镜像:两边各先读对方变量、再写自己变量,问「两个读都读到对方的新值」可不可能。顺序执行下不可能——总有一个读的发生在对方的写之前。x86 上这个结果禁止(TSO 不允许读-写重排),ARM 和 RISC-V 上允许:读还在等缓存回复时,后面的写已经先对外可见了。LB 是区分「x86 与 ARM」最快的试金石:同一段无锁代码在 x86 上跑了三年没事,移植到 ARM 第一周就偶发错乱,多半就是踩了 x86 帮你免费堵住的 LB 型口子。
四、MP 与 WRC:消息传递剧本,依赖与屏障的战场
MP(Message Passing)是无锁编程真正的日常形态——生产者写数据、再置标志位,消费者读标志位、再读数据:
初值: data = 0, flag = 0
P0:  Sdata=1 ; Sflag=1
P1:  Lflag (读到 1); Ldata
判定: P1 读到 flag=1 但 data=0,可能吗?
x86 上不可能:TSO 保写-写顺序、保读-读顺序,消息传递天然安全。ARM 上可能,而且有两条独立的翻车路径。路径一:生产者的两个写乱序出厂(写-写重排),flag 先到、data 后到。路径二:消费者的两个读乱序返回(读-读重排),data 的旧值先到手。所以 ARM 上正确的 MP 要双边设防:生产者 dmb ishst(store-store 屏障)或直接用 stlr(store-release),消费者 dmb ishld(load-load 屏障)或用 ldar(load-acquire)。ARMv8.3 还提供了更便宜的 ldapr,语义接近 acquire 但允许与前面的读重叠——ARM 与 x86 内存屏障差异 对 acquire/release 与 dmb 家族的对照表讲得很细。
WRC(Write-to-Read Causality)把 MP 拉成三核接力,考的是多拷贝原子性:
初值: x = 0, y = 0
P0:  Sx=1
P1:  Lx (读到 1); Sy=1
P2:  Ly (读到 1); Lx
判定: P2 读到 y=1 但 x=0,可能吗?
因果链是:P0 写 x → P1 看到后才写 y → P2 看到 y 后读 x。如果写是「广播给所有核且同时可见」(多拷贝原子),P2 既然已经透过 y 知道了 P1 的进度,读 x 必须读到 1。x86、ARMv8、RISC-V 都是多拷贝原子的,这个反常结果禁止。IBM Power 不是多拷贝原子:P0 的写可以先被 P1 看到、还在去往 P2 的路上,P2 就能出现「看到 y=1 却读 x=0」的时空错乱——除非 P1 在写 y 前加 sync 屏障强制自己的观察扩散到全系统。
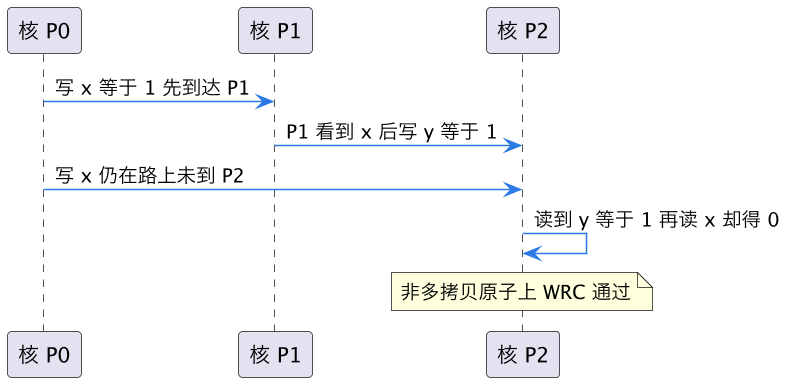
上图是 WRC 翻车的时序:同一个写「到达不同核的时间不同」就是非多拷贝原子的定义。WRC 的工程意义在于提醒:「我明明按顺序写的,对方凭什么看到旧值」在弱序机器上不是 bug,是模型允许的行为;连锁反应式的可见性必须靠屏障一环一环焊死,而不是指望硬件替你传播因果。
五、IRIW:连「两个写的先后顺序」都能各说各话
IRIW(Independent Reads of Independent Writes)是内存序剧本里最反直觉的一个:
初值: x = 0, y = 0
P0:  Sx=1
P1:  Sy=1
P2:  Lx (读 1); Ly (读 0)
P3:  Ly (读 1); Lx (读 0)
判定: P2 认为「x 先写」,P3 认为「y 先写」,可能吗?
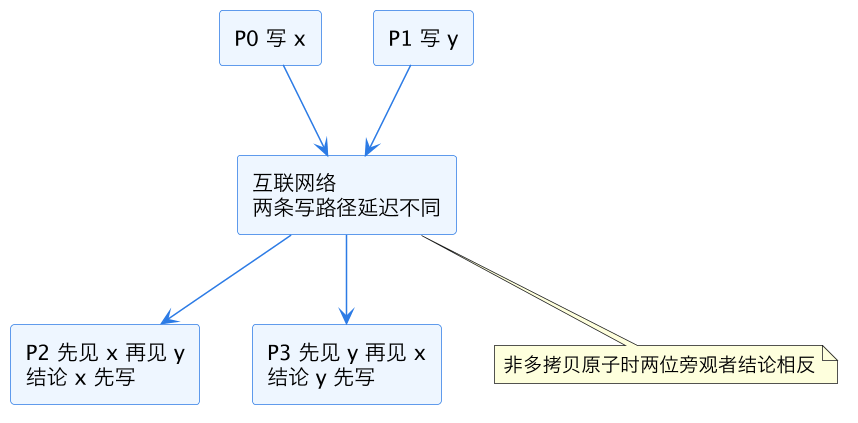
两个旁观者对「x 和 y 谁先写」得出了相反结论。顺序一致性下这绝不可能——全系统只有一个统一的操作序列。多拷贝原子的架构(x86、ARMv8、RISC-V)也禁止它:写的可见性是全局广播式的,不存在「x 先到 P2、y 先到 P3」的错位窗口。但非多拷贝原子的 Power 允许:两个写各自沿互联网络慢慢扩散,到达 P2、P3 的顺序恰好相反。有趣的是,IRIW 甚至不需要乱序核——纯互联拓扑(两个写走不同路径、延迟不同)就能制造它,这也是 片上 Mesh 互联 这类分布式结构里一致性协议必须小心的边界。
IRIW 的实用推论是:「所有核对所有写的顺序达成一致」不是免费的物理事实,而是架构给你的一份合同。x86/ARM/RISC-V 签了这份合同,Power 没签。如果你的算法(比如某些无锁内存回收方案)暗地里依赖「第三方观察者对写顺序有一致看法」,移植前必须查这份合同。
六、屏障分类与两层乱序:编译器和硬件要分开对付
到这里,剧本需要的「堵漏工具」可以系统化了。屏障按堵的口子分类:
| 屏障类型 | x86 实例 | ARM 实例 | 堵的口子 | 典型场景 |
|---|---|---|---|---|
| load-load | (隐含,无需指令) | dmb ishld / ldar | 读-读重排 | 消费者先读标志后读数据 |
| store-store | (隐含) | dmb ishst / stlr | 写-写重排 | 生产者先写数据后置标志 |
| load-store | (隐含) | dmb ish 的一部分 | 读-写重排 | 罕见,顺序保持 |
| 全屏障 | mfence / lock 前缀 | dmb sy | 含写-读在内的全部 | SB 型互斥、Dekker |
| 编译器屏障 | asm volatile 空指令 | 同左 | 编译器指令重排 | 所有共享访问的必要底线 |
注意 x86 那一列三个「隐含」:TSO 已经替你把读-读、读-写、写-写顺序保住了,只剩写-读一个口子,所以 x86 上唯一的显式屏障需求就是 mfence/lock。这正是「x86 代码移植到 ARM 会出事」的镜像表述:x86 程序员省下的屏障,全是 TSO 替他们买的单。
屏障开销的直觉也值得补一句:load-load 和 store-store 屏障在大多数实现里是「排序约束」而非「等待」——硬件只需保证出站顺序,不必停下来等谁,所以代价常常接近零;全屏障(mfence/dmb sy)则要排空 store buffer,把积压的写推到一致性域里拿到确认才能放行后续读,代价与 buffer 深度和缓存未命中延迟直接挂钩。这就是为什么「ARM 全弱」听起来可怕、实测却未必慢:弱模型允许你用恰好够用的屏障,而不是每次都为最坏的口子买单。内存屏障的真实开销 里的分屏障实测数据印证了这一点。
另一个必须掰开的事实是两层乱序。硬件乱序是本文全部剧本的主题;但在硬件之前,编译器早就把代码重排过一轮了——寄存器分配、指令调度、死代码消除,都可能让两个共享访存交换位置甚至消失。编译器屏障(GCC/Clang 的 asm volatile("" ::: "memory"),或 C11 的 atomic_signal_fence)不生成任何机器码,只是告诉编译器「不许跨线搬运内存操作」。两层各管各的:编译器屏障堵不住 store buffer,mfence 管不了编译器把 load 提前。C11/C++11 的 std::atomic 内存序(relaxed/acquire/release/seq_cst)本质上就是把这两层屏障打包成一套可移植的词汇表。
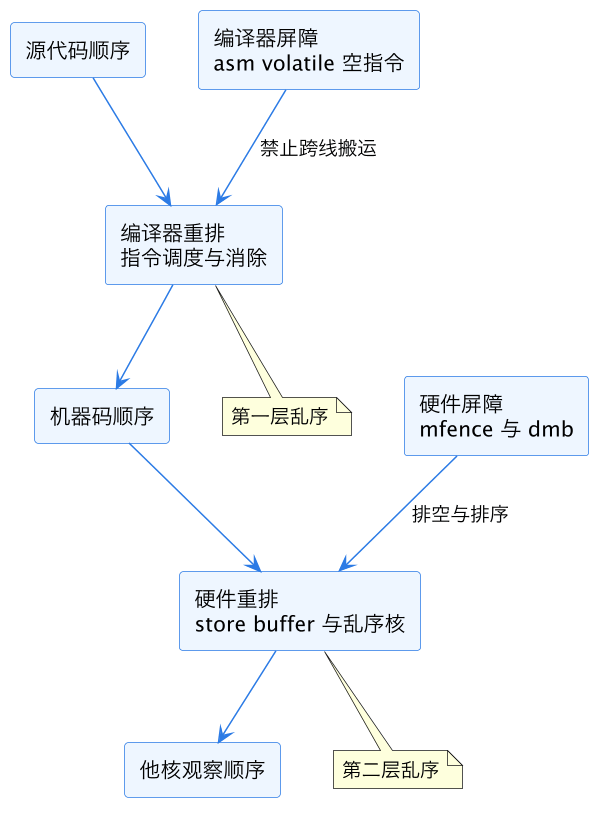
七、亲手复现:工具链与观测
litmus 测试不是纸上游戏,标准工具链半小时就能搭起来。学术侧是 diy 工具族:diy7 生成剧本、herd7 在形式化模型上模拟、litmus7 把剧本编译成 C 或汇编在真机上高并发循环跑。真机复现的工程要点有三:两个线程必须用亲和性钉在不同物理核上(SMT 兄弟核的 store buffer 行为不同,见 SMT 同时多线程);循环次数要上千万级,反常结果往往概率在万分之一以下;变量要拆到不同缓存行,避免伪共享把剧本搅成别的问题。
一个典型的 SB 剧本 C 代码骨架长这样:两个线程各持一个共享变量,循环里先写自己的变量、再读对方的变量、把读到的值记入结果数组,主线程每轮检查「两个读是否同时为 0」。在 x86 服务器上跑这个循环,通常几十万次迭代内就能抓到第一批「双零」样本;把读之前加上 mfence 再跑,样本归零——一个下午就能完成「发现口子、堵上口子」的完整闭环,这是任何教科书定义都给不了的直觉。
还有两类工具值得知道。一类是模型检查器:herd7 可以对剧本做穷举模拟,直接告诉你「x86-TSO 模型下该结果允许出现 1 次、共 4 种执行交错」,适合在写代码前做纸面推演。另一类是动态检测器:TSan(ThreadSanitizer,见 并发查错工具族 相关篇目)通过插桩在运行期抓数据竞争,抓到的违规本质上就是某个 litmus 剧本的失控实例。两者一静一动,覆盖「设计期推演」与「运行期抓现行」两个阶段。
性能侧的观测是另一套语言。屏障导致的停顿可以用 perf stat 看周期与指令数的恶化;store buffer 排空阻塞在 Intel 上有专门事件(如 RESOURCE_STALLS.SB);想直接观察「load 读到了还没退休的 store 的数据」这类微架构事件,可以配合 load 重放与流水线恢复 里讲的 replay 计数器。对生产代码,更实用的姿势是反着用 litmus 思维:每写一个无锁结构,先问它对应哪个剧本的哪个变体,再决定放什么屏障——这比任何调试都便宜。
八、常见无锁模式与剧本对照:写代码前先认剧本
理论落到工程,最实用的一步是建立「无锁模式 → litmus 剧本 → 所需屏障」的对照反射。下表覆盖五种最高频的模式:
| 无锁模式 | 对应剧本 | x86 需要 | ARM 需要 | 翻车形态 |
|---|---|---|---|---|
| 标志位消息传递(单产单消队列) | MP | 无 | release 写 + acquire 读 | 消费者读到空数据 |
| 双检查锁初始化单例 | MP 变体 | 无(TSO 兜底) | load-acquire 读指针 | 拿到半构造对象 |
| Dekker 式互斥、Peterson 锁 | SB | mfence 或 xchg | dmb sy | 双方同时进临界区 |
| seqlock 读侧校验 | LB + MP | 编译器屏障 | 两次 dmb ishld | 读到撕裂的序列号对 |
| RCU 发布-订阅 | MP + 依赖链 | 无 | release 发布,读侧依赖或屏障 | 读者看到旧字段 |
这张表里有三个值得单独点出的坑。第一,双检查锁在 x86 上「裸写裸读」历史上没出事,纯属 TSO 的恩赐:TSO 保写-写顺序(构造完成先于指针发布)又保读-读顺序(读到指针后才读字段),四条防线一条不缺。同一份代码搬到 ARM 立刻变成 MP 剧本的裸奔版本——C++11 把「初始化单例用 atomic + acquire/release」写进惯用法,本质是给可移植性还债。
第二,seqlock 是 LB 剧本的活教材。读侧的经典写法「读序号、读数据、再读序号比对」依赖两个序号读之间夹住数据读不被重排;x86 的 TSO 保读-读顺序所以只需编译器屏障防编译器捣乱,ARM 上则必须用 dmb ishld 把读-读顺序钉死,否则第二个序号读可能提前返回,校验形同虚设。Linux 内核的 read_seqbegin/read_seqretry 在不同架构下展开成不同的屏障组合,正是这张对照表的内核级实现。
第三,RCU 读侧在 ARM 上有个精巧的豁免:如果读者是「先读指针、再按指针读数据」,数据访问对指针访问构成地址依赖——ARM 的依赖规则保证有地址依赖的两个读不会被重排,所以 RCU 读侧可以零屏障。这是「弱序不等于处处要 fence」的最佳案例:模型宽松,但依赖链本身被架构承认。反过来说,编译器有时会把依赖链优化掉(比如把 p->x 算成常量),所以内核才需要 READ_ONCE 这种同时约束编译器的原语——两层乱序在这里又一次交汇。
把这张对照表用熟之后,review 无锁代码的套路就收敛成三步:认出它属于哪个剧本;查目标架构在该剧本上允不允许反常结果;允许的话确认屏障(或依赖链)是否真的堵上了口子。绝大多数线上无锁 bug 都能在这三步里现形——剩下的小部分,多半是忘了编译器那一层,或是把「在我这台 x86 上跑了三年」误当成了正确性证明。
这一篇在知识体系里的位置
本篇是微架构内存序方向的枢纽:模型层接 内存一致性模型与 TSO,屏障层接 ARM 与 x86 内存屏障差异 与 内存屏障的真实开销,机制层接 store buffer 与写合并、store-to-load 转发、load-store queue 与访存消歧,一致性协议层接 缓存一致性目录与监听。读完本篇再读任何无锁算法的正确性论证,都可以先问一句:它依赖的剧本在我的目标架构上通过吗?
总结
内存序 litmus 测试用三四条指令的最小剧本给每种架构的内存模型「判卷」:SB 暴露 store buffer 的写-读重排(x86 也翻车)、LB 和 MP 区分 x86 与 ARM 的强弱、WRC 与 IRIW 检验多拷贝原子性;写无锁代码的正确姿势是先认清自己站在哪个剧本上,再用编译器屏障和硬件屏障各堵各的口子。