硬件预取器:stride 跨步与 stream 流预取是怎么提前把数据搬进缓存的
承 缓存缺失分类与 AMAT:强制缺失和容量缺失决定了程序要花多少拍等内存,而硬件预取器正是把这些缺失「提前发起」从而近乎免费的部件。它跟你熟悉的 非阻塞缓存与 MSHR 是一对搭档——MSHR 允许「同时挂着多个未完成缺失」,预取器负责「提前把这些挂起的坑位用上」。总览级的预取类型梳理见 硬件预取器:顺序、跨步、流与相邻行预取,本篇往下钻一层:stride 和 stream 这两种主力预取器在微架构里到底是怎么检测、怎么触发、怎么出事的。
本文要回答的问题
- 硬件预取器在不知道程序语义的前提下,凭什么猜到你下一个要访问的地址?
- stride(跨步)预取器和 stream(流)预取器的检测逻辑有什么本质差别?
- 预取一次请求从「检测到规律」到「数据进缓存」中间经过哪些环节、各要多少拍?
- 预取准确度、及时性、污染这三个指标怎么权衡?为什么预取太积极反而变慢?
- 生产环境什么时候该关硬件预取器?怎么关、怎么验证关掉之后确实变好了?
一、预取器在存储层级里的位置
现代 Intel/AMD 服务器 CPU 一般挂着三四套互相独立的预取器,各管一摊:
| 预取器 | 位置 | 盯什么 | 典型触发模式 | Intel 命名 |
|---|---|---|---|---|
| 指令相邻行预取 | L1I | 取指地址 | 顺序取下一行 | Next-Line IP |
| DCU 数据预取 | L1D | load 地址流 | 相邻行 + 简单 stride | DCU IP / next-line |
| L2 stride 预取 | L2 | L1 缺失地址流 | 固定步长跨步 | Streamer(部分代) |
| L2 stream 预取 | L2 | L2 缺失地址流 | 连续地址流(上行/下行) | Streamer / AMP(AMD) |
这里最容易混的是:L1 侧预取器看的是 load 指令发出的虚拟地址,L2 侧预取器看的是 L1 缺失后到达 L2 的物理地址流。两者看到的「规律性」不完全一样——虚拟地址连续的 stride 在物理地址上可能被 4KB 页边界打断,所以 L2 预取器通常不跨 4KB 页训练,这是个真实存在的工程限制。
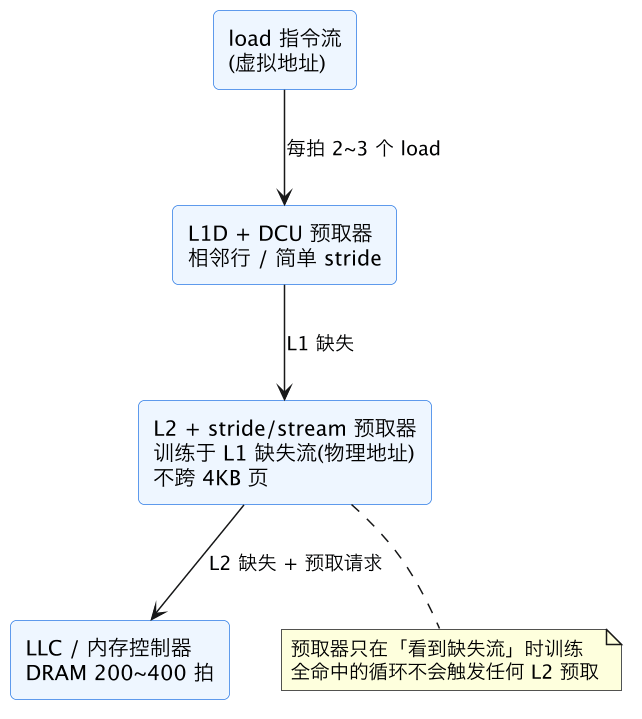
图上这条链有一个反直觉的点:预取器是被缺失喂养的。如果循环工作集全部命中 L1,L2 的 stride/stream 预取器根本看不到任何地址,也就无从训练。所以「命中率越高预取越少」不是 bug,是设计——预取的存在意义就是掩盖缺失,没有缺失它自然歇着。
还有一个常被问的问题:预取进来的数据放在哪一级?各家的答案不一样。L2 streamer 的预取通常只填到 L2,不进 L1(避免污染小而快的 L1D);DCU 预取器才负责把数据推进 L1。有些架构还支持「预取到 LLC」这一档——数据离核心还隔着一层,但总比在 DRAM 强。预取深度越深、落点越远,本质都是在「污染风险」和「掩盖延迟」之间取折中:落点越靠近核心,掩盖得越彻底,可一旦预取错了,挤掉的也是越宝贵的缓存空间。这也是为什么 L1 侧预取普遍保守(只取相邻一两行),L2 侧才敢大步流星(一次拉 1~2KB)。
最后提一句预取与一致性的关系:预取只读不修改,发出的请求以 Shared 态进入缓存,不触发任何对软件可见的状态变化——预取绝不会改变程序语义,它影响的只有性能和缓存内容分布。这一点和后面会讲的非临时存储形成鲜明对比。
二、stride 预取器:给 load 地址流做差分
stride 预取器的核心思想一句话:记录每条 load 指令(按 PC)最近的访问地址,相邻两次访问做差,差值稳定就按这个步长往后预取。
实现上是一张按 PC 索引的训练表(几十到上百项),每项大致长这样:
| 字段 | 含义 |
|---|---|
| tag | load 指令的 PC(或 PC 哈希) |
| last_addr | 上一次该 PC 访问的地址 |
| stride | 当前认定的步长(有符号,可负) |
| confidence | 置信度计数器(连续命中 N 次才发预取) |
| state | invalid / init / transient / steady |
工作流程是状态机:
- load 命中训练表 → 计算
delta = addr - last_addr; delta == stride且非零 → confidence 加一;到阈值进入 steady,开始按addr + k*stride(k 常见 1~16)发预取请求;delta != stride→ confidence 清零、更新 stride、退回 transient;- 预取距离(prefetch distance)动态调节:准确率高就拉远,污染多就收近。
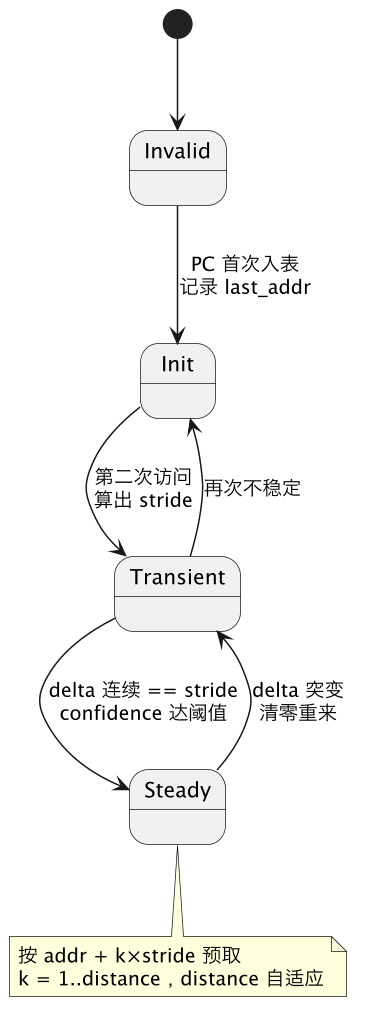
举个具体例子感受置信度的作用。循环 for (i=0; i<N; i++) sum += a[i*32]; 里同一条 load 的地址序列是 0、2048、4096、6144……第一次入表只记地址,第二次算出 stride=2048 进入 transient,第三、第四次 delta 仍为 2048,confidence 到阈值(常见是 2~4 次),steady 成立——此后这条 load 每执行一次,预取器就朝 当前地址 + k×2048 发出一串请求。若中途插入一个随机访问使 delta 变成别的值,confidence 立刻清零,预取静默,等规律重新连续出现再恢复。这个「学得快、忘得也快」的不对称设计是故意的:错误预取的代价远大于晚几拍开始预取的代价。
这个状态机也解释了为什么「步长不稳定的间接访问」(比如 a[idx[i]])会把 stride 预取器耍得团团转:每次 delta 都不一样,confidence 永远到不了阈值,预取器学一轮废一轮,白白消耗训练表项和一点点功耗,但一般不会发错误预取。真正的灾难是伪规律——结构体数组 AoS 里隔字段访问,步长恰好是结构体大小,预取器学得又快又稳,一旦你的访问其实是「随机起始、局部 stride」,它就会自信地把一堆没用的行拉进来。训练表项本身也是稀缺资源:表满时新 PC 要按 LRU 之类策略顶掉旧项,高频切换的代码段里多条 load 互相驱逐,每个都停留在 transient 阶段出不了师。
三、stream 预取器:盯住「一整条地址流」
stream 预取器(Intel 叫 Streamer,是 L2 最猛的主力)不按 PC 训练,而是按地址区域训练:它维护若干「流槽」(stream slot),每个槽跟踪一段正在向上或向下连续推进的地址区间。
触发逻辑:
- 某个 L2 缺失地址落在「活跃流槽」附近,或者连续两个缺失地址相邻(A 和 A+64),就开一个新槽;
- 之后每次同方向相邻缺失都延长这个流,预取器就提前把流前方 16~32 行(约 1~2KB)拉进 L2;
- 流槽数量有限(典型 32 个左右),新流要抢旧流的槽——这决定了 CPU 能同时「记住」多少条并发流。
stream 与 stride 的分工用一张表看清楚:
| 维度 | stride 预取器 | stream 预取器 |
|---|---|---|
| 训练键 | load PC | 地址区域 |
| 能抓的模式 | 固定步长(含负步长、非相邻步长) | 仅相邻行(±64B)连续流 |
| 适合代码 | for i: a[i*8]、AoS 隔字段、矩阵按列 | memcpy、for i: sum+=a[i]、顺序扫描 |
| 页边界 | 同样不跨 4KB | 不跨 4KB,页边界处流断掉重训 |
| 抗交织能力 | PC 天然区分不同数组,较好 | 两条交织的流各占一槽,槽不够就互相挤掉 |
最后一条值得展开。for (i) { c[i] = a[i] + b[i]; } 是三条并发流(读 a、读 b、写 c),再加上栈、代码段取指,轻松占用五六个流槽。如果你的循环里同时扫 40 个数组(列式存储的聚合查询常见),流槽不够,流之间互相驱逐、反复重训,预取覆盖率骤降——这就是为什么「超宽扫描」场景下硬件预取效果会崩,此时软件预取(_mm_prefetch)或流式存储反而更稳。
四、预取触发时序:一次预取的完整生命周期
下面这张时序图画的是一个 stream 预取请求从「L2 缺失触发」到「数据进 L2」的典型路径,以及它和被服务的需求缺失(demand miss)怎么共享 MSHR 与带宽。
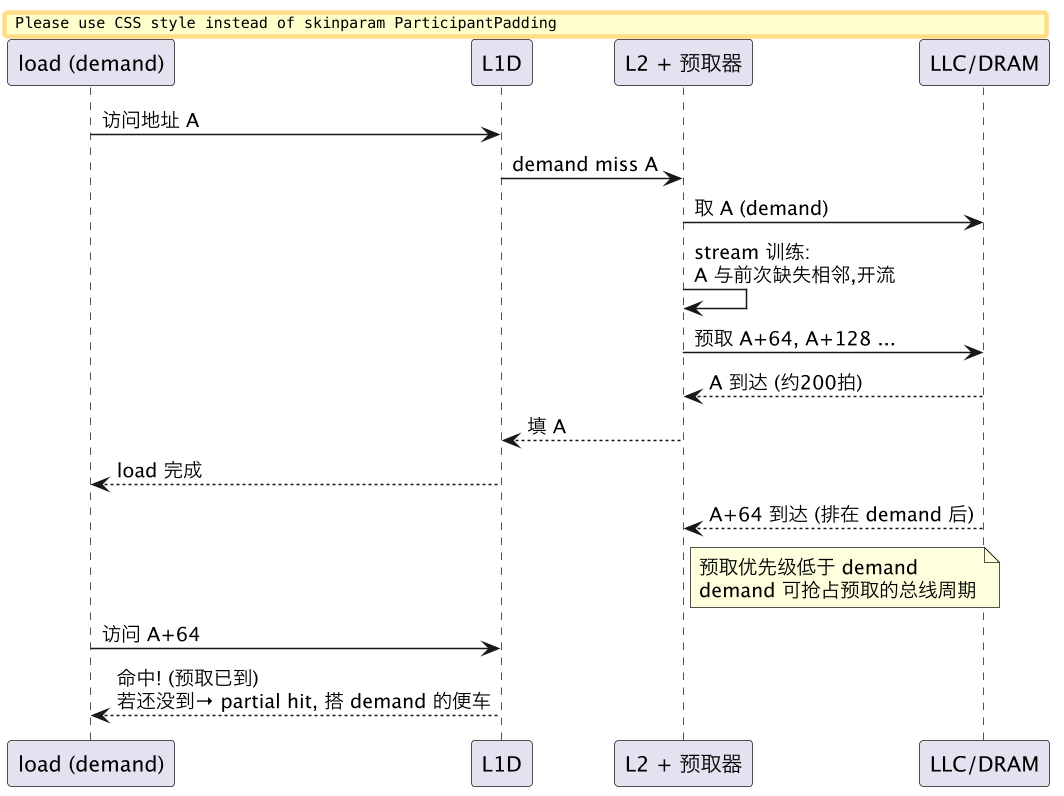
这张图里藏着预取「及时性」的全部学问:
- 太晚:demand 已经到 L2 等数据了,预取还没发出,等于没预取。此时 demand miss 与预取请求在 L2 合并成同一个 MSHR 项(partial hit),能省一点,但延迟大头没掩盖掉。
- 太早:预取距离拉得太大,数据提前 5000 拍就到了,等程序真走到那里时,这行可能已经被别的流挤出 L2——白取了,还挤掉了别人。
- 正好:预取数据在 demand 到达前一点点就绪。Intel 的调节逻辑大致是「看预取命中时数据是不是已经在缓存里等了很久」,等太久就缩短距离,不够用就拉长。
把数字摆出来更直观。假设 DRAM 往返 300 拍,循环每迭代消耗 20 拍,每个迭代触发一次缺失。预取距离 d(单位:行)能掩盖的延迟上限约为 d × 20 拍。要完全藏住 300 拍,d 至少要 15 行——但 d 拉到 15,意味着 L2 里要常年压着 15 行「还没到点」的预取数据;八路并发的流就是 120 行,占掉 L2(通常 1MB,16384 行)不到 1%,看似无害。问题在于 LLC 侧和多核:一台 32 核服务器全核跑同样的流,DRAM 控制器前排队的预取请求可达数百个,demand 的平均排队延迟被显著抬高。这就是为什么「单核跑着飞快、全核一压就垮」的负载,第一嫌疑人里永远有预取器。
五、准确度与污染:预取的账本
评价一个预取器就三个数:
- 覆盖率(coverage) = 预取消除的缺失 / 原本会有的缺失。能到 60%~90% 就是好预取器。
- 准确度(accuracy) = 被用到的预取 / 发出的全部预取。低于 50% 就要开始警惕。
- 及时性(timeliness):上面第四节讲的「不早不晚」。
准确度低带来两类实际伤害,这就是「预取污染」:
- 缓存污染:错误预取的行占着 L2/LLC 的坑,把真正有用的行挤出去。SPEC 里
libquantum、mcf这类指针追逐负载上,激进预取能让 LLC 有效容量「看起来缩水」20% 以上。 - 带宽污染:预取和 demand 抢 DRAM 带宽。带宽已经跑满的应用(比如内存数据库全表扫描),预取再多发 30% 流量,demand 排队延迟立刻上升——预取器成了自己人里的内鬼。
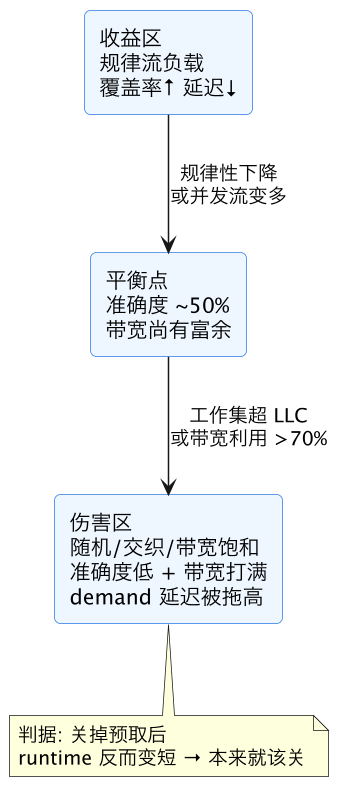
经验判据一句话:当内存带宽利用率已经超过 70%,预取器的边际收益急剧转负;而工作集远大于 LLC 的随机访问负载,预取器从第一天起就不该指望。反过来,带宽利用率只有 20%~30%、但 L2 缺失率偏高的规律流负载,是预取器的主场——此时它几乎是零成本的免费午餐,关掉反而可惜。带宽利用率本身可以用 uncore_imc/cas_count_read/ 之类 uncore 事件或直接读 PCM 工具拿到,先量带宽再做决定。
六、观测与开关:怎么量、怎么关
Intel 上直接用 perf 数:
perf stat -e \
  l2_rqsts.all_demand_miss,l2_rqsts.pf_miss,l2_rqsts.pf_hit,\
  offcore_requests.demand_data_rd,offcore_requests.l3_miss_demand_data_rd,\
  cycle_activity.stalls_l2_miss \
  ./app
看三个比值:
pf_hit / (pf_hit + pf_miss)—— 预取准确度,低于 0.5 亮黄灯;l2_rqsts.pf_miss占全部 L2 请求的占比 —— 预取吃掉的带宽份额;- 关掉预取前后
cycle_activity.stalls_l2_miss的变化 —— 终审判决。
开关方法(需要 root 或 BIOS):
# Intel: MSR 0x1a4 (MSR_MISC_FEATURE_CONTROL),4 个 bit 对应 4 个预取器
# bit0 L2 HW prefetcher, bit1 L2 adjacent line, bit2 DCU next-line, bit3 DCU IP stride
modprobe msr
wrmsr -a 0x1a4 0xf        # 全关(4 个 bit 置 1 = disable)
wrmsr -a 0x1a4 0x0        # 全开
rdmsr -a 0x1a4            # 确认
A/B 验证的正确姿势:同一台机器、同一二进制、固定 CPU 频率(关掉 turbo 或用 performance governor 锁频),只翻转 0x1a4,跑 5 次取中位数。注意这台寄存器是每核独立的,wrmsr -a 写所有核;在 BIOS 里也有对应选项(通常叫 HW Prefetcher / Adjacent Cache Line Prefetch / DCU Streamer / DCU IP Prefetcher),BIOS 设置会被锁死时 MSR 写不进去(返回 #GP),这时只能改 BIOS 重启。AMD Zen 系列没有暴露同样的 MSR 位,预取控制基本只能走 BIOS(L1/L2 Stream Prefetcher 等开关),这是两家的实际差异。
曾经见过真实案例:某 OLAP 扫描服务全关预取后 P99 延迟降了 18%——因为它的扫描宽度超过流槽数量,预取器一直在做无用训练还吃带宽;而隔壁的向量计算服务关掉预取慢了 40%,stride 模式被伺候得极好。还有一个中间态值得知道:只关 L1 侧、保留 L2 streamer,常常是收益最大、风险最小的组合——L1 预取距离短、容易污染小而宝贵的 L1D,L2 预取则藏在更大的缓存后面,容错空间大得多。没有普适答案,只有测量。
这一篇在知识体系里的位置
- 上游:缓存缺失分类与 AMAT(预取要消除的成本从哪来)、非阻塞缓存与 MSHR(预取请求的物理载体)。
- 同级总览:硬件预取器:顺序、跨步、流与相邻行预取(全部预取类型的地图)、cache-line 大小的取舍(预取粒度的根源)。
- 下游应用:cache 友好代码(怎么写出让预取器舒服的访问模式)、循环分块(把随机访问改造成 stride/stream 友好形态)、流式与非临时存储(预取帮不上忙时的旁路手段)。
总结
硬件预取器是「用带宽换延迟」的自动投机引擎:stride 预取器按 PC 给 load 地址做差分、抓固定步长,stream 预取器按地址区域跟踪连续流、提前拉 1~2KB,两者都靠缺失流喂养、都不跨 4KB 页;它的价值由覆盖率、准确度、及时性三者决定,当带宽跑满或访问无规律时预取就从加速器变成污染源——判据永远是用 perf 量准度、再用 MSR 0x1a4 做一次开关 A/B,而不是凭直觉。