L1i 与 L2 预取协调:指令预取的两级接力与分支重定向
更新时间:2026-10-06。谈预取的文章大多围着数据打转——stride 预取、stream 预取,见 硬件预取器:stride 与 stream。但指令侧的供应同样是一场与停顿的赛跑:现代核心的前端每周期要吞下十几二十字节的指令,一旦 L1i miss,取指流断粮,整个后端跟着挨饿。更麻烦的是指令访问模式比数据「跳」得多——分支、调用、返回、异常,随时把取指指针扔到另一个地址。于是 L1i 和 L2 各配了一套指令预取机制,按两级接力分工:L1i 用最简单的下一行预取兜底,L2 预取器跟踪取指足迹提前把代码拉进 L2。两级之间配合得好不好,直接决定大代码 footprint 服务(数据库、浏览器、JIT 运行时)的前端效率。本篇把这套协调机制讲透,上游见 CPU 前端流水线全景,相邻话题见 预取准确率与覆盖率度量。
本文要回答的问题
- L1i miss 的代价有多大,为什么指令侧特别怕 miss?
- L1i 下一行预取(next-line prefetch)怎么做,能盖住多少 miss?
- L2 指令预取器怎么跟踪取指流,和 L1i 预取怎么分工?
- 分支重定向之后,已经预取的行还有用吗?污染问题多严重?
一、L1i miss 的代价:前端断粮
先看为什么要专门为指令做预取。数据侧 L1d miss 的伤害是局部的:乱序窗口里其他指令还能继续执行,miss 的那条 load 在 ROB 里等数据回来就是。指令侧不一样:取指位于流水线的最上游,L1i miss 意味着后面所有阶段——译码、重命名、发射——全都没有新 µop 可喂。乱序窗口里现存的一两百条 µop 很快执行完,之后整个核心进入「空转等指令」状态。一次 L1i miss 走 L2 要十几个周期,走 L3 要四五十个周期,这些周期几乎纯损失。
真实的代码行为让问题雪上加霜。数据访问有局部性,指令访问也有,但指令的局部性经常被两件事打破:一是大 footprint——服务端应用的「热代码」动辄几 MB(解释器主循环、标准库热路径、被内联展开的业务逻辑),远超 32KB 的 L1i;二是间接跳转——虚函数调用、函数指针、switch 跳转表,把取指指针随机抛向代码段的各个角落。两者叠加,纯靠 L1i 自身容量是守不住的,只能靠预取把 miss 扼杀在发生之前。这就是 CPU 前端流水线全景 里反复强调的「前端绑定」(frontend bound)的主要来源之一,perf stat 里的 idq_uops_not_delivered 和 icache 相关 PMU 事件就是为观测它准备的。
给一个量级直觉:在 4-6 发射宽度的现代核上,一次走到 L3 的 L1i miss(约 40-50 周期)理论上浪费的发射槽位可达两百个以上,相当于几百条指令的潜在吞吐。如果 L1i miss 率达到每千条指令几次的水平,前端断粮就能吃掉两位数百分比的整机性能——这不是理论推演,大 footprint 的 MySQL、Chrome、JVM 服务的 top-down 分析里,frontend bound 占比 15-30% 是常见读数。而数据侧同等 miss 率的代价通常小得多,因为乱序窗口能掩盖。指令供应的特殊脆弱性,正是两级预取体系存在的理由。
二、第一级:L1i 的下一行预取
L1i 自己的预取机制简单到近乎朴素:取指访问第 N 行时,顺便把第 N+1 行也拉进来(如果不在的话)。这叫下一行预取(next-line prefetch),不需要任何历史表、不做任何预测,命中率依赖于「顺序代码占主导」这一事实。
朴素归朴素,效果并不差。顺序执行确实占取指流量的大头——基本块内部全是顺序的,而统计上多数分支又是不跳转的前向小分支(if 体落空的情况)。对顺序性好的代码(手写循环、扁平的热点函数),next-line 预取能盖住大部分潜在 miss;一行 64 字节约等于十几二十条指令的用量,预取提前量足够 L2/L3 的延迟被流水掩盖。成本也低:预取只是多读一行,错了大不了浪费一点带宽,不污染任何预测状态。
但它有两个结构性盲区。一是分支目标:跳转到函数入口时,目标行和它的「下一行」都还没人预取过,取指流在目标处必然要 stall 一次(除非 L2 或 BTB 导向的机制提前布防,后面讲)。二是函数调用的往返:caller 顺序流被 call 打断,callee 的代码块对 L1i 是全新的,回来时 caller 的现场可能已被挤掉。这两个盲区正是第二级机制要补的。
上图的核心信息:next-line 预取是「免费搭车」型的优化,它把顺序流上的 miss 曲线整体压低,但对跳转类断点无能为力。盲区由下一级补上。
三、第二级:L2 指令预取器的跟踪与接力
L2 侧的指令预取器站在更高的视角上工作。它能看到 L1i 和 L1d 发下来的全部请求流,从中识别「取指请求的足迹」——一串按时间排列的取指地址。基于这些足迹,L2 预取器做两件 L1i 做不了的事。
第一件是跨页/跨区域的流式跟踪。L1i 的 next-line 只管相邻行,L2 预取器(典型如 Intel 的 L2 streamer 对指令流的适配、以及专门的「取指流跟踪」逻辑)可以识别连续扫描的取指序列,一次提前拉好几行进 L2,把 L1i miss 时「L2 也要去 L3/内存取」的最坏情况消灭掉——L1i miss 到 L2 命中只要十几周期,前端断粮时间被压到可接受范围。流式跟踪还有个细节:取指流经常跨越 4KB 页边界,预取器在页边界处要么停一拍(等 TLB 确认下一页的权限),要么利用 ITLB 的 next-line 预取能力提前备好翻译——指令预取和 ITLB 预取在前端是绑在一起设计的,页边界处的卡顿是代码大页(2M 代码段映射)能减少前端停顿的原因之一。
第二件更有意思:与分支预测器/BTB 的联动。现代前端在分支预测给出目标地址后,会提前沿预测路径取指(这本身就是「预测驱动的取指预取」),L2 预取器观察到的足迹因此包含预测路径上的地址。一些设计里 L2 会对「近期被取指流指向但尚未进入 L1i 的代码区」做预取,等前端真的走到那里时,L2 里已经备好了。BTB 未命中或预测错误的重定向冲刷之后,这套机制能迅速沿新路径重新布防——这是分支重定向后恢复速度的关键。需要说明:各厂商对 L2 指令预取的实现细节披露极少,Intel 手册只确认 L2 有「同时服务代码与数据」的预取能力,具体跟踪器结构属于微架构黑盒,上面的描述是研究论文与性能实测反推出的共识图景。

上图要点:L2 预取器的信息优势是「全局」——它同时看到两个 L1(i 和 d)的请求,能做 L1 层面做不了的关联判断。两级接力的分工因此清晰:L1i next-line 负责「当下这一行旁边的一行」,L2 预取器负责「即将走到的区域」。
四、分支重定向后的预取有效性
前端流水线被分支误预测冲刷时,一个自然的问题是:之前沿错误路径预取的行怎么办,沿正确路径的预取要从零开始吗?
错误路径上预取的行不是纯浪费。它们已经进了 L1i/L2,如果之后真的被执行到(猜错的分支往往是「这次猜错、下次会走」的路径),白捡一个命中;就算永远用不上,代价也只是占了一行缓存和一点带宽——指令预取不引入任何正确性风险(预取不执行指令,不触发页错误之外的副作用),所以设计上是「激进无害」的。真正需要权衡的是缓存污染:错误路径的大段预取可能挤掉正确路径的热行。好在指令侧的污染容忍度比数据侧高——L1i 的工作集通常小于 L1d,且挤掉的行重新取回的代价只是十几周期(因为 L2 预取器在后面兜底)。
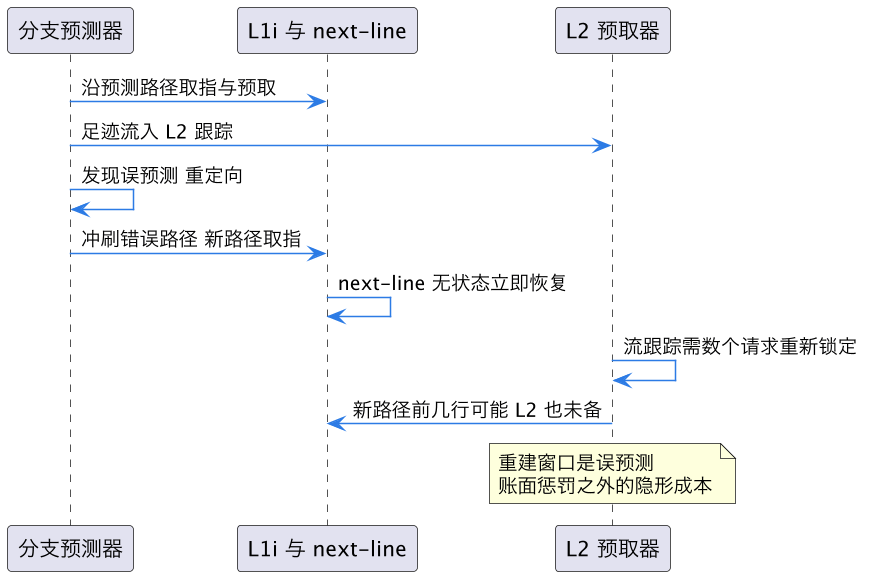
正确路径上的恢复速度取决于多快能重建预取上下文。重定向后,L1i next-line 立即在新路径上恢复工作(它无状态,天然免疫重定向);L2 预取器的流跟踪状态要几个取指请求才能重新锁定新流,这期间新路径的前几行可能裸奔到 L3。这就是为什么深流水线核心对分支误预测的真实惩罚大于「流水线深度 × 周期」的账面值——还要加上预取体系的重建窗口。
把两类重定向分开看更清楚。误预测冲刷(mispredict flush)是「走错路被发现」,上面分析的就是它;还有一类是 BTB 未命中重定向——前端压根没预测到这个分支的存在,流水线在译码/执行阶段才发现控制流要改道,这时连「沿预测路径预取」都没发生过,新路径完全是冷的,惩罚比误预测更重。间接分支(虚调用、函数指针)是 BTB 未命中的重灾区,其预测依赖专门机制,见 间接分支预测;间接跳转密集的解释器主循环因此是指令预取体系压力最大的负载形态之一——跳转不可预测意味着「预测路径布防」失效,所有供应压力都压回两级流式预取上。
五、对软件的实际意义
机制落到工程上是三条可操作的建议。第一,为前端效率做代码布局优化:热函数聚簇(PGO/BOLT 的核心收益来源)、冷代码移出热路径(__builtin_expect、-ffunction-sections 加链接脚本),本质是放大 next-line 预取能盖住的顺序流比例、压缩 L2 预取器要跟踪的 footprint。Facebook 的 HHVM 和 Google 的 AutoFDO 论文里,BOLT 后的大服务前端 stall 下降 10-20% 是常态,机制基础就在本篇讲的两级接力上。还有一个零成本的子项:别把热循环拆跨两个缓存行——编译器默认的函数/循环对齐(-falign-loops=32 之类)就是为了让热循环体完整落在一两行内,让 next-line 一次预取就备齐整个循环。
第二,观测时区分两级责任。perf stat 看 L1-icache-load-misses 高,先看代码 footprint 是否超 L2(超了是布局问题,没超是 L1i 容量/冲突问题);配合 frontend_retired 类事件能进一步区分「取了没用的带宽浪费」(预取过激)与「该取的没取」(覆盖不足),度量方法见 预取准确率与覆盖率度量。JIT 类负载特别注意:代码是运行时生成的,PGO 帮不上,热点分散在 code cache 各处,这类负载的两级预取效率天然偏低,增大 L1i 压力的同时也让 L2 预取器的流跟踪频繁失效——HotSpot/V8 的 code cache 整理(compaction)部分就是为缓解这个问题。
第三,别指望 BIOS 选项微调。数据预取器常有 BIOS 开关(DCU streamer、AMP 等),指令侧的预取多数平台不给开关,也不建议关——它的「错误代价」太低。真正可调的旋钮在软件侧:布局、footprint、分支可预测性。实验方法上有个提醒:想验证两级预取对你负载的实际贡献,不要在同一台机器上靠开关预取器对比(指令侧没开关),而是对比「布局优化前后」的前端 stall 指标变化——这正是 PGO 类工具收益的可观测部分。
这一篇在知识体系里的位置
本篇属于 microarch 层「前端与预取」专题的指令侧篇章:前端全貌见 CPU 前端流水线全景;数据侧对照见 硬件预取器:stride 与 stream(两级预取在数据侧的对应物);度量方法见 预取准确率与覆盖率度量;分支预测侧衔接 分支预测 与 BTB 分支目标缓冲。向上回到 CPU 微架构总览。
总结
指令预取是 L1i 与 L2 的两级接力:L1i 用无状态的下一行预取免费盖住顺序流,L2 预取器凭借看到全局取指足迹的信息优势做流式跟踪和预测路径布防,把 L1i miss 的代价压到十几周期;分支重定向后 next-line 天然免疫、L2 流跟踪需数个请求重建,这段重建窗口是误预测账面惩罚之外的隐形成本;软件侧最有效的配合是压缩热代码 footprint 和优化布局,让两级接力跑得顺。