存储转发(Store-to-Load Forwarding):store buffer 查询、地址模糊与转发失败
承 lsu 对 Load/Store Unit 的整体拆解,以及 data-hazards-load-store 对 load-store 数据冒险的分类讨论。存储转发是乱序执行里最「看起来理所当然、实现上处处是坑」的一环:程序语义上 load 必须读到「前面最近的同地址 store」写的值,但 store 退休了才进缓存,等它太慢——于是硬件让 load 直接去 store buffer 里把还没落盘的数据「偷」出来。这条路顺的时候只要几个周期,不顺的时候会触发整条流水线清空重来,代价堪比一次分支误预测。
本文要回答的问题
- 为什么 load 不能直接等 store 写进 L1 缓存再读?存储转发解决的核心矛盾是什么?
- load 发射后,硬件是怎么在 store buffer 里找到「那个对的 store」的?查询时序长什么样?
- 什么是地址模糊(memory disambiguation)?投机执行在 load/store 之间引入了哪些风险?
- 哪些场景转发会失败——4K aliasing、非对齐穿透、大小不匹配——各付出多大代价?
- 用 perf 能看到转发失败的痕迹吗?写代码时怎么避开这些坑?
一、为什么需要存储转发:等 store 落盘太慢
先看一段再普通不过的代码:
a[i] = x + 1;      // store:把结果写到 a[i]
y = a[i];          // load:马上又读回来
语义上,load 必须读到 store 刚写的值。问题在于 store 的「写」并不是发出去就完成了:在乱序核心里,store 指令算完数据和地址后,会被压进 store buffer(存储缓冲) 排队,等它从 ROB 退休、确认不在任何投机路径上之后,才真正写入 L1D 缓存。这个「从发射到落盘」的窗口可能是几十甚至上百个周期。
如果 load 老实等 store 落盘,上面这种「写了马上读」的模式(编译器溢出寄存器、传递数组元素、this 指针字段先写后读……遍地都是)会把流水线反复卡住几十拍。寄存器重命名能解决寄存器之间的假依赖(见 register-renaming),但内存之间的真依赖——load 读的地址正是某个在飞 store 写的地址——只有一条路:让 load 绕过缓存,直接从 store buffer 里拿数据。这就是存储转发。
一句话概括这个机制的地位:store buffer 本来是「写的暂存区」,有了转发之后它同时变成了「读的旁路数据源」——load 的地址既要去查 L1D,也要并行地去查 store buffer,两边谁有最新数据用谁的。
值得强调一个容易误解的点:转发转发的是「数据」,不是「值的所有权」。store buffer 条目依然是这条数据唯一的权威副本,缓存里那个位置的旧值在 store 退休之前一直有效——因为一旦遇到中断、异常或者分支误预测,核心要能回到「store 还没发生」的架构状态,而回滚的依据就是缓存还没被改。所以转发的本质是在「未提交的写」和「已提交的缓存」之间搭了一座只读便桥,load 从桥上抄了近路,但桥随时可以被拆掉而不留痕迹。这个「store buffer 是唯一的投机写缓冲区」的设计,也是 x86 强内存序模型能在乱序核心里成立的基础之一。
二、store buffer 长什么样,load 怎么查它
store buffer 是一个按程序顺序排队的 CAM(内容可寻址存储器,Content-Addressable Memory),每个条目大致记录:
| 字段 | 作用 |
|---|---|
| 有效位 / 完成位 | 条目是否有效;地址和数据是否都算出来了 |
| 物理地址 | store 的目标地址(部分设计还存虚拟地址位用于快速预筛) |
| 数据 | 要写入的值,以及字节使能(byte enable)掩码 |
| ROB 序号 / age | 在程序序里的位置,用于判断「谁更老」 |
| 投机状态 | 是否在未解决的分支阴影下 |
load 发射时拿到自己的地址后,拿这个地址去 store buffer 里做全相联比较——所有「比这条 load 老」的 store 条目同时比对地址。比较结果分三种:
- 无匹配:store buffer 里没有更老的同地址 store,load 走正常 L1D 路径,数据以缓存为准。
- 唯一最老匹配:找到程序序上最近的那个同地址 store,把它的数据直接旁路给 load——这就是一次成功的转发。
- 多个匹配:同地址可能写了好几次(比如循环里反复更新同一变量),选 age 上离 load 最近的那个。
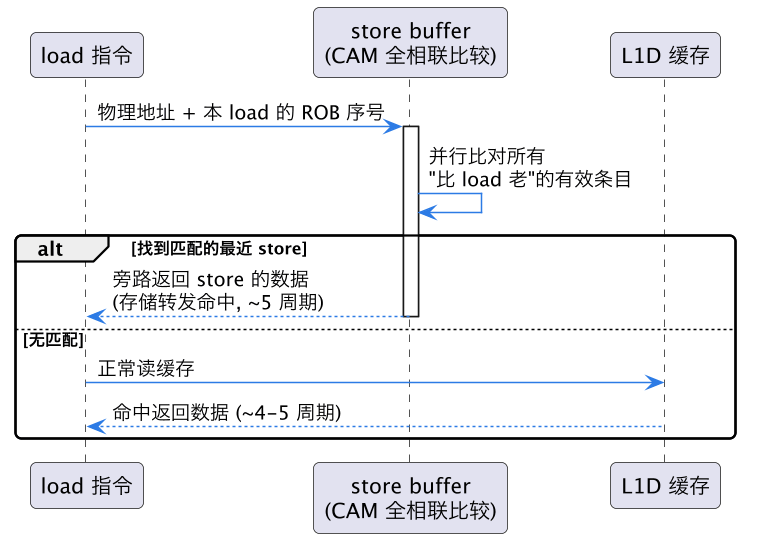
上图是转发命中时的数据通路。注意两个关键设计点:一是 store buffer 的比较必须与 L1D 访问并行进行,否则转发这个优化自己就成了关键路径;二是比较要用物理地址(或至少是页内偏移),因为虚拟地址相同的两个不同物理页(4K aliasing,见第五节)会造成假匹配。
还有一层工程约束藏在「全相联」三个字里。CAM 每一位比较都要功耗和面积,条目越多、地址位越宽,比较网络越贵。所以 store buffer 不可能做得很大——Golden Cove 一代大约 70 多个条目,Zen 4 约 64 个。条目耗尽时前端直接停发新的 store(以及很多设计里连 load 一起停),这是另一类独立的卡顿来源,本篇不展开,详见 uop-pipeline-lsu-buffers。此外比较只能针对「地址已就绪」的条目:一个 store 如果还在等基址寄存器的值,它的条目上地址字段是空的,load 查不到它——这正是下一节地址模糊问题的入口。
时序上,一次转发命中的 load 大约 5~7 个周期拿到数据,和 L1D 命中相当;而如果没有转发机制、load 被迫等 store 退休落盘,代价是几十拍起步。这就是转发存在的全部意义。
三、转发路径上的时序:从地址就绪到数据到手
把镜头拉远一点,看一条 store 和紧跟的 load 各自在时间轴上经历了什么:
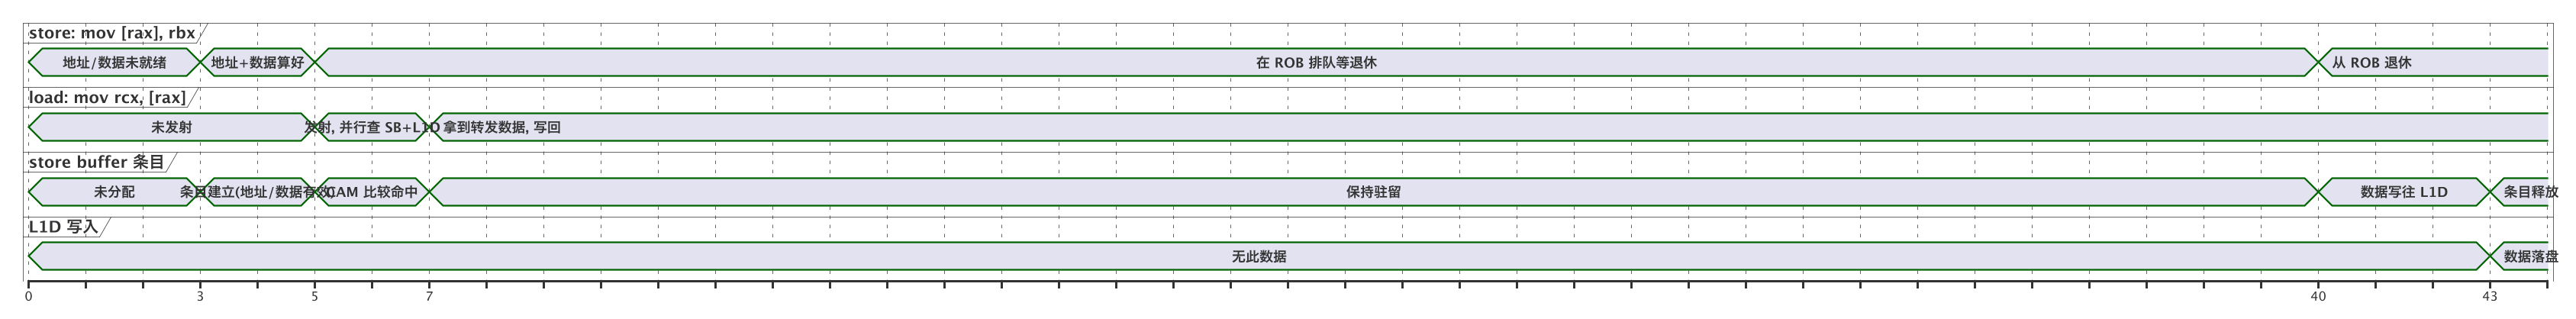
这张时序图揭示了 store buffer 条目的完整生命周期:第 3 拍 store 算好地址和数据、条目建立;第 5~7 拍 load 发射并通过 CAM 比较拿到转发数据——此时 store 还远没有退休;直到第 40 拍左右 store 退休、数据才真正写进 L1D,随后条目释放。换句话说,转发窗口横跨了「store 进入 buffer」到「store 退休落盘」之间的整整几十拍,这期间任意多条 load 都可以从这个条目里偷数据。
还有个细节:转发必须处理部分重叠。如果 store 写了 8 字节而 load 只读其中 4 字节,硬件要从 byte enable 掩码里算出 load 需要的那几个字节并正确拼出来。现代核心能高效处理「load 完全落在 store 内部」的情形;反过来「load 比 store 大、跨了多个 store」就麻烦了,见第四节。
四、地址模糊:load 到底能不能提前跑
前三节假设 load 发射时,所有更老 store 的地址都已经算出来了。现实没这么美好——乱序执行要挖并行度,load 经常需要抢在更老的 store 算出地址之前就发射。这时硬件面临一个赌博:
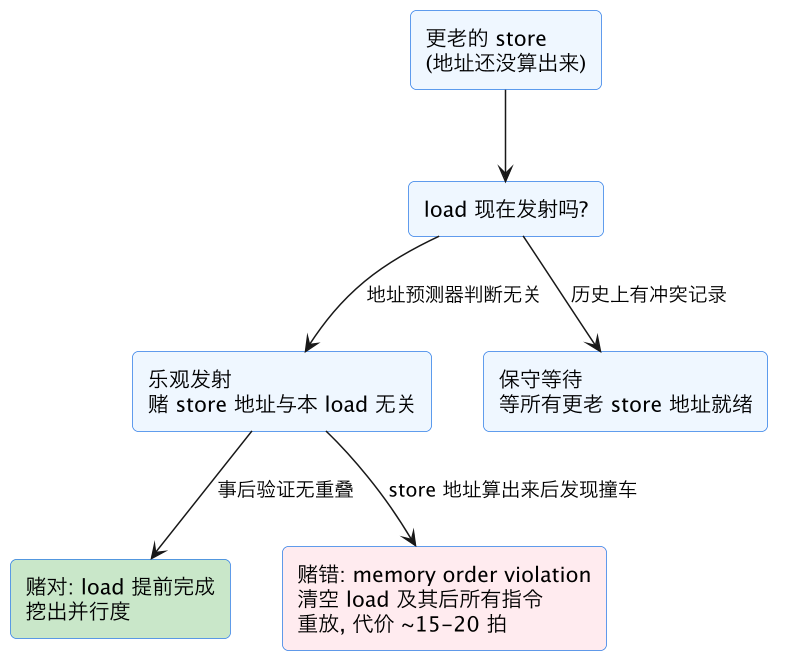
这就是**内存消歧(memory disambiguation)**问题。load 提前发射后,当那个「地址晚到的 store」终于算出自己的地址时,硬件会把它和已经执行完的年轻 load 们逐一比对。一旦发现「某个 load 读的位置其实被这个更老的 store 写过」,就是 memory order violation(内存序违例)——load 拿到了旧数据,程序语义被破坏,唯一的补救是从这条 load 开始把流水线清空(machine clear / pipeline flush),重新取指执行。这个惩罚在 Intel 核心上大约是 15~20 个周期,和一次分支误预测同量级。
为了少赌错,现代核心带有 store-load 冲突预测器(Intel 叫 memory disambiguation predictor):记住哪些 load 历史上踩过违例,下次遇到它们就强制等待更老 store 地址就绪。这让常见路径保持乐观,把反复撞车的配对降级为保守。
一个直觉性的数字可以说明这场赌博为什么值得做:典型整数程序里 load 约占指令总数的 20%~30%,其中绝大多数与在飞 store 并无冲突。如果全部走保守策略——load 一律等更老 store 地址就绪——等于把内存流水线的并行度砍掉一大截,IPC 损失远超偶发违例的清空代价。所以所有主流高性能核心(Intel P 核、AMD Zen、Apple Firestorm、ARM Neoverse)都选择了「默认乐观 + 预测器兜底」的方案,差别只在预测器的精细程度和违例清空的具体实现。
五、转发失败的几种真实场景与代价
转发不是万能的,下面这些情形要么转发不了、要么触发代价高昂的补救:
| 场景 | 发生了什么 | 代价 |
|---|---|---|
| load 大于匹配 store | store 写 4 字节,load 读 8 字节,数据凑不齐 | 转发失败,load 等 store 落盘,延迟 ~10 余拍 |
| load 跨越两个 store | 8 字节 load 一半在 store A、一半在 store B | 部分核心直接拒绝转发,走慢速拼合路径 |
| 非对齐穿透缓存行 | store 或 load 跨 64B 行边界 | 本身就有 split penalty,叠加转发失败更糟 |
| 4K aliasing | load 与无关 store 的虚拟地址低 12 位相同,被误判为相关 | 假依赖:load 被无谓阻塞 ~5 拍;或假命中后违例清空 |
| 地址模糊赌错 | load 投机发射,事后发现与晚到地址的 store 重叠 | machine clear,~15-20 拍 + 重放 |
| 自修改代码 | store 写入的地址区域正被取指 | 整条流水线清空 + 前端重启,数百拍 |
把前面几节的三种命运收成一张概念卡:一条 load 查 store buffer,结局只有命中、模糊、失败三态,各态的代价差着一个数量级。
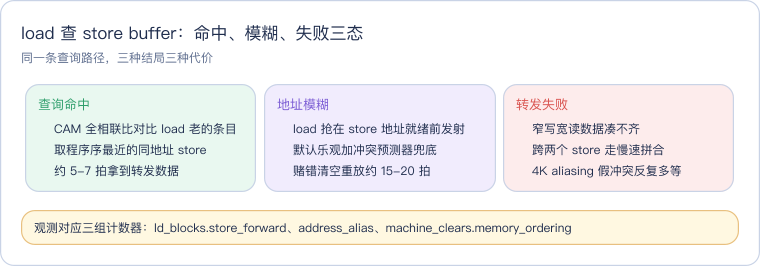
这张卡的三个分区正好对应全篇的三段叙事:第二至三节讲命中态为什么快,第四节讲模糊态为什么是一场值得的赌博,本节和上表讲失败态的三张面孔——三态共用同一条 CAM 查询路径,差别只在地址、宽度与时机,所以排查时也要按这三态去对号入座。
其中 4K aliasing 最值得单独说。硬件做 load/store 地址快速预筛时,常常只看页内偏移(虚拟地址低 12 位)——因为物理地址要等 TLB 翻译完才到手,等不起。于是两个虚拟地址低 12 位相同、实际落在不同物理页的访问,会被当成「可能相关」。典型受害者是间距恰好为 4KB 倍数的两个数组:
float a[N], b[N];           // a 和 b 恰好相差 4096 字节的倍数
for (i = 0; i < N; i++)
    b[i] = a[i] * 2.0f;     // load a[i] 与 store b[i-?] 低 12 位撞车
每一轮迭代里,load 都被硬件怀疑和前一个 store 冲突,被迫延迟验证——一个完美可向量化的循环凭空慢了几倍。修法也简单粗暴:把两个数组的间距错开一个非 4K 倍数的偏移(比如多 pad 64 字节)。
这个坑在真实工程里反复出现:图像处理里宽度恰好是 1024 或 2048 像素的行缓冲、按 4KB 对齐分配的线程局部缓冲、两个各 4KB 的 ping-pong buffer……只要「写地址」和「读地址」的差值是 4096 的倍数,就踩雷。排查特征是:代码逻辑上明明没有任何依赖,perf 却显示 ld_blocks_partial.address_alias 随迭代次数线性增长。这类假冲突和前面说的真违例不同——它不清空流水线,只是反复让 load 多等几拍做地址确认,所以表现为「稳定地慢」,而不是「偶尔剧烈卡顿」,用采样工具看热点时热点就老老实实落在循环本体上,很有迷惑性。
六、观测:用 perf 抓住转发失败
转发失败和内存序违例都有专用的 PMU 事件(以 Intel 为例):
perf stat -e ld_blocks.store_forward,\
ld_blocks.no_sr,\
machine_clears.memory_ordering,\
ld_blocks_partial.address_alias ./appld_blocks.store_forward:load 因 store buffer 里的条目无法转发而被阻塞的次数——大小不匹配、跨多个 store 这类「转发不了」都计在这里。ld_blocks_partial.address_alias:4K aliasing 造成的假冲突次数。machine_clears.memory_ordering:内存序违例引发的整机清空次数——地址模糊赌错的直接证据。
判断思路:如果 machine_clears.memory_ordering 非零且热点集中,多半存在「load 投机发射撞上晚到地址 store」的固定配对,可以调整代码让 store 的地址依赖链变短(让地址早点算出来),或干脆重排 load/store 顺序。如果 ld_blocks.store_forward 很高,检查是不是存在「窄写宽读」——比如先按字节填结构体字段、再整体按 8 字节读回来,改成写读同宽即可。
实践中一个高频的「窄写宽读」来源是序列化代码:把结构体逐字段 memcpy 或按字节写进发送缓冲,写完立刻按 8 字节指针强转读回来做校验或日志。每次「小写大读」都是一次转发失败。另一个来源是联合体(union)和类型双关——uint32_t 写入、uint64_t 读出。这类代码功能上没错,性能上每对访问都在为 LSU 的拼合逻辑交税。把它们改成「写多宽、读多宽」,或者中间隔一条对同地址的同宽 store,就能把转发成功率拉满。
这些事件也属于 ipc-bottlenecks 里「后端执行受限」类别的经典排查项,配合 uop-pipeline-lsu-buffers 对 load/store buffer 容量瓶颈的分析一起看,能区分「转发失败」和「buffer 满了」两种表象相近的卡顿:前者计数器落在 ld_blocks*,后者落在 resource_stalls.sb 一类资源停顿事件上。
这一篇在知识体系里的位置
存储转发是 LSU 内部机制的核心一环,向上向下都有明确的接续:
- 上层框架:cpu-out-of-order 给出乱序执行五大部件的全景,store buffer 是其中「内存乱序」的那一半;lsu 拆解 Load/Store Unit 的整体结构。
- 依赖视角:data-hazards-load-store 把本篇的转发/违例归入数据冒险分类体系;data-hazards 是总入口。
- 容量视角:uop-pipeline-lsu-buffers 讲 store buffer 条目耗尽造成的 stall,与本篇的「转发路径失败」互为补充。
- 纵切走读:uop-pipeline-walkthrough 里 load/store µop 走流水线的完整时序,能看到转发在整条流水线里的位置。
总结
存储转发让 load 绕过缓存、直接从 store buffer 里拿到最近同地址 store 的数据,把「写了马上读」从几十拍的等待压到约 5 拍;它的代价是全相联 CAM 查询与内存消歧的赌博——地址模糊赌错了要清空流水线重来,4K aliasing、窄写宽读、跨 store 拼合这些场景则让转发直接失败,观测上分别对应 ld_blocks.store_forward、ld_blocks_partial.address_alias 和 machine_clears.memory_ordering 三组计数器,写代码时避开 4K 倍数的数组间距、保持写读同宽,就能躲开绝大多数坑。