RAS 返回地址栈:为什么 ret 值得一个小栈专门预测
本篇是分支预测系列的纵深篇:方向预测(条件跳转跳不跳)和间接目标预测(
jmp *rax跳到哪)分别见分支预测总览与间接分支预测篇,而call/ret这一对特殊跳转由一块独立的小硬件——**RAS(Return Address Stack,返回地址栈)**专门伺候。它只有几十项容量,却能在函数调用密集的程序里把 ret 的预测准确率推到 95% 以上。错预测后的流水线冲刷见精确异常与流水线冲刷篇。
本文要回答的问题
ret本质上就是一条间接跳转,为什么不交给 BTB/间接预测器,而要专门造一个小栈?- 硬件怎么识别
call和ret并维护压栈/弹栈的配对? - 调用深度超过 RAS 容量、或者 call/ret 不配对的代码(如 setjmp/longjmp、尾调用)会发生什么?
- 为什么 Spectre 时代要发明 retpoline 把间接跳转「改道」到 RAS 上?
一、ret 为什么值得专门预测:目标是「算出来的」里最规律的
ret 在指令编码上是一条间接跳转——目标地址要从内存栈顶弹出来。按常理它该走间接分支预测器(BTB + 目标缓存)的路子。但实测数据摆在那里:间接预测器对 ret 的准确率通常只有 60%~80%,而 ret 的目标其实有着近乎完美的规律——它几乎总是等于最近一次未配对的 call 的下一条指令地址。
这就是「栈语义」:函数调用的本质就是 LIFO(后进先出)。既然软件层面已经用栈来存返回地址了,硬件完全可以在前端复制一份「影子栈」,只存返回地址、不存数据,call 时压栈、ret 时弹栈。这个影子栈就是 RAS:
- 容量极小:现代 x86 一般 16~32 项(AMD Zen 系列 32 项,Intel Golden Cove 约 16~32 项分级)
- 预测极准:配对良好的代码里准确率 95% 以上,远超通用间接预测器
- 时机极早:在译码阶段就能给出预测目标,不用等栈内存读取
换句话说,RAS 是用「识别程序结构」换「预测准确率」的典型——ret 不是普通的间接跳转,它是结构化控制流的一环,值得专用硬件。而真正的任意间接跳转(虚函数、函数指针、switch 跳转表)没有这种栈结构,只能交给 BTB,那部分的故事见间接分支预测篇。
二、call/ret 怎么被识别并配对
硬件识别配对靠的不是猜测,而是指令编码本身就带着语义标记:
| 指令 | 前端动作 | RAS 操作 |
|---|---|---|
call rel32 / call *reg | 译码即知是调用 | 把「下一条指令地址」压入 RAS,栈顶指针 +1 |
ret / ret imm16 | 译码即知是返回 | 弹出栈顶作为预测目标,栈顶指针 -1 |
| 普通条件跳转 | 方向预测器接管 | 不动 RAS |
| 间接跳转(非 ret) | BTB/间接预测器接管 | 不动 RAS |
关键点有两个。第一,RAS 的维护发生在前端译码阶段,是纯粹投机性的——此时 call 指令离真正执行还有上百拍,但预测必须现在就给,否则取指就要停。第二,硬件不验证配对是否正确,它盲目相信「call 配 ret」的软件约定,预测错了就靠后端的错预测恢复机制兜底(ROB 冲刷,机制见精确异常与流水线冲刷篇)。
图中可以看到整个数据通路:译码器每遇到一条 call 就把返回地址压进 RAS,遇到 ret 就把栈顶掏出来塞进取指目标队列,取指器下一拍直接去这个地址取指令——整个过程不碰内存、不等执行。内存里的真实调用栈只有在 ret 真正执行时才会被读出,用来校验投机是否正确,而不是用来预测。
三、溢出与错配:小栈的两个软肋
RAS 只有十几到三十几项,两个场景会让它失灵。
① 调用深度超过容量——环形覆盖。深度递归(比如解析深层 JSON、树的深度优先遍历)压到第 33 层时,最早压入的项被覆盖。栈底附近的 ret 弹出来时拿到的是错的地址,预测失败。缓解思路各家不同:Intel 在部分微架构里加了「栈底备份」,AMD 则是把容量做到 32 项。实测上,调用深度 30+ 的递归热点(如某些正则引擎、解释器)里 ret 错预测率会明显抬头,用 perf stat -e br_misp_ret 类事件(具体事件名依平台而定)可以观测。
② call/ret 不配对——软件破坏栈约定。典型场景:
setjmp/longjmp:longjmp 一次跳过多层调用,RAS 里积压的返回地址全成了「幽灵项」- 协程/用户态线程切换:手动切换栈指针,RAS 完全不知道
- 尾调用优化:
call f被编译器改成jmp f,RAS 少压一项,之后 ret 弹出的是调用者的返回地址——恰好正确!这是唯一「不配对却无害」的情形 - 异常展开(C++ exception、信号处理):跳过中间帧,RAS 栈顶与真实控制流错位
错配的代价不是正确性问题(后端会校验并冲刷),而是性能:每次 RAS 错预测都是一次 15~20 拍的前端冲刷,频繁发生时 IPC 明显下滑(观测方法见IPC 瓶颈篇)。

两类场景的共性是:RAS 是个「相信约定」的预测器,约定被破坏时它没有任何自愈手段,只能靠一次次错预测冲刷把栈顶指针「磨」回正确位置。这也是性能分析里「ret 错预测集中爆发」几乎总能追溯到这两类根因的原因。
四、投机执行侧信道视角:retpoline 与 RSB stuffing
2018 年 Spectre v2(间接分支目标注入)之后,RAS 从性能部件变成了安全攻防的主角之一。攻击面在于:RAS 和 BTB 一样是按上下文共享的预测结构,攻击者可以通过训练让 RAS/BTB 在受害者代码里投出恶意目标,在投机窗口里泄露秘密。
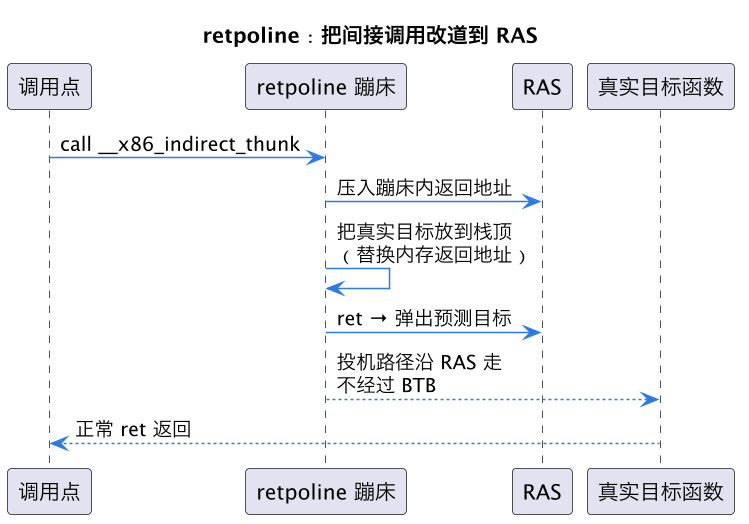
防御方则反过来利用了 RAS 的一个特性——ret 优先走 RAS 而不是 BTB。于是编译器发明了 retpoline(return trampoline,返回蹦床):把间接调用 call *reg 改写成一段「call 一个蹦床函数 + 蹦床里 ret 到真正目标」的代码序列,让间接跳转的投机路径被 RAS 接管,绕开可被注入的 BTB。这本质上是「用难注入的小栈替换易注入的大表」。
对应地,处理器厂商在 RAS 本体上也打了补丁:RSB stuffing(返回栈缓冲区填充)——在上下文切换、VM 进入等时刻,由微码/内核往 RAS 里压入一串无害地址,把攻击者训练的残留项顶掉;Intel 后续微架构还引入了硬件级的 RSB 隔离。这些机制的开销会体现在系统调用和 VM-exit 延迟上,是「安全税」里实打实的一笔。用 perf 观测时,开启 retpoline 的内核在间接调用密集路径上 cycles 会有可测的上涨。
这一篇在知识体系里的位置
RAS 是分支预测「三件套」里最结构化的一件:方向预测管条件跳转(见分支预测总览),BTB/间接预测器管任意跳转目标(见间接分支预测篇),RAS 专管 call/ret 配对。预测失败后的代价统一由乱序后端的冲刷机制承担,见精确异常与流水线冲刷篇与乱序执行总览;错预测对 IPC 的量化影响见IPC 瓶颈篇,实测工具见 perf。
总结
RAS 返回地址栈是一块只有 16~32 项的前端影子栈,靠「call 压栈、ret 弹栈」的 LIFO 约定把 ret 预测准确率推到 95% 以上——它赌的是软件遵守调用约定;深度递归撑爆容量、longjmp/协程破坏配对时,它就会连续错预测,靠流水线冲刷硬磨回来;而 Spectre 之后,retpoline 和 RSB stuffing 又让这个小栈成了投机执行攻防的主战场。