用户态中断投递:UINTR 绕过内核的中断机制、SENDUIPI 指令与 IPC 加速场景速查
更新时间:2026-10-05。传统 IPC 通知路径上,内核是绕不开的中间人:写一个 eventfd、发一个信号,都要经历系统调用进内核、内核找到目标进程、再等到目标被调度时投递。Sapphire Rapids 引入的 UINTR(User Interrupts,用户态中断)把这条路拉直了:发送方在用户态执行一条指令,硬件直接把中断投递给目标 CPU 上正在运行的目标线程,全程不进内核。本篇是 CPU 微架构总览 视角下的速查篇,讲清投递机制、涉及的数据结构与适用场景;IPC 路径本身的瓶颈分析见 IPC 瓶颈。
本文要回答的问题
- 用户态中断投递相比信号和 eventfd,到底省掉了哪几段开销?
- UPID 和 UITT 两张表各记什么?SENDUIPI 一条指令背后硬件走了哪些步骤?
- 接收方要怎么注册处理程序?和信号处理函数的写法有何不同?
- 哪些场景真的能用 UINTR 提速,哪些场景碰了反而更糟?
一、为什么需要绕过内核的通知
先看传统通知路径的账单。以 eventfd 为例:发送方 write 进内核(一次系统调用约 100 到 300 周期起步),内核唤醒等待队列上的线程(触发一次调度),接收方被调度后 read 再进一次内核把事件取走。信号更贵:内核要把信号挂到目标的 pending 队列,等目标从内核态返回用户态时才发现它、切栈、执行信号处理函数,整个延迟在微秒量级,还伴随一次栈切换和 sigreturn 系统调用。在低时延框架里,这些开销叠加在本来就只有几微秒的请求处理周期上,非常刺眼,这正是 低时延模式 里反复讨论的问题。
用户态中断投递的目标就是砍掉这段:通知不再经过内核调度与投递队列,而是由硬件在目标线程正运行的 CPU 上直接「插一脚」——打断当前执行流,把 RIP 压栈后跳到接收方预先注册的处理程序,处理完一条 uiret 返回被打断的位置。从发送方一条指令到接收方处理程序开始执行,理论延迟压到百纳秒级。
| 通知机制 | 发送路径 | 接收路径 | 典型延迟 | 需要内核参与 |
|---|---|---|---|---|
| eventfd | write 系统调用 | 调度 + read | 数微秒 | 收发都要 |
| 信号 signal | kill/tgkill 系统调用 | 返回用户态时投递 + sigreturn | 数微秒 | 收发都要 |
| futex 唤醒 | futex(FUTEX_WAKE) | 调度 | 数微秒 | 收发都要 |
| UINTR | SENDUIPI 一条指令 | 硬件直接打断当前线程 | 百纳秒级 | 仅注册时 |
表里可以清楚看到 UINTR 的位置:它不是比某个机制「快一点」,而是把收发两侧的系统调用和调度环节整体删掉了。代价是要先做一次性的注册设置——内核的角色从「每次投递的搬运工」变成「开局时的登记员」。
二、投递机制:UPID、UITT 与 SENDUIPI 的完整链路
用户态中断投递依赖两张由内核维护、硬件直接读取的表。
UPID(User Posted Interrupt Descriptor,用户投递中断描述符)是「每个接收线程一份」的投递信箱,128 字节,必须放在不可换出的内存里。里面有三样东西:一个 64 位的投递中断请求位图(PIR,每位对应一个中断向量)、通知控制字段(记录目标线程当前在哪个 CPU 上运行、是否处于可被立即打断的状态)、以及一个「待处理通知」标记。接收线程每次被调度上 CPU,内核会更新 UPID 里的 CPU 号——这一步是 UINTR 依然需要内核的地方:它得跟踪线程迁移。
UITT(User Interrupt Target Table,用户中断目标表)是「每个发送方一份」的地址簿。发送方要向某个线程发中断,必须先从内核拿到一个 UITT 表项(通过 uintr 相关的系统调用注册对端),表项里记录了目标 UPID 的物理地址、目标向量号和一个有效性标记。发送方对表项只有索引权,看不到物理地址本身,这保证了一个进程不能随便向系统里任意线程打中断——能发给谁,是内核授权的。
上图是 SENDUIPI 背后的完整链路。发送方执行 senduipi <uitt_index>,硬件做的事依次是:拿索引查发送进程的 UITT,验证表项有效,按表项找到目标 UPID 并把对应向量位置进 PIR,然后看通知控制字段——如果目标线程此刻正在某个 CPU 上运行,硬件向那个 CPU 发一条特殊的用户 IPI(处理器间中断),目标核在当前指令边界处识别出这是用户态中断,不走 IDT(中断描述符表),直接把控制流切到接收方注册的处理程序;如果目标线程被换出了,就只置一个待处理标记,等内核下次把它调度回来时顺手投递。也就是说,「目标正在跑」是快路径,「目标睡着」会退回接近调度延迟的慢路径。
三、接收方一侧:注册与处理程序
接收线程要先向内核注册一个用户态中断处理程序(uintr handler),内核把入口地址记进该线程的上下文,并给它分配一个用户态中断向量。处理程序的执行环境和信号处理函数有本质区别:它不在独立的信号栈上跑、不经过内核跳板(trampo 和 sigreturn 那套),就是硬件压了 RIP 之后直接跳转,退出用 uiret 指令恢复原执行点。这让它足够轻,但也意味着处理程序里能安全做的事比信号处理函数更受限制——你在一个完全异步、可能打断任意临界区的位置执行,传统上推荐的写法是只置一个标志位或往无锁队列里推一个通知就返回,真正的活交给主循环,思路和 SPSC/MPSC 队列 的「通知与数据分离」一致。
配套的用户态指令有一小组:clui 关用户态中断(清 UIF 标志)、stui 开、testui 测试并置 CF,uiret 返回。这组指令给接收方提供了非常便宜的「屏蔽窗口」——进入临界区前 clui,出来 stui,成本是普通寄存器操作,比 sigprocmask 系统调用便宜三个数量级。发送方不屏蔽任何东西,发送永远只是一条 senduipi。
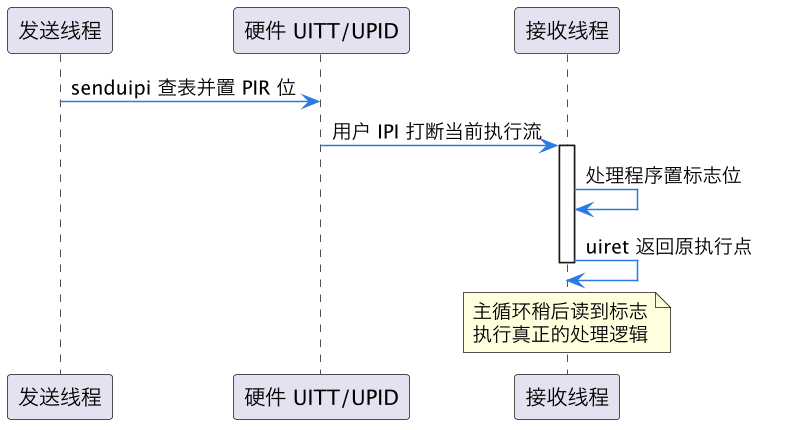
上图把一次投递的交互压缩成三步:发送方一条指令、硬件查表投递、接收方处理程序快进快出。注意处理程序和主循环的分工——中断里只做最小通知,这是用 UINTR 不踩雷的第一原则。
四、适用场景与坑
真正能从用户态中断投递里赚到钱的场景,画像是这样的:两个(或少量)长期绑定在固定核上的线程,高频互发通知,且通知语义简单(「队列里有新东西了」「该切换阶段了」)。典型例子是用户态运行时里的跨核任务窃取唤醒、用户态网络栈(DPDK 类)中协议线程与应用线程之间的通知、以及把内核旁路做到极致的 RPC 框架。这类场景里,把每次通知从数微秒压到百纳秒,直接反映为尾延迟下降和核间流水更紧。
反过来,以下情况碰 UINTR 多半得不偿失。一是目标线程经常处于睡眠态——快路径的前提是目标正在 CPU 上跑,睡着的线程投递延迟退回调度延迟,还不如老老实实 futex。二是通知语义复杂、需要携带数据——PIR 只是一个位图,能表达的只有「某向量被触发」,数据还得走共享内存,那么通知本身是不是 UINTR 往往不再是瓶颈。三是可移植性有要求:UINTR 只在 Sapphire Rapids 及之后的服务器 CPU 上有,/proc/cpuinfo 的 flags 里找 uintr;内核支持(uintr 系统调用接口)随 6.x 后期版本逐步合入,部署前要逐项确认。四是调试成本:异步打断任意执行点的处理程序,出问题时栈回溯和复现都比信号路径更难。
工程上的折中方案也值得一提:不少框架把 UINTR 当成「忙时加速器」——目标线程近期活跃就用 senduipi,发现它睡了就退回 eventfd 或 futex。两条路径共用同一套共享内存数据结构,只在通知动作上切换,兼顾快路径延迟与闲时省电。
这一篇在知识体系里的位置
本篇是 microarch 层「核间协作与通知」专题的速查页,横向对照 IPC 瓶颈(传统路径的开销账)和 KPTI 与 PCID 的微架构成本(系统调用本身为什么贵)。向上回到 CPU 微架构总览,向应用层延伸到 低时延模式 与 SPSC/MPSC 队列——UINTR 解决的是这些无锁队列「通知」这一半的开销,数据那一半还是共享内存。
总结
用户态中断投递(UINTR)把进程间通知从「系统调用 + 内核调度 + 内核投递」压缩成发送方一条 SENDUIPI 指令加硬件一次直达打断:内核只在注册时建 UPID 信箱和 UITT 地址簿,之后收发全程绕开内核,延迟从微秒级降到百纳秒级——它只适合目标线程高频在线、通知语义简单的核间协作场景,线程睡着或语义复杂时,传统 futex 和 eventfd 依然是更稳的选择。