DSA 与 IAA 片上加速器:ENQCMD 提交接口与 memcpy 压缩卸载的适用边界
更新时间:2026-10-03。CPU 微架构总览 把核心内部的流水线讲了一遍,AMX 矩阵扩展 那篇讲的是「挂在核心流水线上的指令级加速器」。本篇换一个视角:DSA(Data Streaming Accelerator,数据流加速器)和 IAA(In-Memory Analytics Accelerator,内存分析加速器)不是核心的执行单元,而是挂在芯片内部互连上的独立硬件引擎,核心把活儿「寄」给它们就去干别的,干完了再来收结果。这种「提交-完成」的异步卸载模型,接口设计和适用边界与指令级加速完全不同。
本文要回答的问题
- DSA 和 IAA 各自加速什么,它们和 AMX、AVX 这类指令级扩展的本质区别是什么?
- ENQCMD 指令和描述符环是怎么把一份「工作单」交给硬件引擎的?
- 为什么小尺寸 memcpy 用 DSA 反而更慢,拐点在哪里?
- 什么负载值得卸载到 IAA 做压缩/解压,什么是它干不了的?
一、DSA 与 IAA 是什么
DSA 从 Sapphire Rapids 开始集成在至强芯片上,专职做「搬数据」:内存到内存拷贝(memcpy)、内存填充(memset)、比较、CRC、以及配合持久内存的缓存行刷写。IAA 同代登场,面向分析型负载:压缩/解压(兼容 DEFLATE 语义和自己的原语)、过滤、扫描、解包——可以理解为一个硬件化的「行存/列存处理加速器」。
和 AMX、AVX-512 的关键区别在执行模型:AMX 的 TILELOADD 还是核心流水线里的一条指令,占用核心的发射口和乱序窗口;DSA/IAA 则是 PCIe 设备形态的引擎,核心写好一份描述符、敲一下门铃,引擎自己通过 DMA 搬数据,核心可以同时跑别的代码。代价是每次卸载有固定的提交与完成开销——这就引出了全篇的核心矛盾:异步卸载省的是核心时间,花的是固定延迟,活儿必须足够大才划算。
二、工作提交路径:ENQCMD 与描述符环
DSA/IAA 的用户态接口是 idxd 驱动加 libaccel-config 管理的「工作队列」(work queue)。队列分两种:专用队列(DWQ)给一个进程独占,共享队列(SWQ)被多路复用。对性能分析最重要的是共享队列的提交机制,因为它用到了一条特殊指令 ENQCMD。
整个提交过程分四步。第一步,软件在内存里填好一个 64 字节的描述符:操作码(拷贝还是压缩)、源地址、目的地址、长度、完成记录地址。第二步,核心执行 ENQCMD 指令,把这份描述符以一次原子写投递到设备的「门户」(portal,一段映射到用户态的设备寄存器窗口)。ENQCMD 的精髓在于它是原子的且带排序语义,多个线程往同一个门户投描述符不需要软件锁。第三步,硬件引擎从门户取走描述符,自主发起 DMA 读写。第四步,引擎写完成记录(completion record)到内存,并可选择触发中断或 MSI;软件轮询完成记录里的状态字节即可知道活儿干完没有。
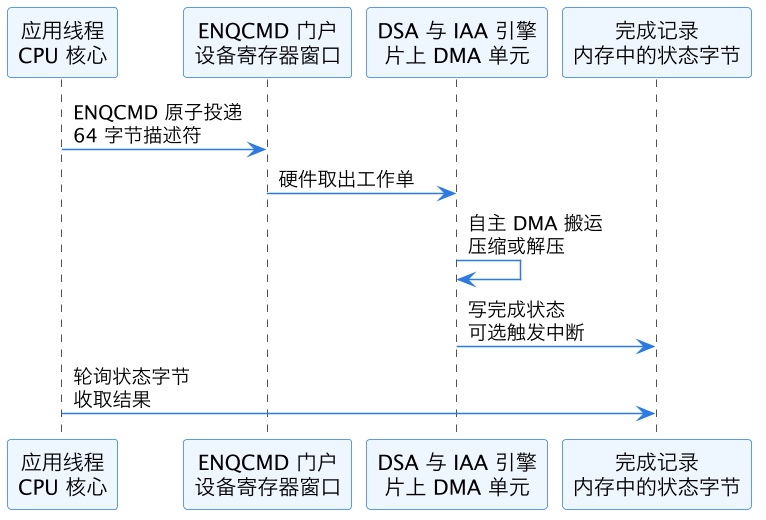
上图是共享队列的完整提交时序。注意两个性能要点:其一,ENQCMD 是同步指令,但工作本身是异步的——指令返回只代表「硬件签收了」,不代表「活儿干完了」;其二,提交方要自己去轮询完成记录,轮询太晚浪费延迟,轮询太勤烧核心,这个节奏要按批量大小调。
描述符本身也要进缓存,所以高吞吐场景的常见做法是一次准备一批描述符、循环 ENQCMD 投递、最后统一收完成记录,摊薄每单的提交成本。
三、memcpy 卸载的适用边界
「硬件拷贝肯定比软件快」是最常见的误判。真实数据恰恰相反:小块拷贝,软件完胜;大块拷贝,才轮到 DSA。
原因是一笔账。软件 memcpy 走的是 AVX-512 加载存储,数据本来就在核心缓存附近时,1KB 的拷贝只要几十个周期,且没有同步开销。而一次 DSA 卸载的固定成本包括:填描述符(几十周期)加 ENQCMD 一次设备写(通常数百纳秒级别的往返)加完成轮询。业界实测的拐点大致在 2KB 到 8KB 之间——低于这个尺寸,ENQCMD 的门铃开销比拷贝本身还贵。
那 DSA 的价值在哪?三个场景。
第一,超大块拷贝。几十 KB 到几 MB 的 memcpy,软件做会把 L1/L2 甚至 LLC 冲一遍,污染调用者的工作集;DSA 走 DMA 且可以用非时间性路径绕开缓存,核心缓存干干净净。配合 cache 伪共享与缓存行 那类问题的思路看,本质是「不让搬数据这件事干扰计算本身的局部性」。
第二,拷贝与计算重叠。提交完描述符核心立刻返回,引擎搬数据的同时核心继续算——这对「先搬再算」的串行代码是白捡的并行度。
第三,卸载内存带宽竞争。多核同时做大拷贝时,DSA 引擎内部的调度比一堆核心互相抢内存控制器更有序,这和 DRAM 控制器调度 里讲的请求重排是同一层逻辑。
| 场景 | 推荐手段 | 理由 |
|---|---|---|
| < 2KB 拷贝 | 软件 AVX | ENQCMD 固定开销压不住 |
| 2KB-8KB | 看数据在不在缓存 | 拐点区,实测决定 |
| > 64KB 大块 | DSA | 避免缓存污染,核心让出来 |
| 拷贝后可重叠计算 | DSA | 异步并行白捡 |
| 延迟敏感的热路径 | 软件 | 完成轮询增加尾延迟 |
四、IAA 压缩解压的边界
IAA 的账比 DSA 更绕,因为压缩是计算密集操作,软件本来就很贵。
压缩侧:IAA 的硬件 DEFLATE 压缩比大致对应 zlib 等级 1 到等级 2 的水平——速度极快(单引擎数 GB/s)但压缩率平庸。如果你的场景是日志、备份这类「压得差不多就行、吞吐优先」的负载,IAA 是神器;如果追求极限压缩率,软件的 zstd 高等级或 xz 仍然赢,IAA 干不了「用更多 CPU 换更高压缩率」这件事。
解压侧:这是 IAA 最甜的点。DEFLATE 解压的软件实现通常只有几百 MB/s 每核,IAA 单引擎能到数 GB/s,而且几乎不占核心。分析型数据库扫压缩列存、kafka 消费者解压缩消息,这类「解压是吞吐瓶颈」的管道值得优先卸载。
过滤与扫描原语是 IAA 相对 DSA 的独有项:硬件可以直接做「按谓词过滤行、抽出选中字段」这类操作,省掉把全量数据搬进核心再逐行判断的开销。但要注意,这些原语是固定功能的——谓词一复杂(比如需要正则、需要跨行状态),就回到软件。
最后别忘了 虚拟化与 IOMMU 开销 那条线:虚拟机和容器里用 DSA/IAA 要经过 SIOV 与共享队列,提交路径上多一层地址转换,拐点会向「更大的块」方向移动,裸机测出来的阈值不能直接套。
五、落地检查清单
综合上面的边界,评估一段代码要不要卸载到 DSA/IAA,按顺序问四个问题。
单次操作的尺寸是否超过拐点?小活别碰硬件引擎。提交后有没有别的活可以干?纯串行等结果时,卸载只省缓存污染这一项。数据结构是否匹配原语?IAA 的过滤是固定模式,逻辑复杂就白搭。完成等待的成本谁付?延迟敏感路径上,轮询完成记录的尾延迟可能比软件执行本身更难看。
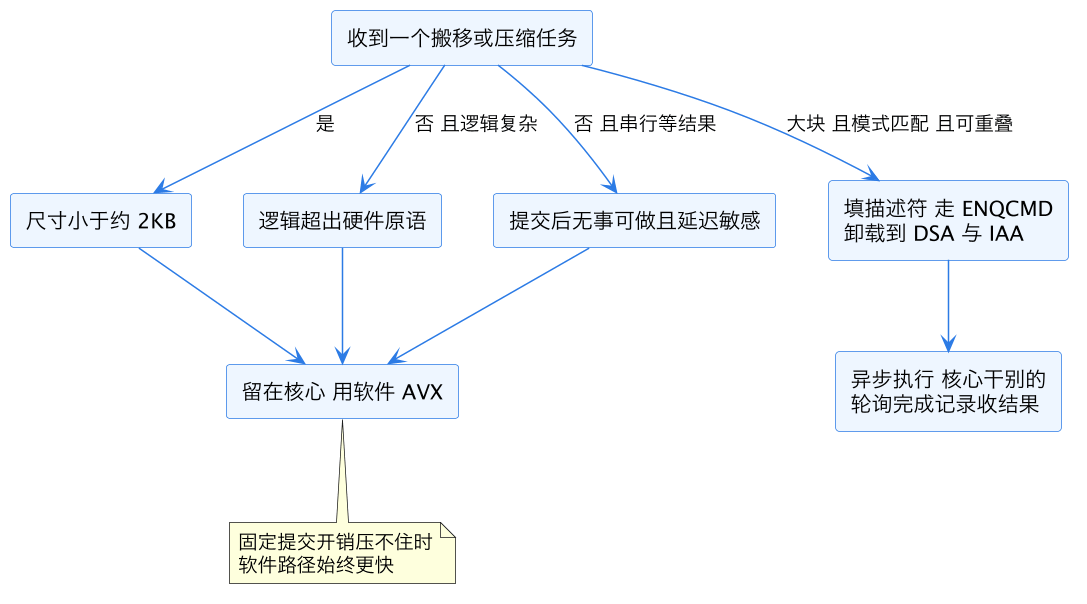
上图是决策流程:先量尺寸,再看逻辑是否落在硬件原语内,最后看提交后能不能并行。三个筛子都过了才值得走 ENQCMD 这条路,任何一个不过,软件路径都是更优解。
总结
DSA 与 IAA 是以 PCIe 设备形态挂在芯片互连上的异步加速引擎:软件填 64 字节描述符、用 ENQCMD 原子投递到门户、轮询完成记录收结果,提交有数百纳秒级固定成本;所以 memcpy 卸载的拐点在 2KB 到 8KB,只有大块拷贝、可重叠计算、避免缓存污染这三类场景才划算,IAA 则在高吞吐低压缩率压缩与解压、固定模式过滤上是神器,但做不了高压缩率与复杂谓词——一句话,活儿要够大、模式要匹配、提交后要有事干,三者缺一就留在核心用软件做。