Rowhammer 硬件防御:TRR 刷新加固与攻击检测计数器的微架构实现
更新时间:2026-10-05。DRAM 的容量每代翻番,靠的不是把单元做得更聪明,而是把单元做得更小、行与行挤得更近——这恰好给了一种「隔着一行就能改写你数据」的攻击留出了物理通道。Rowhammer 自 2014 年公开以来,把「内存位翻转只是硬件可靠性问题」的共识彻底改写成了「攻击者可以用软件手法批量制造位翻转」。防御的第一代答案是 TRR(Target Row Refresh,目标行刷新):在内存控制器或 DRAM 芯片内部给「疑似被锤的行」的邻居补发刷新。本篇讲透 Rowhammer 的物理机理、TRR 及其变体的微架构实现、攻击检测计数器怎么设计、加固带来的性能开销,以及 TRRespass 等研究如何绕过这一代防御。DRAM 的 Bank/行/列组织见 DRAM 子系统组织,常规刷新机制的背景见 DRAM 刷新管理。
本文要回答的问题
- Rowhammer 的位翻转是怎么来的?为什么「读自己旁边的行」能改写别人的数据?
- TRR 目标行刷新在内存控制器和 DRAM 芯片里分别怎么落地?
- 行激活计数器如何设计?采样、阈值与「漏检窗口」之间怎么权衡?
- 加固刷新吃掉多少内存带宽与能耗?对延迟有什么影响?
- TRRespass、Half-Double 这类研究为什么能绕过 TRR?下一代防御往哪走?
一、Rowhammer 机理:DRAM 单元的「串扰」如何从缺陷变成武器
DRAM 的一个 bit 就是一个电容加一颗访问晶体管,电容里的电荷表示 0 或 1。这个电容天生漏电,所以必须周期性地刷新——这就是 DRAM 刷新管理 讲的那套 tREFI 周期的由来。问题在于,激活(activate)一行要把整行读进行缓冲(row buffer),这个动作会在相邻行的字线(wordline)上感应出电压扰动,加速相邻行电容的电荷流失。正常访问频率下,流失量远小于刷新周期能兜底的量,不会有事;但如果程序在两次刷新之间反复激活同一行几十万次,相邻行的电荷流失就会累积到越过判决门限——比特在没有被「写」的情况下自己翻了。
这就是 Rowhammer:攻击者不需要任何写权限,只要能以足够高的频率读(激活)「攻击行」(aggressor row),就能让物理上相邻的「受害行」(victim row)里的比特翻转。如果受害行里恰好放着别人的页表项、SSH 公钥或者 JavaScript 对象的类型字段,翻转一个比特就是提权。
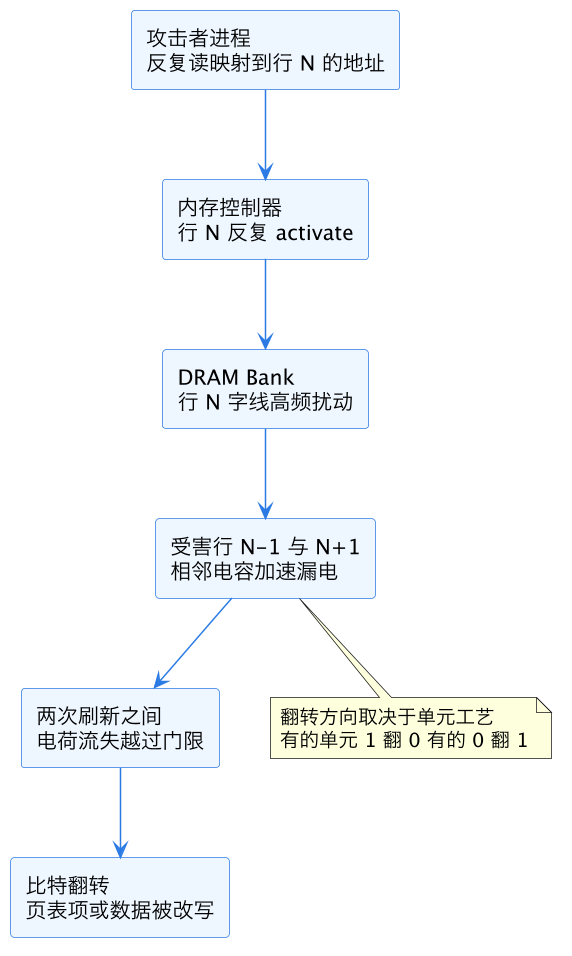
上图里有两个工程上很关键的细节。第一,翻转是「相邻行」受害,所以攻击效果对 DRAM 的行映射(物理地址到 Bank/行/列的打散规则,见 DRAM 子系统组织)极其敏感——攻击者要先逆向映射关系才能精确锤到目标的邻居。第二,翻转有方向性:某些工艺节点下单元只会 1→0,某些只会 0→1,攻击者据此挑选目标数据摆放方式,让单个翻转恰好落在「权限位」这种语义关键比特上。
要把 Rowhammer 从「理论缺陷」变成「稳定利用」,攻击侧要过三关:绕过缓存(用 clflush 或 eviction set 把读请求真的打到 DRAM)、逆向行映射(用 Bank 冲突时序侧信道探)、把受害页摆到攻击行旁边(内存喷射加页去重或 ballooning)。防御侧对应地也有三条路:不让翻(ECC 纠错)、不让锤这么快(性能计数器限流)、锤了也白锤(TRR 刷新加固)。前两条治标不治本,硬件层的主防线就是第三条。
二、TRR 刷新加固:给「疑似受害行」补发额外刷新
TRR 的思路很直接:既然位翻转的根源是「激活次数太多、正常刷新间隔太长」,那就监控每一行的激活频率,一旦某行被激活得「太勤快」,就主动把它的两个邻居刷新一遍,把漏掉的电荷补回去。这相当于把「受害行」的刷新周期动态缩短了,让电荷流失永远到不了门限。
TRR 的实现位置有两代路线,差别很大:
| 维度 | 控制器侧 TRR(pTRR,伪 TRR) | DRAM 内 TRR(in-DRAM TRR) |
|---|---|---|
| 实现位置 | 内存控制器逻辑 | DRAM 芯片内部(厂商自定义) |
| 可见性 | 微码/固件可审计 | 黑盒,算法不公开 |
| 计数器规模 | 受限于控制器面积,常采样 | 每 Bank 若干计数器 |
| 灵活性 | 可更新策略 | 固化在芯片里,错了没法修 |
| 典型应用 | 早期服务器平台、部分 LPDDR | DDR4 主流、LPDDR4 |
控制器侧的实现通常叫 pTRR:MC(Memory Controller,内存控制器)维护一张小表记录「最近被频繁激活的行」,表项满了就用 LRU 之类的策略淘汰。一旦某行激活次数越过阈值,控制器在合适的时隙插入两条额外的 activate+precharge(等价于一次刷新)给 N-1 和 N+1 行。DRAM 内的 TRR 则把这套逻辑下沉到芯片:DDR4 芯片里有一组厂商自定义的计数器和「目标行寄存器」,控制器只需要发出某种信号(比如特定的 MRS 模式寄存器写或刷新命令序列),芯片内部自己挑受害行刷新。
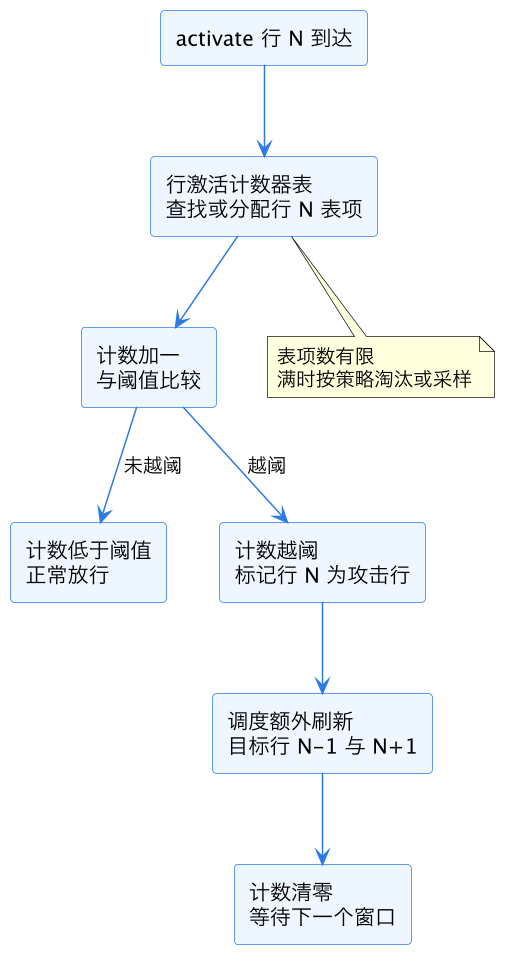
上图是 TRR 判定的核心数据通路。注意「额外刷新」不是免费的:一次 activate+precharge 占用 Bank 数十纳秒,这段时间 Bank 不能服务正常读写。如果攻击者故意把大量行激活到接近阈值但不到阈值,TRR 不触发、攻击照锤;如果阈值定得太低,正常负载(比如流媒体顺序扫描)也会频繁触发额外刷新,白白烧带宽。这个两难就是下一节计数器设计的主战场。
三、攻击检测计数器:采样、阈值与漏检窗口的三角权衡
TRR 的有效性完全押在「计数器能不能在两次刷新之间数清每一行的激活次数」上。问题是:一颗 DIMM 有十几万行,给每行配一个计数器在面积上是灾难。真实实现只能妥协,妥协的方式决定了防御的盲区。
第一代做法(早期 pTRR 和多数 in-DRAM TRR)是「有限表项 + 精确计数」:比如每 Bank 只跟踪 16 到 32 个最热的行。跟踪表满了以后新激活的行要么被忽略,要么按概率替换掉某个旧表项。攻击者只要把攻击行分散到超过表项容量的数量上(比如同时锤 40 行),就能让所有攻击行都进不了表——这就是后来 TRRespass 利用的「多行锤击」(many-sided hammering)的物理基础。
第二代做法是「采样计数」:不按确定性规则跟踪,而是以概率 p 对激活事件采样进表。只要攻击行激活得足够频繁,它被采到的概率就趋近 1;正常行激活稀疏,被误采的概率低。学术界的代表是 ProbTRR、Graphene 这类设计——Graphene 用 Misra-Gries 频繁元素算法,理论上可以证明「任何激活次数超过阈值的行必然在表里」,代价是表项数与「阈值/总激活数」成反比,阈值越低表越大。
| 设计 | 计数方式 | 漏检条件 | 硬件代价 |
|---|---|---|---|
| 有限表项精确计数 | 确定性跟踪最热行 | 攻击行数超过表容量 | 小(几十表项) |
| 概率采样 | 按概率入表 | 短窗口内低频锤击 | 小 |
| Misra-Gries 频繁元素 | 可证明无漏检 | 无(给定阈值下) | 中(表项随精度增长) |
| 每行计数 | 全量精确 | 无 | 不可接受 |
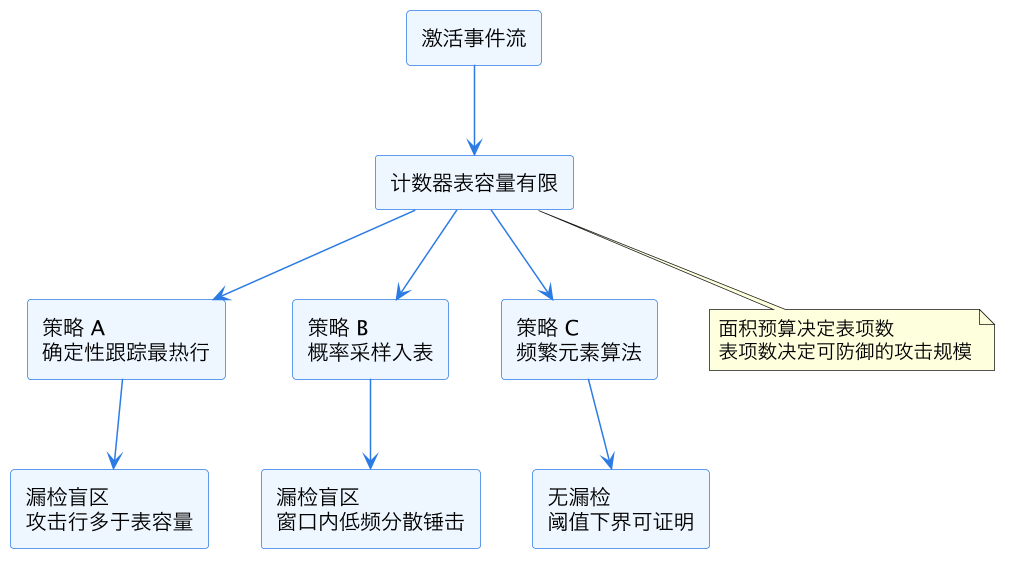
上图把三类计数策略和它们的盲区摆在一起看:确定性策略输给「数量压倒」,采样策略输给「频率稀释」,只有带理论保证的频繁元素算法在给定阈值下没有漏检——但它对「阈值必须高于正常负载的激活频率」这一前提没有帮助。阈值本身才是最难调的参数:定高了,Half-Double 这种「锤第二近邻行、靠两级耦合慢慢渗透」的低强度攻击能磨过去;定低了,数据库扫描、视频解码这类合法的高局部性负载会被误判。
还有一个常被忽略的维度:计数窗口必须和刷新周期对齐。电荷流失是否累积到翻转,取决于「两次刷新之间」的累计激活数,所以计数器必须在每个 tREFI 边界清零或衰减。如果窗口对齐做错了(比如攻击者卡在窗口边界两侧各锤一半),即使无限表项也会漏检——这就是「双窗口攻击」,也是很多学术原型在真实控制器上失效的原因之一。
四、性能开销:加固刷新吃掉多少带宽
Rowhammer 硬件防御不是免费的,开销来自三处:计数器表的面积与功耗、越阈时的额外刷新命令、以及额外刷新挤占 Bank 造成的延迟毛刺。
面积和功耗那笔账相对清楚:每 Bank 几十个计数器、每个十几位宽,对现代 MC 来说可以忽略;真正的开销在运行时。设阈值为 T(每 tREFI 窗口内允许的激活次数),攻击或误报触发时每次要补 2 个邻居行的刷新,各占约 40 到 50 纳秒的 Bank 占用。如果触发率是 r(每窗口触发的行数),额外带宽开销大致是 r × 2 × tRC / tREFI 的比例。对正常负载,r 应当接近 0,开销近乎零;但对被攻击的系统,TRR 触发本身就是攻击造成的「性能税」——攻击者锤得越狠,系统越慢,这本身构成一种拒绝服务。
学术评估里常见的数字是:在规范化的正常负载混合上,设计良好的 TRR 类方案开销在 1% 以内;攻击期间额外刷新可能吃掉 10% 以上的 DRAM 带宽。更隐蔽的是延迟毛刺:额外刷新插进来时,正在等这个 Bank 的读请求要多等一个 tRC,尾部延迟(p99)会明显变差,对延迟敏感的在线服务能感觉到。
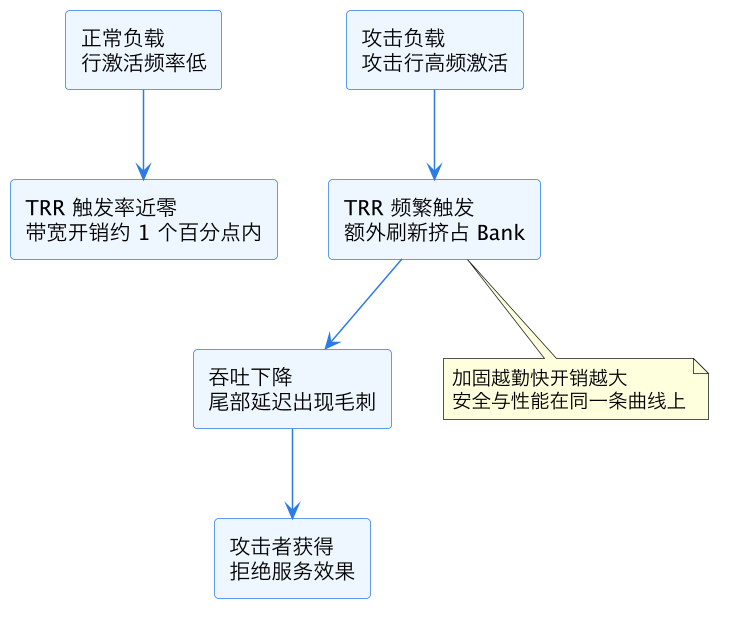
上图点出了 TRR 的结构性尴尬:防御动作的成本由攻击者的行为驱动。这和 ECC(固定开销)或加密内存(固定开销)完全不同——TRR 的开销曲线是攻击者可控的。工程上的缓解是把阈值和额外刷新做成速率受限的(rate-limited),宁可偶尔漏锤也不能让加固刷新打爆带宽,但这又回到「漏检窗口」的权衡。
五、绕过研究:TRRespass、Half-Double 与 TRR 的失守
2020 年的 TRRespass 是 TRR 防御的分水岭。研究者用软件手段逆向了多家厂商 DDR4/LPDDR4 芯片内部的 TRR 行为,发现它们普遍只跟踪极少的行(最少到 1 到 2 个)。于是攻击不再锤 2 行夹 1 行,而是同时锤十几行——每一行的激活频率都被摊薄到「不值得进表」的程度,但物理上相邻的受害行承受的是所有攻击行扰动的总和,翻转照样发生。在受测的 42 根内存条里,13 根能被多行锤击穿,其中不乏宣称「Rowhammer-free」的型号。
2021 年的 Half-Double 更进一步:不再依赖「紧贴受害行」的第一近邻,而是锤第二近邻行,利用 Rowhammer 效应在距离上的残余耦合,配合第一近邻行作为「传导体」把扰动接力到目标。这把 TRR「只刷最近邻两行」的几何假设也打破了——要防 Half-Double,刷新半径得扩到两行以外,开销跟着翻番。
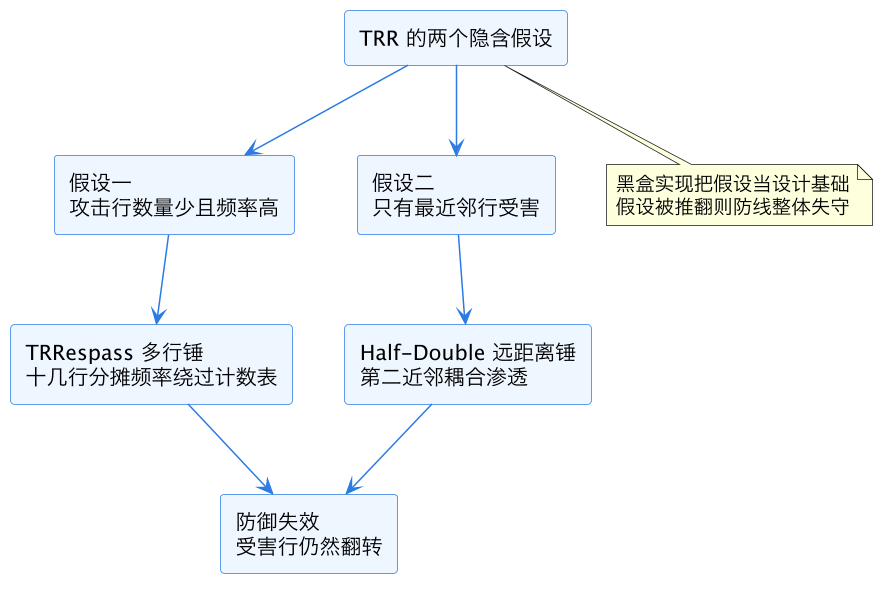
上图概括了这轮攻防的教训:TRR 的失败不是「参数没调好」,而是两个隐含假设——攻击必然集中、受害必然紧邻——都被证伪了。黑盒实现让情况更糟:系统厂商和研究者无法审计 DRAM 内部 TRR 的真实行为,只能用破坏性测试去猜。业界的回应分两层:DDR5 把刷新管理做成了标准化的一等公民(RFM,Refresh Management 命令,控制器定期发 RFM 给 DRAM 让芯片内部补刷,并且 per-DRAM 计数激活次数上报),把「是否加固」的主动权从黑盒里拿回到控制器手里;学术侧则转向带理论证明的方案(Graphene、Hydra 这类「可证明无漏检」的计数结构)和「每行少量元数据」的低成本设计。
对性能工程师来说,这个领域的实操结论是三条。第一,买内存时别信「TRR 防护」四个字,DDR4 时代它就是黑盒抽奖;DDR5 的 RFM 才是可验证的加固。第二,如果负载对尾部延迟敏感,要在压测里加「邻居行高频访问」场景,观察 TRR/RFM 触发对 p99 的影响——这和测 DRAM 刷新管理 里 tREFI 调优的毛刺是同一套方法论。第三,Rowhammer 不是一次性修完的漏洞,它是 DRAM 缩小的物理宿命,每代工艺都要重新评估翻转阈值(近年新颗粒的翻转阈值已从十几万激活降到一万以内),防御参数必须跟着代际滚动。
这一篇在知识体系里的位置
本篇是微架构安全专题里「内存侧」的一篇,向上承接 DRAM 基础两文——组织结构见 DRAM 子系统组织、刷新机制见 DRAM 刷新管理;横向和瞬态执行防线(Spectre 与 Meltdown 瞬态执行原理)、控制流防线(CET 影子栈与 IBT)并列——那两篇防的是「预测器和控制流被骗」,本篇防的是「存储介质本身被物理撬动」。三者合起来构成现代 CPU 与内存系统的硬件安全地基。
总结
Rowhammer 硬件防御的核心是 TRR 刷新加固:用行激活计数器盯住被高频锤击的行,在两次正常刷新之间给它的邻居补发定向刷新;但有限计数表与「最近邻受害」的几何假设先后被 TRRespass 多行锤和 Half-Double 远距离锤击穿,说明真正的防线必须建立在「可证明无漏检的计数结构」与「可审计的标准化刷新管理(DDR5 RFM)」之上,而这道防线在带来近乎零常态开销的同时,也把「攻击驱动的加固带宽开销」和尾部延迟毛刺留给了每一个内存系统的性能工程师。