ENQCMD DSA 提交路径:一条指令把描述符送进加速器的用户态之旅
承 onchip-accelerator-dsa-iaa 对 DSA/IAA 这两颗片上加速器的整体介绍,以及 movdiri-movdir64b-direct-store 对 direct store 指令家族的拆解。加速器再好,工作得先「递进去」才有意义——传统设备靠系统调用 + 内核驱动 + 门铃写,而 DSA 把整条提交路径压缩成了用户态的一条指令:ENQCMD。本篇就把这条 ENQCMD DSA 提交路径从指令语义一直拆到硬件队列内部。
本文要回答的问题
- ENQCMD 和 ENQCMDS 两条指令分别干什么?和 MOVDIR64B 是什么关系?
- 一个 DSA 工作描述符(descriptor)里到底装了哪些字段?
- 专用工作队列(DWQ)与共享工作队列(SWQ)在提交路径上差在哪?
- ENQCMD 的「返回状态」为什么是 ZF 标志位?失败了该怎么重试?
- PASID 与地址转换在提交路径的哪一环起作用?
一、为什么提交路径值得单独一篇
传统 PCIe 设备的提交路径大致是:用户态 write()/ioctl() → 内核驱动拼描述符 → 写设备 MMIO 门铃寄存器 → 设备 DMA 取描述符执行。每一次提交都要过一趟系统调用,上下文切换加驱动锁,万级 QPS 以下无所谓,到几十万次/秒就是纯开销。
DSA(Data Streaming Accelerator,数据流加速器)从第四代 Xeon(Sapphire Rapids)开始集成在 CPU 封装内,它的设计目标恰恰是高频小任务卸载——内存拷贝、memcmp、crc、delta 编码这类几十微秒就能跑完的活。如果每次提交还要进内核,加速省下的时间全赔在提交上了。于是 Intel 把门铃写直接做成了用户态指令:ENQCMD(Enqueue Command),一条指令 = 64 字节描述符 + 通知硬件,零系统调用、零驱动介入。
这就是 ENQCMD DSA 提交路径的核心命题:提交成本从「一次系统调用(约 1-2 微秒)」降到「一条指令(几十纳秒级)」。代价是编程模型变了——权限检查、地址转换、队列管理这些原来内核帮你做的事,现在以 PASID、共享队列、描述符字段的形式下沉到了提交路径本身。量级感受一个数字:一次 ioctl 往返在空载机器上也要 1.5 微秒上下,而一条 ENQCMD 在队列有空位时大约只占 50-100 个核周期(折合 20-50 纳秒),两个数量级的差距——省出来的预算对小任务卸载就是生与死的区别。
二、ENQCMD 指令与描述符格式
ENQCMD 的语法很朴素:
enqcmd [rdi], rsi ; rsi 指向 64 字节描述符,rdi 是队列的门铃 MMIO 地址它做的事可以拆成两半:
- 读:从
rsi指向的内存读入 64 字节的工作描述符——这一步是普通的 cacheable load,描述符可以事先在普通堆内存里填好。 - 写:把这 64 字节以不可缓存、不可拆分的 direct store 方式写到
rdi指向的 MMIO 地址——这就是工作队列的「门铃 + 数据口」二合一寄存器。写成功的一刻,硬件就知道新任务来了。
第二步和 movdiri-movdir64b-direct-store 讲的 MOVDIR64B 是同一个微架构机制:64 字节写直达、保证原子性(硬件要么看到完整描述符要么看不到),不会被拆成两个 32 字节的事务。所以 ENQCMD 常被描述成「MOVDIR64B 的特权封装版」——语义上确实如此,区别在 ENQCMD 会做额外的权限与队列状态检查,并通过 EFLAGS 的 ZF 位返回成败。
ENQCMDS(S = Shared)是它的姊妹指令,专用于共享工作队列,提交时硬件会从描述符里取 PASID 字段而不是用当前线程隐含的 PASID。两条指令的选择完全由队列类型决定,后文展开。
64 字节描述符的关键字段(简化版):
| 字段 | 字节 | 作用 |
|---|---|---|
| opcode | 1 | 操作类型:memcpy/memmove/memcmp/crc/delta… |
| flags | 3 | 完成记录写回、中断请求、fence 等控制位 |
| completion_addr | 8 | 完成记录的写回地址(用户态轮询它就知结果) |
| src_addr / dst_addr | 8+8 | 源/目的虚拟地址(硬件经 PASID 转译) |
| transfer_size | 4 | 搬运字节数 |
| priv / pasid | 4 | ENQCMDS 用的 PASID 字段 |
注意两个事实:一是地址字段写的是虚拟地址,加速器拿到后经 IOMMU(以 PASID 为键)转译成物理地址——这条转译链路与 iommu-smmu-translation-path 讲的是同一套机制,只是发起方从 DMA 设备换成了片上加速器;二是完成通知是硬件写回一个 completion record 到内存,用户态轮询或阻塞在这块内存上拿结果,整个闭环同样不需要内核。
三、提交路径全景:从填描述符到完成记录
把上面的零件串起来,一条完整的 ENQCMD DSA 提交路径长这样:
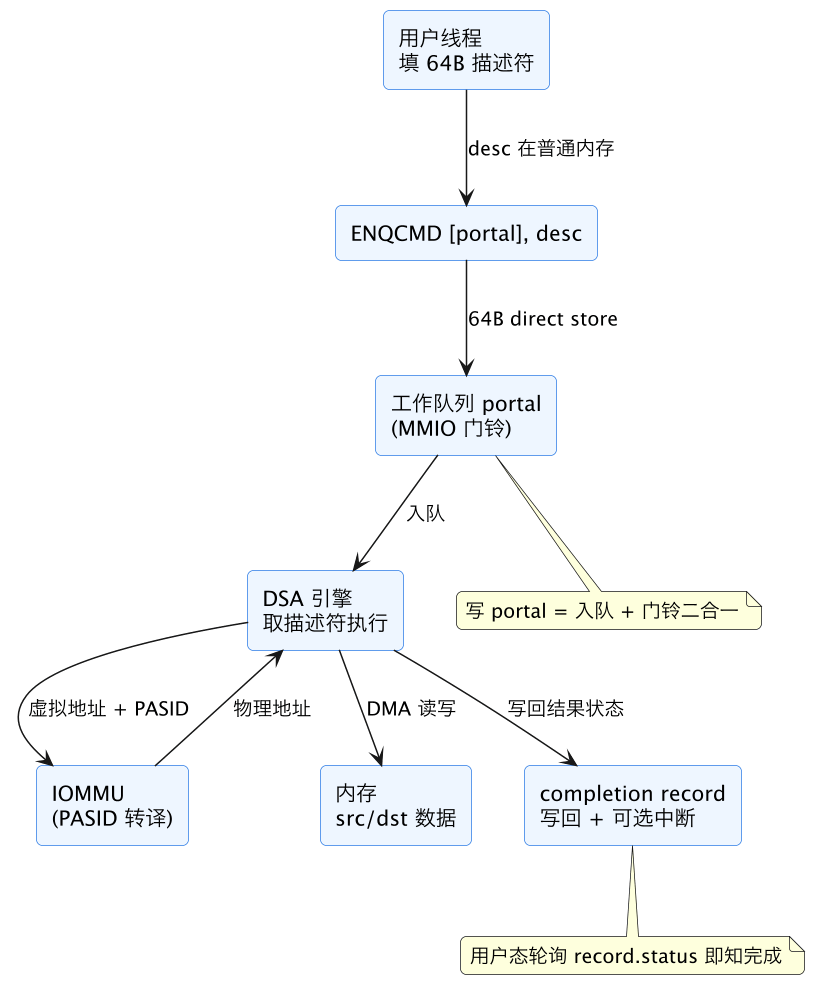
这张图里最容易被忽略的是 portal(门户)这个角色:每个工作队列在 MMIO 空间有一个 portal,ENQCMD 的目的操作数就是它的地址。写 portal 这一个动作同时完成了「递交描述符」和「按门铃」——传统设备里分开的两步(写队列内存 + 写门铃寄存器)被合并成一次 64 字节原子写,这正是提交路径能压缩到纳秒级的关键。
对应的内核侧准备(一次性,不在热路径上)是 IDXD 驱动的事:枚举 DSA 设备、配置工作队列、把队列的 portal 通过 mmap() 映射到用户进程地址空间、为进程绑定 PASID。热路径上内核完全出局——这也是它和 ioctl 提交模型的本质分界。
四、DWQ 与 SWQ:队列类型决定提交语义
DSA 的工作队列分两种,提交路径的指令、并发模型、隔离性全部由此分叉:
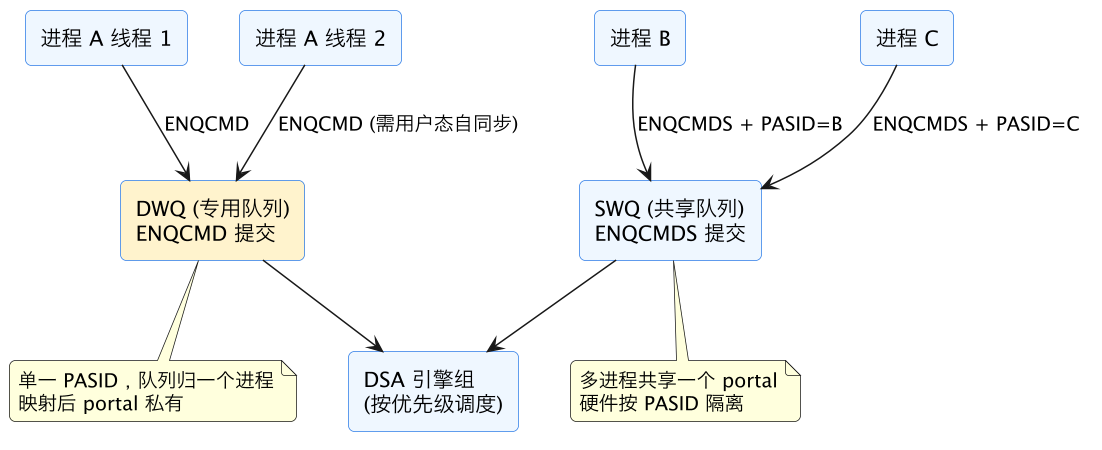
DWQ(Dedicated Work Queue,专用工作队列) 在配置时绑定一个 PASID,映射给单个进程独占。用普通 ENQCMD 提交,硬件信任「portal 属于谁,描述符就是谁的」,不再逐项检查 PASID。适合单进程高吞吐场景——比如 DPDK 风格的专用拷贝线程。缺点是多线程并发提交同一个 DWQ 时,描述符的构造与 ENQCMD 之间要用户态自己加锁或做 per-thread 描述符池,否则两个线程的描述符会互相覆盖。
SWQ(Shared Work Queue,共享工作队列) 被多个进程共享,用 ENQCMDS 提交,描述符里显式带 PASID 字段,硬件按 PASID 做地址空间隔离和记账。代价是共享 portal 本身成了竞争点:ENQCMDS 是单指令原子提交,不会出现描述符撕裂,但队列满时所有租户一起被拒。SWQ 的正确打开方式是多进程公平共享 + 队列深度容忍瞬时拒绝。
一个容易踩的坑:SWQ 的吞吐上限并不只由引擎算力决定,portal 的 MMIO 写带宽同样会饱和。实测单队列在数十万到上百万次提交/秒区间就会出现拒绝率抬头——这种时候扩容方向是「多配几个队列」而不是「往一个队列里使劲塞」。
五、ZF 标志位:提交是「请求」,不是「保证」
ENQCMD 最反直觉的设计是它的返回方式——不走寄存器返回值,而是设置 EFLAGS 的 ZF(零标志):
- ZF=0(指令执行后 ZF 清零):描述符已被硬件接受入队。
- ZF=1:提交被拒绝,典型原因是队列满(或门户暂时不可用),描述符没有入队,需要重试。
用 C 内联汇编读 ZF 的惯用法:
static inline int enqcmd(void *dst, const void *src)
{
    unsigned char retry;
    asm volatile("enqcmd (%0), %1\t\n"
                 "setz %2"
                 : "+r"(dst), "+r"(src), "=q"(retry)
                 :
                 : "memory");
    return retry;   /* 1 = 被拒,需重试 */
}
这个设计的理由很硬核:提交结果必须在指令退出前确定,而指令本身不写通用寄存器(保持和 MOVDIR64B 类似的微码路径),FLAGS 是最便宜的通道。带来的编程纪律是——每一次 ENQCMD 都必须检查 ZF,队列满不是异常是常态,高负载下拒绝率可以很高。正确姿势是退避重试(_mm_pause() 自旋几轮再试,或 fallback 到软件 memcpy),不是当错误处理。漏掉这一步检查是最常见的接入事故:描述符静默丢失,上游还在等一个永远不会写回的 completion record,表现为「偶发请求超时且无任何错误日志」,查起来非常痛苦。
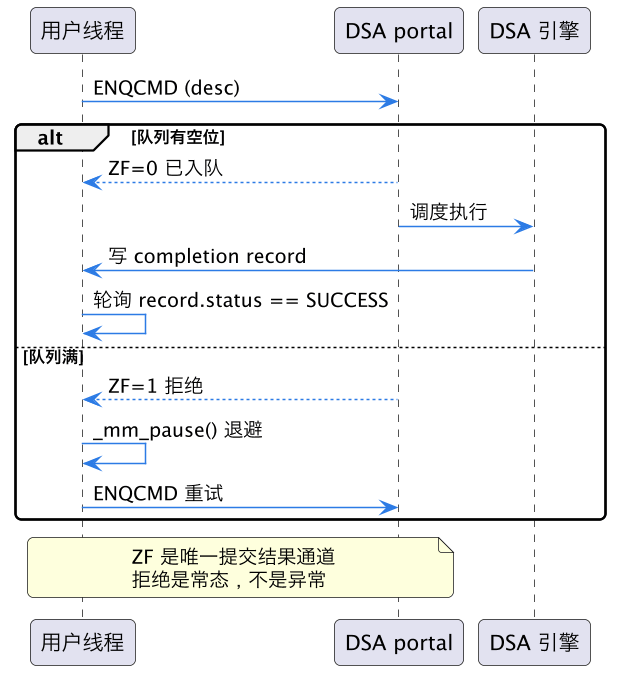
上面这张时序图强调一个顺序事实:completion record 的写回发生在引擎执行完之后,与入队成功之间隔着排队和执行两段延迟。所以「ENQCMD 返回 ZF=0」只说明任务被受理,离结果可用还有一段——典型的 memcpy 卸载在小块(几 KB)时端到端延迟在数微秒量级,其中排队占大头,这正是 SWQ 高负载下要盯的指标。
六、completion record:闭环的另一半
提交只是路径的前半程,拿到结果才算闭环。DSA 的完成通知机制同样为「不进内核」而设计:描述符的 completion_addr 字段指向一块用户态内存(通常 32 或 64 字节一条 record),引擎执行完后由硬件直接 DMA 写回,内容包含状态码(成功、页错误、引擎错误等)与操作相关的附加数据(比如 memcmp 的差异位置、crc 的计算值)。
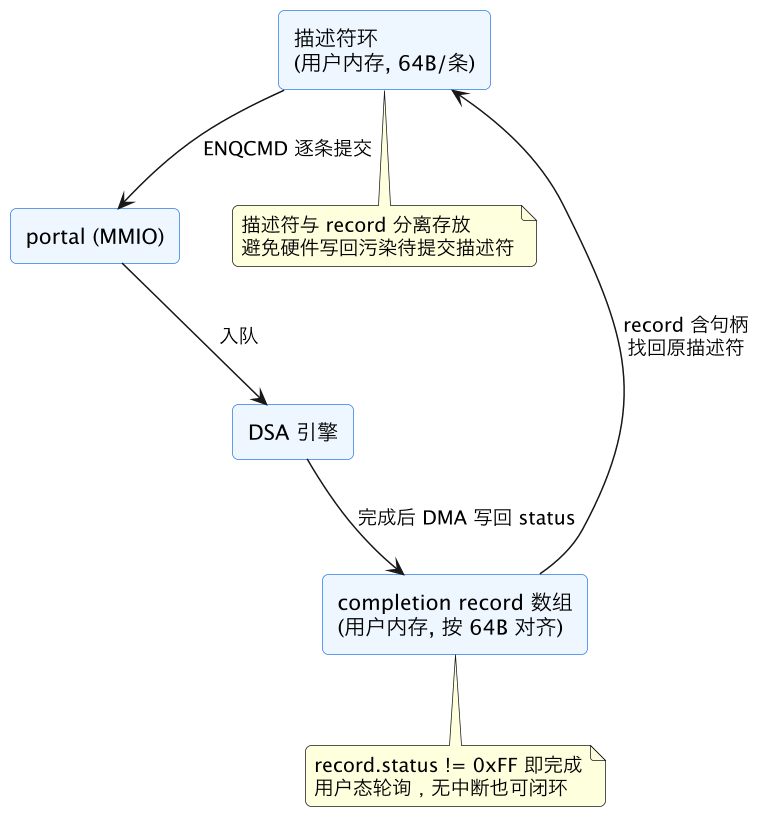
这张图里的布局要点是描述符区与完成记录区分开:描述符是 CPU 写、硬件读的共享数据,record 是硬件写、CPU 读——混在一个缓存行区域里会造成双向的缓存行乒乓,高并发下白白吃掉几十纳秒的往返。工程上的标准做法是给每个提交上下文配一对「描述符池 + record 数组」,record 首字节预置 0xFF 作为「未完成」哨兵,轮询读到非 0xFF 即完成,轮询循环里插 _mm_pause() 降低流水线冲刷开销。
批量场景还有一个省指令的技巧:一次循环里连续对同一 portal 发多条 ENQCMD 是完全合法的(每条都是独立原子写),描述符池预填好后提交循环可以跑到每几十纳秒一条的速率;真正限制批量提交深度的是队列容量——队列塞满后 ZF=1 出现,此时继续猛发只会加剧拒绝,聪明的做法是「提交到拒绝即停,转去收割 completion,再回来补投」,让提交与收割在同一个循环里交替推进。
错误路径也别忽略:描述符里填了未映射的虚拟地址,ENQCMD 本身不会失败(入队成功,ZF=0),错误在执行期才暴露——引擎经 IOMMU 转译失败,最终落成 record 里的 fault 状态码。如果队列配了中断,IOMMU 还会产生 fault 事件进内核日志。所以「ENQCMD 成功 ≠ 任务成功」这条纪律要刻在调用方心里,状态判断一律以 completion record 为准。
七、性能视角:什么时候值得走这条路
把账算清楚,ENQCMD DSA 提交路径的优势区间其实很明确:
| 维度 | ENQCMD 用户态提交 | ioctl 内核提交 |
|---|---|---|
| 单次提交成本 | 几十 ns(一条指令) | 1-2 μs(系统调用+驱动) |
| 权限检查时机 | 一次性(队列配置时绑 PASID) | 每次提交 |
| 地址转换 | IOMMU 按 PASID,用户态直写虚拟地址 | 驱动 pin 页 / 拷内核缓冲 |
| 并发模型 | DWQ 单进程 / SWQ 多进程硬件隔离 | 驱动锁串行化 |
| 失败处理 | ZF=1 用户态退避重试 | 返回 -EBUSY |
阈值经验值:单任务体量在几 KB 以上、每秒提交数万次以上时,省下的系统调用开销就足以让 DSA 卸载跑赢纯软件 memcpy(尤其大块拷贝时 DSA 还不占核内缓存与流水线资源,核可以腾出来干别的)。反过来,如果任务很小(几十字节)或提交频率很低,ENQCMD 的 MMIO 写延迟(几十纳秒到百纳秒级,portal 在 uncore 侧,要等核外互连一个往返)相对任务本身占比太高,老老实实用 rep movsb 或 AVX 拷贝更划算——加速器不是免费的,提交路径再短也是一次核外往返。还有一个隐性收益常被漏算:DSA 搬数据走自己的 DMA 通路,被拷的源和目的缓存行不会进执行核的 L1/L2,对缓存敏感的业务(比如转发面的流表)相当于白捡了一层缓存污染防护。
工程落地时还有三条实操建议:一是描述符和 completion record 都要按 64 字节对齐且避免多个 record 共享一条缓存行(否则硬件写回会造成无谓的行迁移);二是 DWQ 场景给每个提交线程配独立的描述符池,杜绝「填到一半被别的线程 ENQCMD 掉」;三是线上监控拒绝率(ZF=1 占比)和 completion 延迟分位数,这两个数比「加速器利用率」更早暴露队列配置问题。
这一篇在知识体系里的位置
本篇是 onchip-accelerator-dsa-iaa 的提交路径专题,direct store 指令机制详见 movdiri-movdir64b-direct-store,描述符地址转译依赖的 IOMMU/PASID 机制见 iommu-smmu-translation-path;加速器与内存子系统的交互背景可回到 memory-hierarchy-latency-bandwidth-panorama。
总结
ENQCMD DSA 提交路径把「递任务给加速器」压缩成用户态的一条指令:填好 64 字节描述符,enqcmd [portal], desc 一次原子写完成入队加门铃,ZF 标志位返回成败,PASID 负责地址隔离,completion record 写回负责结果通知——DWQ 用 ENQCMD 求独占吞吐,SWQ 用 ENQCMDS 求多租户共享,ZF=1 退避重试是日常而不是错误,这条路径让高频小任务卸载第一次真正跑赢了系统调用。