内存 RAS 机制:ECC 纠检错、patrol scrubbing 与 rank sparing 的完整链路
更新时间:2026-10-05。DRAM 颗粒不是理想的存储介质:宇宙射线打进来会翻转一个比特,颗粒老化会让某个 cell 稳定地读错,温度过高会让保持时间缩短、刷新跟不上。桌面机遇到这种事大不了蓝屏重启,服务器不行——一台数据库机器的内存里躺着别人几个亿的交易流水。于是服务器内存子系统发展出一整套 RAS(Reliability, Availability, Serviceability,可靠性、可用性、可服务性)机制:ECC 在线纠正、patrol scrubbing 后台巡检、rank sparing 颗粒换岗,环环相扣。内存的物理组织方式(channel、rank、bank、颗粒位宽)是理解本篇的前提,见 DRAM 子系统组织;控制器侧的调度与 HBM/GDDR 的差异见 HBM、GDDR 与内存控制器。
本文要回答的问题
- 内存错误从哪来?软错误和硬错误的处置为什么不一样?
- ECC 怎么用 8 个校验比特纠 1 比特错、检 2 比特错?SECDED 与 Chipkill 差在哪?
- CE 和 UE 各是什么?为什么 CE 多了比一次 UE 更危险?
- patrol scrubbing 巡检在做什么?它和「读到错再纠」为什么必须同时存在?
- rank sparing 和内存镜像各解决什么问题?RAS 事件的完整处置链路长什么样?
一、错误从哪来:软错误、硬错误与「潜伏」问题
内存错误按成因分两大类。
软错误(soft error) 是瞬态的:alpha 粒子或中子打中 DRAM cell,把存储电容里的电荷扰乱,读出来的比特翻了,但 cell 本身没坏,重写一次就恢复正常。软错误率跟海拔、封装材料、制程都有关,典型量级是每 GB 每月十万分之一到万分之一比特——单看很小,但一台 1TB 内存的机器、一个机房几万台机器,乘起来就是「每天都会发生几次」的必然事件。
硬错误(hard error) 是永久的:颗粒内部某个 cell、某条字线/位线、某个 IO 物理损坏,无论重写多少次读出来都是错的。硬错误多来自老化(电迁移、TDDB 介质击穿)、焊点疲劳、过压过温损伤。
这两类错误凑在一起,催生了内存 RAS 机制最核心的一个设计判断:错误必须尽早被发现并清理,不能让它「潜伏」。原因很简单——ECC 的纠错能力是有限的(下面会讲,主流是纠 1 检 2),如果一个 cell 已经悄悄错了一个比特没人管,等同一个 ECC 码字里的第二个比特再翻,就从「可纠正」滑向「不可纠正」甚至「错纠」的深渊。把潜伏的单比特错误及时扫出来清掉,是让「纠 1」能力始终有效的保险。
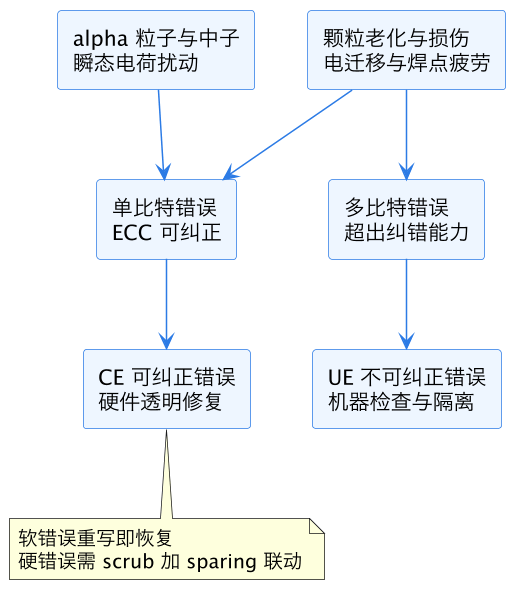
上图给出了错误分类到处置出口的映射:软错误与早期硬错误都先表现为单比特错误,落到 CE 出口被透明纠正;只有硬错误成片恶化、或两个比特同时翻在同一个码字内,才会落到 UE 出口。RAS 体系的大部分设计都是在「把流量往 CE 这边引,把 UE 的出口尽量堵死」。
二、ECC:8 个校验比特换来的纠 1 检 2
ECC(Error-Correcting Code,纠错码)是内存 RAS 机制的地基。主流服务器 DIMM 是 72 位宽:64 位数据 + 8 位校验,每 64 比特数据算一组汉明码(Hamming code)校验位,构成 SECDED(Single Error Correction, Double Error Detection,纠单错检双错)能力:
- 一个码字内翻 1 比特:硬件算出出错位置,直接纠正,上层无感知,记一笔 CE。
- 一个码字内翻 2 比特:检测出来但纠不了,上报 UE。
- 翻 3 比特及以上:可能误判成另一个合法码字(miscorrection),这是 ECC 的固有风险,靠 scrub 压低潜伏错误率来控制概率。
SECDED 的校验位生成本质是对 64 个数据位做 8 组奇偶校验,每组覆盖特定的位集合;读回时重算校验位,与存储的校验位异或得到 syndrome(校正子),syndrome 非零即报错,其数值直接编码了出错位的位置。这套运算在内存控制器里用纯组合逻辑完成,延迟在纳秒级,对正常读路径几乎零开销。
SECDED 有一个结构性短板:它是按比特纠错的,而 DRAM 颗粒的故障常常是整颗失效。一颗 x4 颗粒挂掉,会在一个 72 位字里连续错 4 个比特,SECDED 直接变 UE。针对这个场景,服务器平台提供更强的 ECC 变体:
| 方案 | 纠错粒度 | 典型实现 | 代价 |
|---|---|---|---|
| SECDED | 纠 1 比特、检 2 比特 | 标准 72 位 ECC DIMM | 无额外颗粒 |
| Chipkill / SDDC | 纠单颗 x4 颗粒整体失效 | 码字符号打散到多颗颗粒,符号级 RS 码 | 控制器与布线复杂度 |
| ADDDC | SDDC 再加 bank 级动态重映射 | Intel Xeon 可扩展平台 | 需要备用资源 |
核心思想是把一个 ECC 码字的符号分散到不同颗粒上,一颗颗粒整个坏掉只影响每个码字的一个符号,符号级纠错码就能把它修回来。关于颗粒、rank、channel 如何物理排布,DRAM 子系统组织 有完整拆解,这里不再展开。
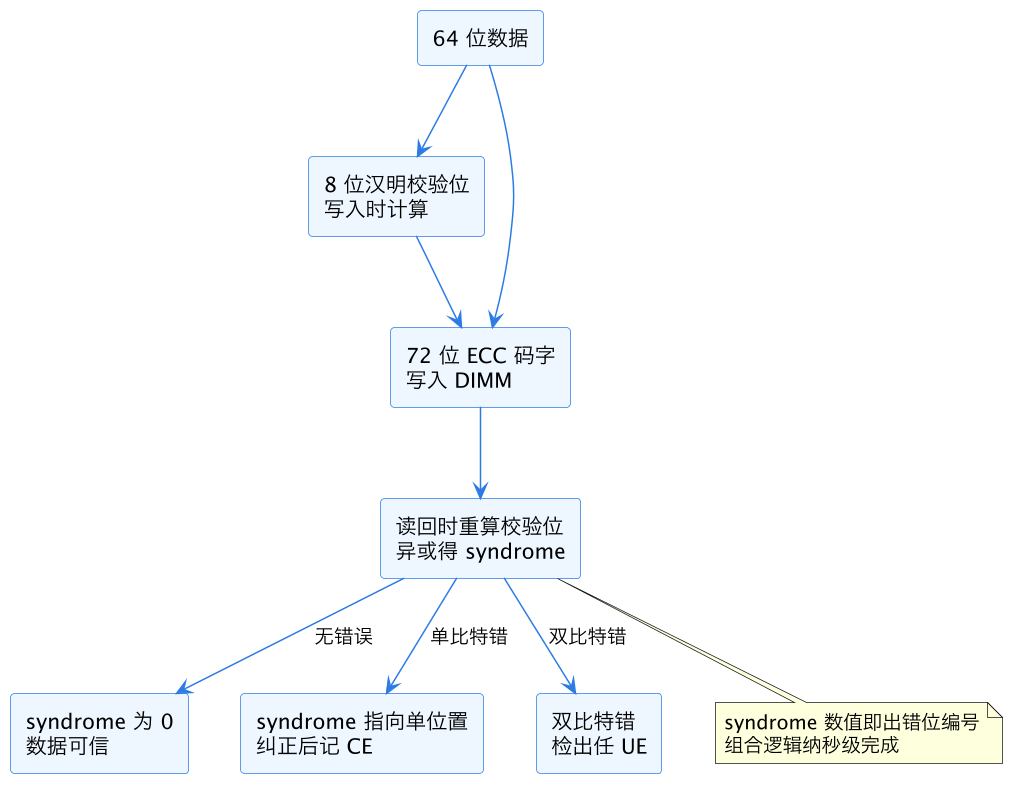
上图是 SECDED 的写读闭环:写入时 64 位数据算出 8 位校验拼成 72 位码字落盘;读回时重算比对,syndrome 分流到三个出口。注意「纠正」只发生在内存控制器的读数据路径上——DIMM 里的那个比特还是错的,如果它是软错误,下次读还会再纠一次、再记一笔 CE。这就是下一节巡检存在的理由。
三、CE 与 UE:两种上报路径,两种命运
ECC 把错误分成两个等级上报,操作系统对它们的反应完全不同。
CE(Corrected Error,可纠正错误) 由硬件自动修复,对软件完全透明。它存在的意义不是「出了个错」,而是「这里有个病灶」:软错误被纠正后 cell 恢复正常,CE 只是孤立事件;但如果是硬错误,同一个地址会反复产生 CE,计数器持续上涨。Linux 下 CE 通过 CMCI(Corrected Machine Check Interrupt)或周期性轮询投递,EDAC 子系统(Error Detection And Correction)把每条 CE 记录到 /sys/devices/system/edac/mc/,包含内存控制器、channel、DIMM 槽位、出错地址和计数。运维上的经验法则是:同一 DIMM 的 CE 在 24 小时内超过几十到几百次(各厂商阈值不同),就该列入更换名单——它大概率是一颗正在恶化的颗粒,下一次翻的可能就是第二个比特。
UE(Uncorrected Error,不可纠正错误) 是真正的坏消息。硬件检出双比特错后触发 MCE(Machine Check Exception,机器检查异常)。现代平台支持 SRAR(软件恢复)级别的 MCE:如果出错数据还没被消费,内核可以精确处置——错误页属于用户进程就 kill 那个进程(SIGBUS,配合 memory_failure() 把该页离线),属于内核关键数据结构才 panic。老的或更严重的错误(UCNA 之外、错误已扩散)则直接整机停机。华为、浪潮等厂商的 BIOS 还提供「UE 降级」策略:把致命 UE 按可恢复路径处理,用宕进程换不宕机。
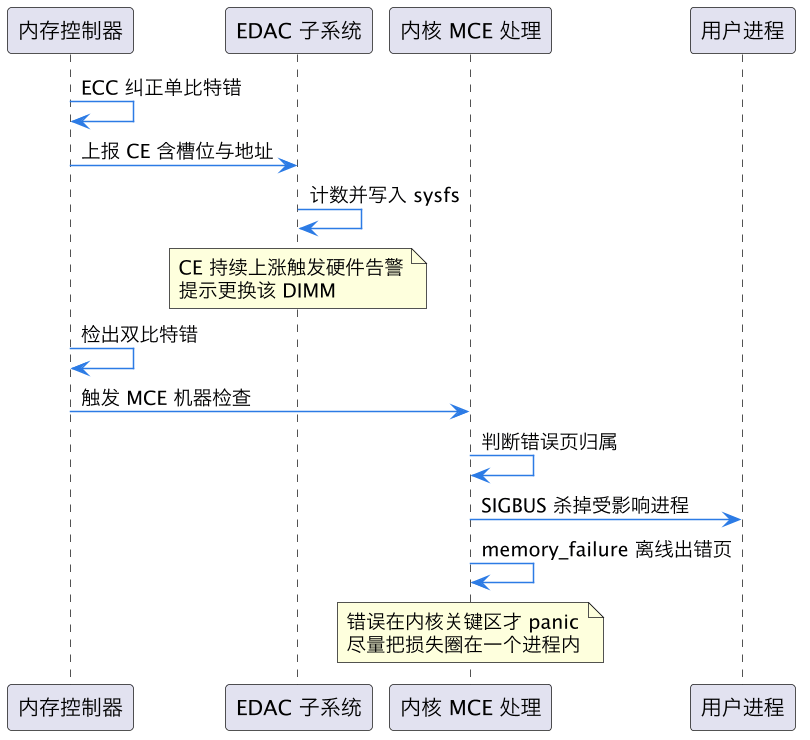
上图把两条路径画在一起对比:CE 走「计数、记录、攒证据」的慢路径,UE 走「机器检查、精确隔离」的快路径。可以看到 CE 根本不是错误处理的终点,而是预测性维护的数据源——这正是内存 RAS 机制里「Serviceability」那一环。
四、patrol scrubbing:后台巡检,清掉潜伏错误
ECC 只纠「被读到的」数据。问题是服务器内存里大量页面可能几小时甚至几天都不被访问,一个软错误(或早期硬错误)就那么静静躺着,等第二个比特翻进来凑成双比特错。patrol scrubbing(巡检清洗)就是内存控制器的一个后台引擎:它按固定节奏把整个物理内存从头到尾扫一遍,对每个 ECC 码字执行「读出—检查—如有单比特错则纠正并回写」。
关键点在回写:纠错不只要把对的数据交给读者,还要把修好的码字写回 DIMM,把病灶除掉。软错误回写后彻底消失;硬错误回写没用(下次读还是错),但至少每次巡检都会把它重新纠一遍、记一笔 CE,防止它和第二个翻转叠加成 UE。巡检周期通常可配(BIOS 里常见 1 小时到 24 小时扫完一遍全量内存),扫得越快潜伏窗口越短,代价是占用内存带宽——典型配置下 scrub 占用带宽在 1% 量级,属于必买的保险。
与 patrol scrubbing 配套的还有 demand scrubbing(按需清洗):正常读路径上 ECC 纠了错,控制器顺手把修好的数据回写 DIMM,而不是只改交付给 CPU 的那份。两者一个管「热数据」,一个管「冷数据」,合起来保证任何单比特错误的存活时间都不超过一个巡检周期。
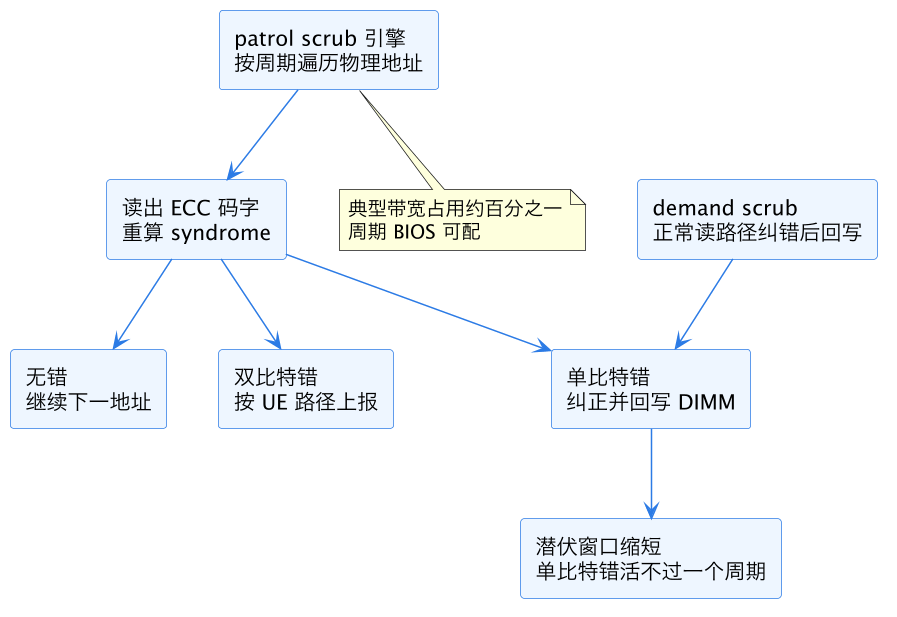
上图把两种 scrub 画成汇入同一个「纠正回写」动作:patrol scrub 自上而下主动遍历,demand scrub 在正常读路径上顺手完成,双比特错则无论哪条路发现都进 UE 出口。巡检的真正产出不是「多纠了几个错」,而是把潜伏窗口压到一个周期以内,让 ECC 的纠 1 能力始终面对的是「只有一个错」的干净局面。
五、rank sparing 与镜像:颗粒换岗与数据双份
巡检和 ECC 处理的是「错误已经发生」;当 EDAC 的 CE 计数预示某颗颗粒、某个 rank 正在恶化时,就要在「它彻底坏掉之前」主动换岗,这就是 sparing(备件替换)类机制。
rank sparing(rank 级备用):每个 channel 预留一个 spare rank 不参与正常寻址。当某个在职 rank 的 CE 计数越过阈值,固件触发换岗流程——把在职 rank 的全部内容拷贝到 spare rank(拷贝过程本身走 ECC 保护的读改写),然后更新地址映射,让 spare 顶替上岗、原 rank 下线。整个过程在线完成,对操作系统透明或仅一次短暂中断。变体还有更细粒度的 bank sparing、row remapping(PPR,Post Package Repair,颗粒出厂后内部修行),思路一致:用冗余资源换下病变资源。
内存镜像(memory mirroring) 则是另一个极端:把内存分成两半互为镜像,每次写同时写两份,读时任取一份、出错切到另一份。可用容量直接减半,换来的是 channel 级故障也能扛的强度——金融业务的主备内存常这么配。
| 机制 | 冗余粒度 | 容量代价 | 能扛的故障 | 触发方式 |
|---|---|---|---|---|
| PPR 行修复 | DRAM 行 | 颗粒内部冗余行 | 单行硬错误 | 固件或巡检触发 |
| rank sparing | 整 rank | 每 channel 一个 rank | 颗粒与 rank 级恶化 | CE 超阈值自动换岗 |
| 内存镜像 | 半量镜像 | 容量减半 | channel 级整体失效 | 常开 |
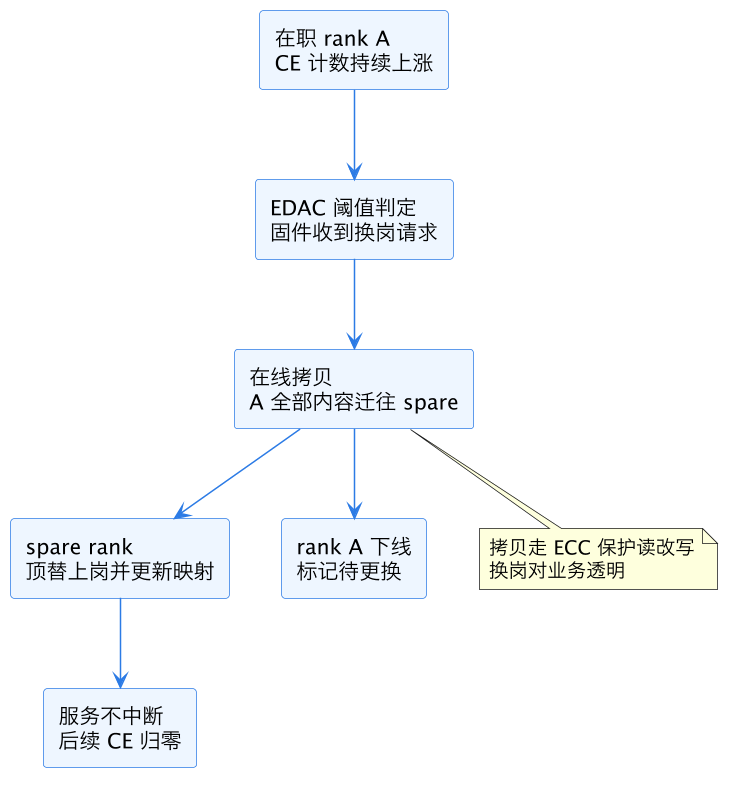
上图是 rank sparing 的换岗流程:病灶 rank 的 CE 曲线是扳机,拷贝是核心动作,地址映射切换是收尾。注意 spare 资源是有限的——一个 channel 通常只有一个 spare rank,换掉一次之后这个 channel 就「裸奔」了,所以 sparing 之后必须尽快安排物理换内存。
六、完整链路:从一次翻转到一次换内存
把前面所有环节串起来,一次内存错误的完整生命周期是这样的:
- 翻转发生:宇宙射线或颗粒老化,某 cell 错了一比特。
- 被发现:要么 CPU 读到它,ECC 当场纠正(demand scrub 回写);要么 patrol scrub 扫到它,纠正回写。记一笔 CE。
- 定性:软错误回写后痊愈,CE 不再复现;硬错误回写无效,同一地址 CE 反复出现,EDAC 计数持续上涨。
- 升级:CE 越过阈值,固件判定该 rank 恶化,触发 rank sparing 在线换岗;期间若不幸出现双比特错,走 UE 的 MCE 精确隔离路径。
- 收尾:spare 顶替后安排维护窗口物理更换 DIMM,新条上岗后把 spare 资源释放出来,体系回到满血状态。
观测侧的入口也值得记住:Linux 下看 /sys/devices/system/edac/mc/mc*/csrow*/ce_count 与 ue_count,用 edac-util --report 汇总;带外管理看 BMC 的 SEL(System Event Log)里 Correctable ECC error 的爆发频率;性能侧如果怀疑 scrub 占带宽,可以按 用 perf 计数器度量缓存与内存行为 的方法采内存控制器的 uncore 事件量化。
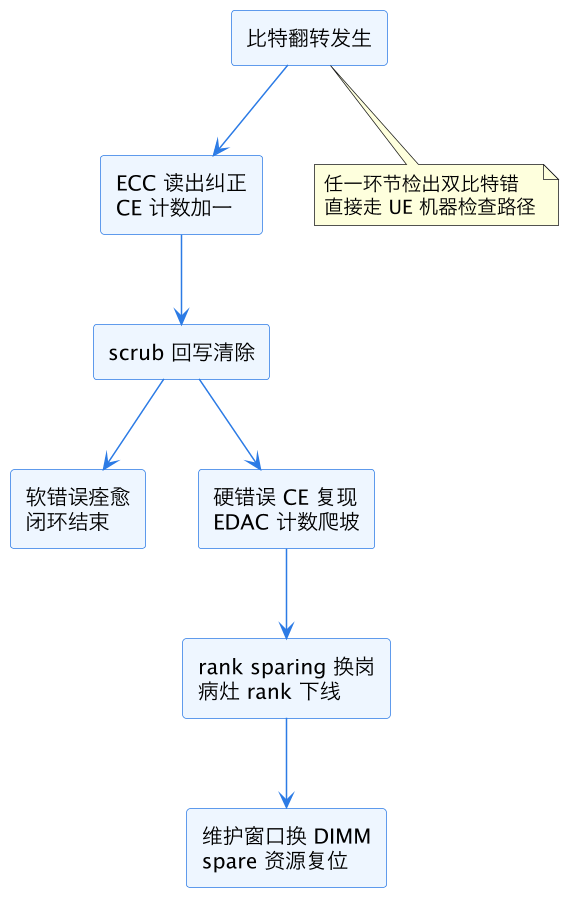
上图就是内存 RAS 机制的全景:每一步都有明确的下一棒,没有「听天由命」的环节。ECC 保证单个错误不伤数据,scrub 保证错误不潜伏,CE 计数把「偶发」与「恶化」区分开,sparing 把恶化中的硬件在服务不中断的前提下换掉——四层防线每一层都在为下一层争取时间。
这一篇在知识体系里的位置
本篇属于微架构层的内存可靠性专题。前置阅读是 DRAM 子系统组织(channel/rank/bank 的物理排布决定了 ECC 码字怎么打散、spare rank 怎么插)与 HBM、GDDR 与内存控制器(scrub 引擎与 ECC 逻辑都住在控制器里,HBM 还有片内 ECC 的新变化)。错误真的漏到软件层之后会发生什么——SIGBUS、core dump 与 MCE 的现场分析——则接 crash 目录下的排查系列;硬件计数器的采集方法见 用 perf 计数器度量缓存与内存行为。
总结
内存 RAS 机制是一条四层防线:ECC 在纳秒级纠正单比特翻转、patrol scrubbing 按周期巡检回写把潜伏错误清到一个周期以内、CE 计数把软错误与恶化中的硬错误区分开、rank sparing 在病灶 rank 彻底坏掉前在线换岗——四层合起来,把「比特总会翻」这个物理现实,变成服务器几年不停机也几乎不丢数据的工程事实。