RVV vsetvl 条带挖掘:重配置开销与 strip-mining 循环的正确写法
承 SIMD 与向量长度无关编程 对「向量长度无关(VLA, Vector-Length Agnostic)」编程模型的总览,以及 向量执行单元与 SIMD 数据通路 对硬件侧的解释。VLA 模型听起来优雅,落到代码上其实只有一件事:每轮循环开头那条
vsetvl怎么写、代价多大。RVV vsetvl 条带挖掘就是这篇要拆透的主题。
本文要回答的问题
vsetvl指令到底做了什么?为什么它是 RVV 循环的灵魂?- strip-mining(条带挖掘)循环长什么样?它凭什么免掉尾循环?
- 每轮调一次
vsetvl的开销有多大?什么时候它会变成瓶颈? - 写 RVV 内层循环有哪些高频错误写法?
- RVV 这套写法和 ARM SVE、x86 固定长度 SIMD 比,取舍在哪?
一、vsetvl:一条指令定三件事
vsetvl rd, rs1, rs2(汇编形式;C 内建函数是 __riscv_vsetvl_e32m1(avl))的输入是「应用向量长度 AVL(Application Vector Length)」和「元素位宽 + LMUL 分组」,输出是一个实际生效的向量长度 VL(Vector Length),写进目的寄存器,同时配置 vtype 寄存器。
硬件按这条规则算 VL:VL = min(AVL, VLMAX),其中 VLMAX 由当前元素位宽和 LMUL 决定——比如 VLEN=128 的机器上 e32m1 的 VLMAX 是 4,e32m4 是 16。返回值写回寄存器这一点是精髓:软件不用查 CPUID、不用 if-else 判断机器向量位宽,直接拿返回值当本轮的元素计数往下算就行。
| 概念 | 含义 | 例子(VLEN=256) |
|---|---|---|
| AVL | 软件申请「我这轮想处理几个元素」 | 剩余 1000 个 float |
| VLMAX | 当前 e32/m1 配置下硬件一轮最多几个 | 256/32 = 8 |
| VL | min(AVL, VLMAX),硬件实际给的 | 8 |
| vtype | 元素位宽 + LMUL + 尾/掩码策略 | e32, m1, ta, mu |
这就是为什么 RVV 二进制可以「一次编译、到处运行」:同一段代码在 VLEN=128 的嵌入式核上每轮吃 4 个 float,在 VLEN=1024 的服务器核上每轮吃 32 个,软件完全无感。
还有一个容易被忽略的设计点:vsetvl 返回的 VL 不一定严格等于 min(AVL, VLMAX)——规范允许硬件在 AVL 介于 VLMAX 和 2×VLMAX 之间时做「均衡拆分」,让最后两轮长度接近而不是一轮满一轮只剩个零头。这是为了照顾那些短向量效率骤降的实现。对软件而言结论不变:永远信任返回值,别自己推算。
二、strip-mining:一个免尾循环的循环骨架
条带挖掘(strip-mining)是编译器领域的老词,意思是「把一个大循环切成定长条带的小循环」。RVV 的标准写法把这个技法和 vsetvl 绑在一起,骨架如下:
void vec_add(float *a, float *b, float *c, size_t n) {
    for (size_t i = 0; i < n; ) {
        size_t vl = __riscv_vsetvl_e32m4(n - i);   // 本轮实际长度
        vfloat32m4_t va = __riscv_vle32_v_f32m4(a + i, vl);
        vfloat32m4_t vb = __riscv_vle32_v_f32m4(b + i, vl);
        __riscv_vse32_v_f32m4(c + i, __riscv_vfadd(va, vb, vl), vl);
        i += vl;                                    // 按 VL 前进
    }
}
关键在 i += vl 这一步:当剩余元素不足一条带时,vsetvl 会自动把 VL 收窄到剩余个数,最后一轮和前面任何一轮执行同一套代码。对比 x86 AVX2 的经典写法——主循环处理 8 的倍数,后面跟一个标量(或掩码)尾循环清掉零头——RVV 的尾处理是「免费的」,这正是 VLA 模型最实际的工程红利。
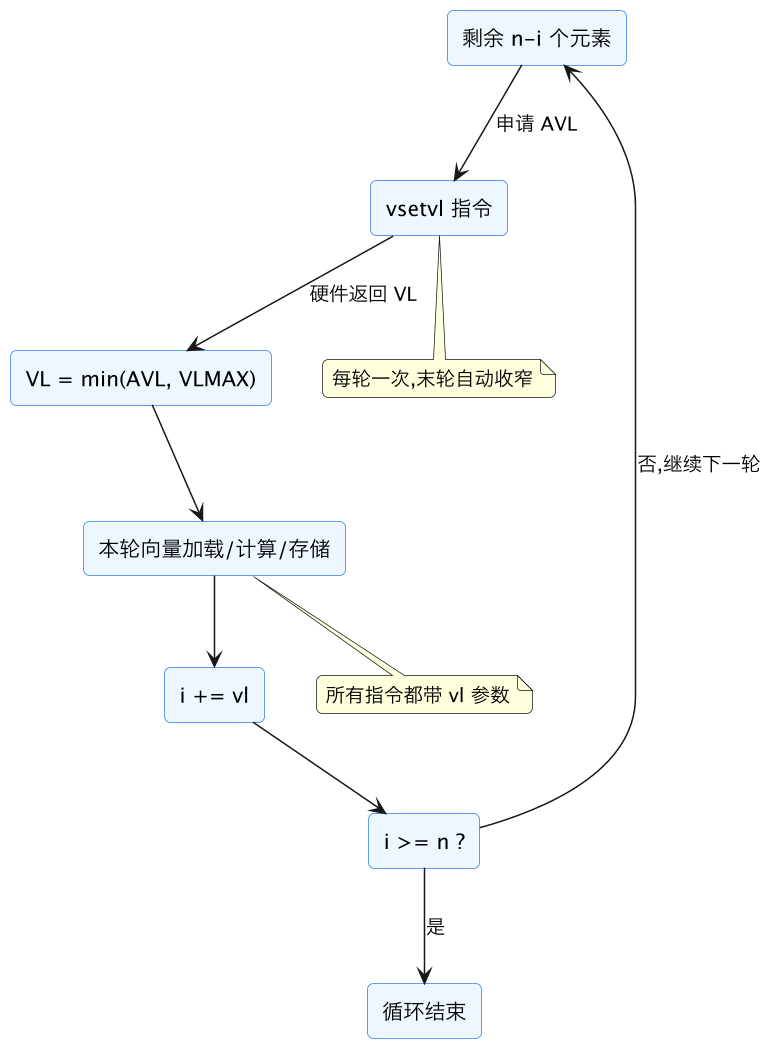
图里这条回路边上有两个细节值得盯:一是 vsetvl 在循环体内,每轮都执行一次(这是开销的来源,下节展开);二是所有向量指令都显式携带 vl 参数——RVV 的向量指令只处理前 VL 个元素,超出的元素按 vtype 里的尾策略(tail agnostic/undisturbed)处理,软件不用管。
三、vsetvl 的开销:便宜,但不是零
「每轮调一次 vsetvl 会不会很贵」是所有人第一次写 RVV 都会问的问题。实测答案分几档:
- vtype 不变的连续
vsetvl:绝大多数实现只需要改 VL 寄存器,开销 1 个周期上下,基本可忽略。上面vec_add那种从头到尾 e32m4 不变的循环就属于这档。 - vtype 变化的
vsetvl(换元素位宽或 LMUL):部分实现要重排向量寄存器堆的内部视图,代价从几个周期到几十个周期不等,某些保守实现直接做流水线排空。 - 病态用法:在循环里来回切换
e32m1/e32m4/e16m2,每轮都触发 vtype 变更,重配置开销会实打实吃掉 10% 以上的时间——这不是理论担忧,在部分商用核上实测过。
所以工程结论很朴素:一个内层循环只选定一种 vtype,vsetvl 放在循环顶部每轮一次,别在循环体内换配置。想让 vsetvl 次数更少,可以加大 LMUL(比如 m4 换 m8,VLMAX 翻倍、迭代次数减半),代价是寄存器压力变大、多向量寄存器组之间调度更紧。
选 LMUL 的经验法则:循环体只用 2-3 个向量寄存器组的简单逐元素算子(memcpy、saxpy、点积),m4 或 m8 把单轮吞吐拉满;循环体里要同时驻留 6 组以上中间值(比如 3x3 卷积的多行窗口),降到 m1/m2 反而快,因为寄存器溢出成内存往返的代价远超省下的几次 vsetvl。用 intrinsics 写时编译器会按你声明的类型决定 LMUL,寄存器分配冲突会直接导致 spill 代码——写完看一眼反汇编里有没有意外的 vs1r.v/vl1r.v 成对出现,那是 spill 的指纹。
四、一个可量化的微基准直觉
拿 n = 1000000 的 float 加法、VLEN=512、e32 为例算笔账:m4 时 VLMAX=64,循环约 15625 轮,vsetvl 总开销约 1.5 万个周期;m8 时轮数减半到 7800 上下,总开销约 8000 周期。而循环体本身在典型双发射向量核上每轮至少几十个周期,vsetvl 占比通常不到 2%。换句话说:只要 vtype 不变,vsetvl 的开销对绝大多数负载都在噪声里;真正要警惕的只有「循环内换 vtype」和「极小 n(几十到几百个元素)下配置成本占比升高」这两种场景。小 n 场景的对策是函数入口就把 vtype 配好、循环里用 vsetvli zero, zero 形式的纯 VL 变更(多数实现对此有快速路径),或者干脆对短向量走标量旁路。
五、高频错误写法
三个在真实代码 review 里反复出现的坑:
- 用常数 VLMAX 写死步长。
i += 8配vsetvl返回值不用,一旦换到 VLEN 不同的机器或改了 LMUL,要么越界要么漏元素。步长必须来自vsetvl的返回值。 - 循环外只调一次
vsetvl。这只有在n恰好是 VLMAX 整数倍、且你保证永不改 vtype 时才碰巧正确;正确姿势是把「申请—使用—前进」作为不可分割的一轮。 - AVL 传错。
vsetvl的第一个参数是「剩余元素个数」n - i,不是总长度n。传n在多数情况下也能跑对(因为 VL 被 VLMAX 截住),但末轮判断逻辑会悄悄坏掉,属于「能跑但错」的典型。
编译器能救一部分:GCC/LLVM 的 RVV 自动向量化会自动生成 strip-mining 循环,且 vsetvl 插入策略经过调优(比如识别 vtype 不变时把冗余配置合并、把 vsetvl 提升出不变子表达式)。手写内建函数时,这些优化就得自己扛。
还有一个隐蔽错误:多条带融合时漏传 vl。比如把两轮计算合并成一轮、写了两个 vle32 却只在最后一条 vse32 上传了 vl——RVV 的 intrinsics 要求每条向量指令都显式携带 vl,漏传的那个会按「当前 VL 寄存器值」走,语义上碰巧对,但一旦夹在中间的代码改过 VL 就静默出错。养成「每条指令都带 vl、vl 只来自本轮 vsetvl」的肌肉记忆,能挡掉一整类 bug。
六、和 SVE、固定长度 SIMD 的取舍
| 维度 | RVV strip-mining | ARM SVE | AVX2/AVX-512 |
|---|---|---|---|
| 长度发现 | vsetvl 返回值 | whilelt 谓词 + cntw | 编译期常数 |
| 尾循环 | 无,末轮自动收窄 | 无,谓词自动遮尾 | 需要标量/掩码尾循环 |
| 逐轮开销 | 每轮一条 vsetvl | 每轮一条 whilelt 类指令 | 零(展开后) |
| 跨硬件二进制 | 完全兼容 | 完全兼容 | 每个位宽一份代码 |
RVV 和 SVE 的本质相同——都是「每轮问硬件要长度/谓词」;差别在 RVV 把长度放在标量寄存器里(还能拿来做地址递进的算术),SVE 把存活掩码放在谓词寄存器里。固定长度 SIMD 用零运行时开销换来的是每代位宽翻倍都要重编译、尾循环代码翻倍。对库函数和内核热路径,RVV vsetvl 条带挖掘那每轮 1 个周期的代价,换来「一份二进制吃十年」,通常是划算买卖。
这一篇在知识体系里的位置
本篇是 VLA 主题的落地篇:模型层见 SIMD 与向量长度无关编程,硬件层见 向量执行单元与 SIMD 数据通路,RISC-V 核间对比见 riscv-microarch-compare,x86 侧演进见 avx10-converged-vector-isa。
总结
RVV vsetvl 条带挖掘的口诀是「循环顶部一条 vsetvl、步长只用返回值、全程不换 vtype」:VL = min(AVL, VLMAX) 让末轮自动收窄、免掉尾循环,vtype 不变时每次重配置约 1 个周期,真正的开销陷阱是在循环里反复切换元素位宽或 LMUL——写对这一个循环骨架,RVV 代码就赢了一半。