AVX-512 降频许可:触发条件、过渡延迟与混合负载的真实代价
承 vector-simd-execution-units 对向量执行单元的拆解,以及 power-virus-avx-offset 对 AVX offset 调压调频链路的介绍。那两篇讲的是「重向量代码自己会跑多快」,本篇回答的是一个更扎心的问题:一个核上只要跑了几条 AVX-512 指令,整个核的频率都会被拉低——哪怕你后面跑的全是标量代码。这套机制就是 AVX-512 降频许可(license-based downclocking),它是「我用了 AVX-512 反而变慢」这类反直觉现象的总根源。
本文要回答的问题
- AVX-512 降频许可的三档(L0/L1/L2)是怎么划分的?触发条件到底是什么?
- 频率切换不是瞬间完成的,过渡期间那段「白等」的时间有多长?
- 标量和向量混合的负载里,偶尔几条 512 位指令为什么会让整体性能倒退?
- 不同代次的 CPU(Skylake-X 到 Sapphire Rapids)这套机制的严苛程度差多少?
- 工程上怎么判断「该不该用 AVX-512」?有没有观测手段确认自己的服务正在被打许可降频?
一、为什么会有许可这回事:电压与功耗的硬约束
512 位宽的向量单元是个不折不扣的吃电怪兽。一条 512 位 FMA(融合乘加,一条指令同时做乘法和加法)指令,每周期要驱动 16 个双精度浮点 lane 的乘加器,瞬态电流远超普通标量指令。如果芯片在标量代码设定的高频低压状态下突然灌入密集的 512 位指令,电压可能被瞬间拉垮(电压骤降,droop),轻则计算出错,重则系统崩溃。
Intel 的解法不是让芯片随时顶着高电压运行——那会让所有轻负载白白多付功耗——而是按指令「重量」分档授权频率:核心检测到正在执行的向量指令属于哪个重量级别,就把该核切到对应许可档位的频率上限和电压曲线上。这就是 license(许可)一词的由来:你没有「重向量许可」,就不准跑那么重的指令;拿了许可,就得接受降频。
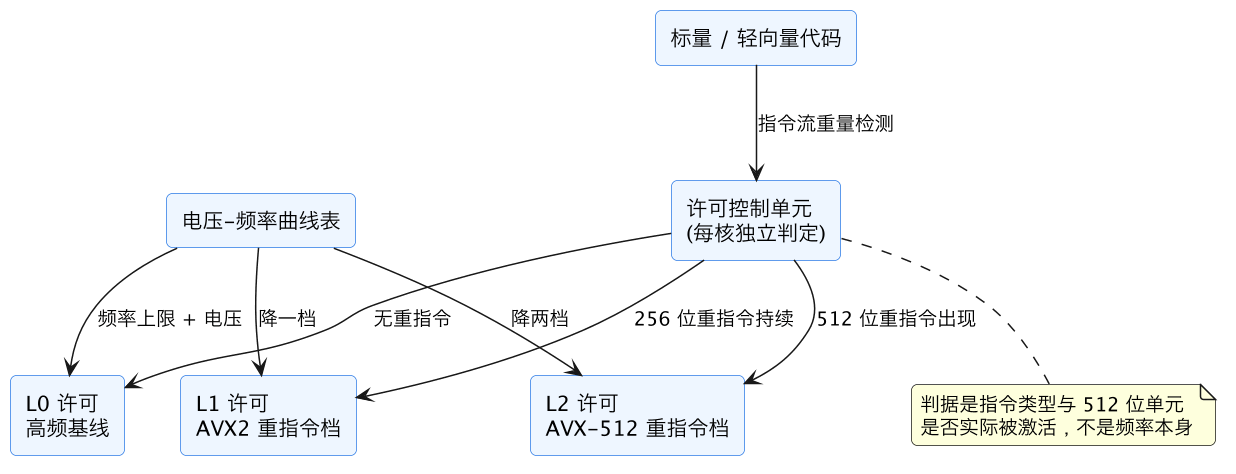
这张图的关键点:许可判定是每核独立的——一个核被打到 L2,隔壁跑纯标量的核不受影响(但全核睿频上限可能被整体功耗预算间接牵连)。判据看的不是你程序「链接了 AVX-512」,而是 512 位执行单元是否真的被点燃。
二、三档许可的划分与触发条件
以 Skylake-X/SP 这一代定型的划分方式为准(后续代次细节有微调):
| 许可档 | 触发指令类型 | 典型频率影响(Skylake-SP 8180 为例) |
|---|---|---|
| L0 | 标量、128/256 位轻指令(整数、shuffle、load/store) | 基线睿频,如 3.4 GHz |
| L1(AVX2 turbo license) | 256 位浮点乘加等「重」指令持续执行 | 降到约 2.9 GHz(-15%) |
| L2(AVX-512 license) | 任何 512 位指令激活 512 位单元;512 位重 FMA 进一步压低 | 降到约 2.3 GHz(-32%),重 FMA 档更低 |
这张表里的数字只是某一代某型号的示例,别背下来当常量。各代的频率表写在 Intel 每颗型号的规格书(specification update 与 datasheet)里,服务器芯片还有按核心数分档的「AVX 基频/睿频表」——28 核满载跑 L2 许可的频率上限,和 4 核轻载跑 L2 的频率上限,可能差出近一倍。做容量评估时查自己那颗 U 的表,别拿评测网站某颗旗舰的数套全线。
有两个细节常被误解。
第一,触发看的是「512 位单元是否上电工作」,不是所有 AVX-512 指令都同样重。一条 512 位的 vmovdqu64(纯搬运)和一条 512 位 vfmadd(浮点乘加)都会把许可顶到 L2,但只有后者会进一步落入 L2 里的「重指令」子档,享受最深的降频。也就是说:偶尔一条 512 位 load 就可能让你付出 L2 档的频率代价,哪怕它自己几乎不耗电。
第二,许可有「滞留期」。核心从重指令切回标量代码后,不会立刻回 L0——硬件要观察一段窗口(典型实现里是毫秒量级的计数器衰减)确认重指令真的停了,才逐级回调。这意味着「打了一下就跑」的用法代价最大:频率降下去得快,爬回来得慢。
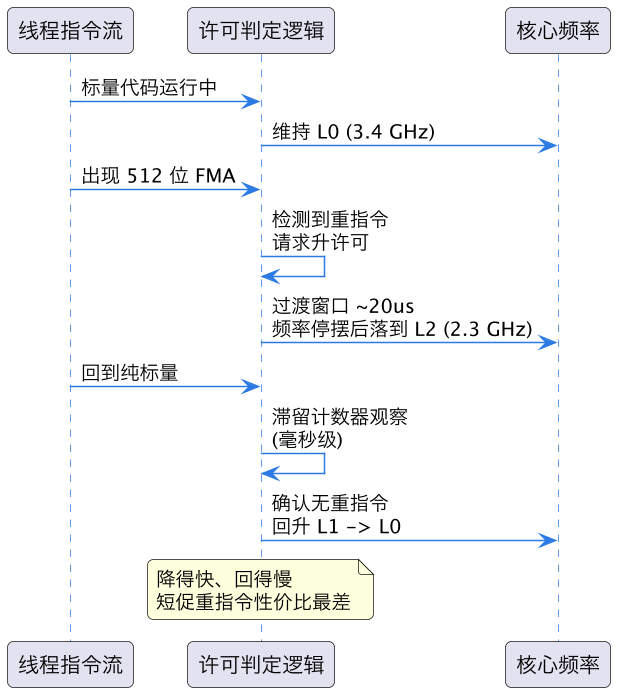
这张时序图里最重要的信息是中间那段过渡窗口:频率切换期间核心不是平滑降速,而是要经历一段近乎停摆的过渡。
三、过渡延迟:那 20 微秒去哪了
Travis Downs 等研究者在 Skylake-X 上的实测给出了这套机制里最反直觉的数字:从重指令出现到 L2 频率真正生效,中间存在一个约 20 微秒的过渡窗口。这段时间里核心并非照常执行——512 位执行单元在上电稳定前,相关指令会被阻塞等待,而普通标量指令虽能继续跑,整个核的效率也明显受扰。之后还要再经过约 670 微秒,频率才完全爬到 L2 的目标值。
这意味着什么?算一笔账:假设你的程序每毫秒穿插一小段 AVX-512 优化过的 memcpy(也就几条 512 位指令)。每次许可切换,你付出的固定成本是约 20 微秒的过渡扰动;换来的加速是那几条指令本身快了 2 倍。如果那段向量代码本身只省 1 微秒,净收益是负的 19 微秒。这正是 glibc 历史上反复调整 AVX-512 版 memcpy 启用策略的原因——短拷贝用 512 位实现,省的时间不够付许可税。反过来说,同样是 memcpy,如果拷贝的是几兆字节的大块内存、且调用足够频繁密集,许可一旦进入稳态,512 位实现的带宽优势就能盖过降频,此时它又是赢家——分界点不在指令本身,而在「每次切换之间能塞进多少连续向量工作」。
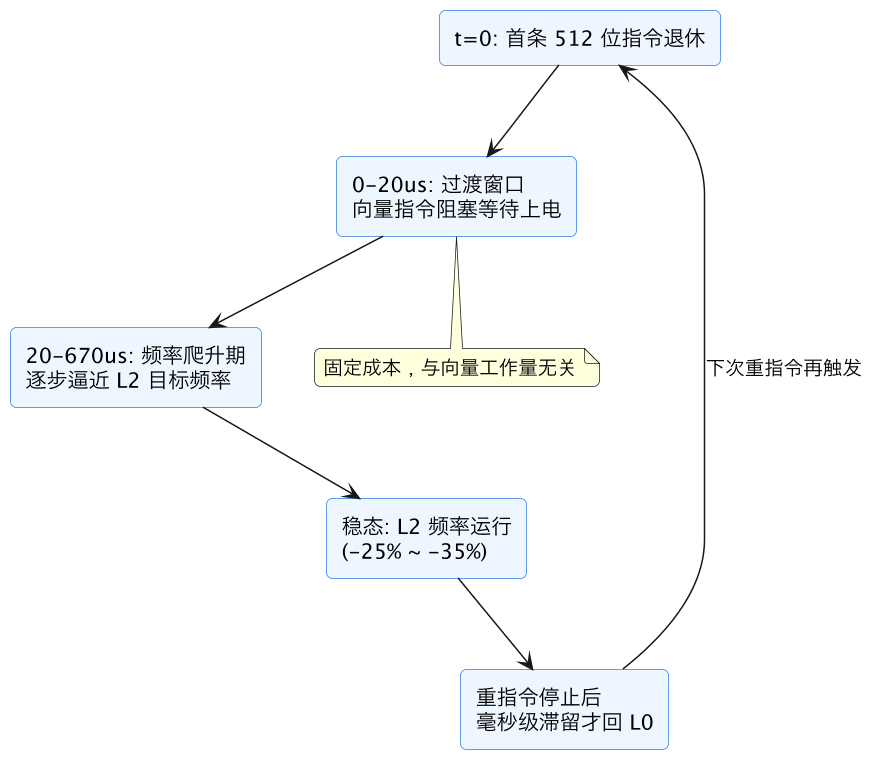
解读这张图:整条链路的成本结构是「固定门票 + 按时间计费」。固定门票(20 微秒过渡)决定了零散使用必然亏本;只有向量工作足够大块、足够连续,稳态阶段的吞吐翻倍才能摊薄门票和降频损失。
四、混合负载:为什么整体性能会倒退
理解了许可机制,混合负载的「反常」现象就全都能解释了。典型场景有三种。
场景一:主线程标量密集,偶尔调用向量化的库函数。 比如一个 JSON 解析服务,99% 是分支密集的标量代码,1% 走了 AVX-512 版的字符串扫描。实测里这类负载开启 AVX-512 路径后整体吞吐下降 5-15% 并不少见:那 1% 的向量代码把核按在 L1/L2 档,剩下 99% 的标量代码陪着吃降频。
场景二:同核超线程兄弟被连坐。 许可和频率是核级的,SMT(同时多线程,一个物理核跑两个逻辑核)兄弟共享同一个核的频率。兄弟线程跑 AVX-512,你这边纯标量照样被拖到 L2 频率。
场景三:库作者在不知情下「帮」你开了 512 位路径。 编译器 -march=native、运行库的分发(dispatch)逻辑、甚至某个第三方 so 里的 memset,都可能在后台激活 512 位单元。排查「最近没改代码怎么变慢了」时,这是一个经常被漏掉的方向。
| 场景 | 向量代码占比 | 典型净效果 | 原因 |
|---|---|---|---|
| 大块稠密计算(GEMM、科学计算) | >90% 且连续 | 显著加速(1.5-2 倍级) | 稳态吞吐翻倍摊薄降频 |
| 中等向量化(视频编码、压缩) | 30-70% | 持平到小幅收益 | 降频与加速大致对冲 |
| 零散向量调用(短 memcpy、偶发 SIMD) | <5% 且分散 | 净亏损 | 固定过渡成本 + 标量陪跑降频 |
| 同核邻居跑重向量 | 自身 0% | 纯亏损 | 频率核级共享,被连坐 |
判断自己属于哪一行,核心是两个量:向量工作的连续性(能不能凑成大块稳态段)和占比(标量部分要陪跑多久)。
五、代次演进:从 Skylake-X 到 Sapphire Rapids 在变好
这套机制并不是铁板一块,而是逐代在明显软化:
- Skylake-X/SP(2017):最严苛。降频深(L2 重档可到 -35%)、过渡慢、且 512 位单元上电本身有明显的额外静态功耗。
- Cascade Lake / Cooper Lake:微调频率表,语义基本不变。
- Ice Lake(2021):大幅改善。L1 档在很多型号上被弱化甚至名义取消,L2 降频幅度收窄,过渡窗口缩短;512 位单元的电压效率重新设计过。
- Sapphire Rapids(2023):进一步温和。多数负载下 AVX-512 的频率惩罚已降到个位数百分比,部分场景甚至没有独立许可档——「用 AVX-512 必降频」的经验在这代上开始失效。
- AMD 阵营对照:Zen 4/Zen 5 的 AVX-512 实现(Zen 4 用双泵 256 位单元执行 512 位指令)基本不设许可降频档,这也是同代对比里 AMD 在混合负载下口碑更好的原因之一。
选工程策略前先确认自己在哪一代硬件上:Skylake-SP 上「能不开就不开」的结论,搬到 Sapphire Rapids 可能是错的。指令集层面的演进脉络可参考 avx10-converged-vector-isa,它要解决的正是这类「宽度与功耗档位纠缠」的历史包袱。
六、工程对策与观测手段
落地建议按顺序来。
第一步,确认自己有没有被打许可。 Linux 下最直接的手段是读 perf 的 cycles 对比 ref-cycles,或用 turbostat 直接看每个核的实时频率与 C-state;更精确的判定是 PMU 事件 CORE_POWER.LVL2_TURBO_LICENSE(统计处于 L2 许可的周期数)和 CORE_POWER.LVL1_TURBO_LICENSE——它们的占空比直接告诉你这个核有多少时间在被降档。采样一段业务高峰期:
perf stat -e cycles,instructions,CORE_POWER.LVL2_TURBO_LICENSE -a -- sleep 10如果 LVL2 事件数占到 cycles 的明显比例,而降频带来的损失又覆盖不了向量加速的收益,就该动手了。
第二步,按负载形态选策略。 稠密大块计算(BLAS、AI 推理的 GEMM 内核)放心用 AVX-512,它是稳态吞吐的赢家;混合服务优先考虑「向量化但限宽」——用 256 位实现(Ice Lake 之后 256 位重指令的惩罚也轻得多),或者干脆对短操作禁用 512 位路径。glibc 提供 tunable 控制:GLIBC_TUNABLES=glibc.cpu.hwcaps=-AVX512F 可以让字符串/内存函数回避 512 位实现;自家代码则控制 -mprefer-vector-width=256 这类编译开关。
把上面的判断串成一张决策图,遇到「要不要在某段代码上 AVX-512」时照图走一遍:
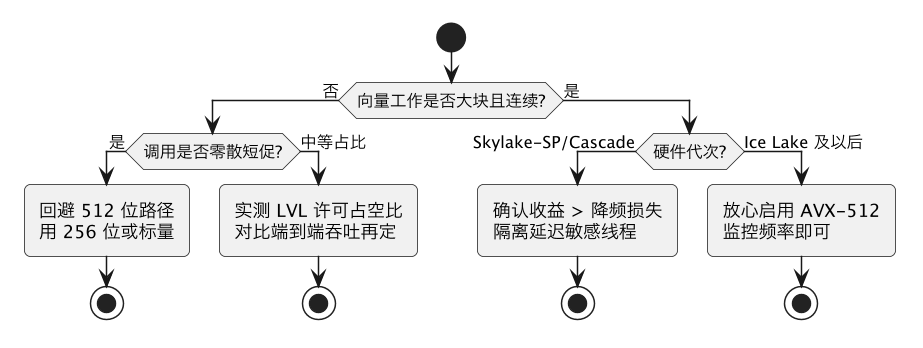
这张决策图的分支次序有讲究:先问「工作形态」,再问「硬件代次」。因为工作形态决定的是成本结构(门票摊不摊得薄),代次只决定门票的价格——形态不对,换最新硬件也只是亏得少一点,不是不亏。图中「实测占空比再定」那条路是大多数真实服务的归宿:理论估算在 30-70% 占比这种灰色地带误差很大,只有 CORE_POWER.LVL*_TURBO_LICENSE 的实测能给确定答案。
第三步,隔离连坐。 关键延迟敏感线程与重向量批处理任务用 cgroup/cpuset 分到不同物理核;开了 SMT 的话注意兄弟核的配对(温度类连带问题的排查思路见 thermal-throttling-temp-sensor,频率问题先看温度再看许可,别把两者混为一谈)。容器环境里还有一个隐蔽的连坐来源:同一宿主机上别的容器跑 AI 推理批处理,你的容器虽然被限了 CPU 配额,但调度器把你们排到了同一个物理核的两个超线程上,许可照样共享——对延迟极度敏感的服务,值得开 cpu manager 的 static policy 或等价的绑核机制,把整个物理核独占下来。
第四步,灰度验证。 任何「关掉 AVX-512 路径」的改动都要端到端测吞吐与延迟,别只看 microbenchmark——许可机制的坑恰恰在于 microbenchmark(纯向量循环)里 AVX-512 永远赢,输的是真实混合负载。
这一篇在知识体系里的位置
本篇是 power-virus-avx-offset 的姊妹篇:那篇讲功耗病毒与 offset 的调压链路,本篇聚焦许可机制本身与混合负载的工程后果。向量单元的硬件背景见 vector-simd-execution-units;指令集未来的收敛方向见 avx10-converged-vector-isa;温度与频率的另一条降速链路见 thermal-throttling-temp-sensor。
总结
AVX-512 降频许可的本质是「按指令重量分档授权频率」:512 位单元一旦被激活,该核(含 SMT 兄弟)整体降到 L1/L2 档,并伴随约 20 微秒的过渡停摆与毫秒级的回弹滞留——所以大块连续向量计算用它稳赚,零散调用则是倒贴;判断依据是 CORE_POWER.LVL*_TURBO_LICENSE 的实测占空比,而这套机制的严苛程度从 Skylake-SP 到 Sapphire Rapids 逐代减轻,老经验要先对代次再套用。