CPU 电源与频率管理:C-state、P-state、DVFS、温度墙与 uncore 频率的功耗-性能全局图景
更新时间:2026-10-03。本站在电源与频率方向已经攒下了若干零件级深文:C-state 与 P-state 硬件机制 讲睡眠档与频率档的硬件细节,DVFS 频率切换延迟 讲一次换挡要花多少时间,温度墙与热节流 讲结温传感器与降频保护,时钟门控与功耗门控 讲电路级省电手段。读者最常问的却是一个体系问题:这些机制装在同一颗芯片上,谁在什么时候决定 CPU 跑多快?为什么我的服务延迟会莫名其妙抖一下?为什么同一台机器白天和深夜跑分不一样?本篇就是回答这个问题的枢纽文——把 C-state、P-state、DVFS、温度墙、uncore 频率五个概念放进同一张功耗-性能地图,并给出一套可操作的频率抖动排查方法论。
本文要回答的问题
- CPU 电源与频率管理的完整决策栈是哪几层,谁在做主?
- C-state 睡多深和 P-state 跑多快分别由谁决定,为什么是两套独立机制?
- DVFS 换挡的物理成本是多少,为什么「省电」和「低延迟」天生冲突?
- 温度墙触发时芯片内部到底发生了什么,降频是阶梯还是悬崖?
- uncore 频率为什么独立于核心频率,它波动时内存延迟会怎样?
- 线上出现延迟抖动时,如何按流程定位到频率管理这一层?
一、全景:一颗 CPU 的功耗-性能决策栈
先把整件事的骨架立起来。一颗现代服务器 CPU 的功耗与频率,不是某一个部件说了算,而是一个多层决策栈每层各管一摊、互相博弈的结果:
- 应用与内核调度器:决定每个核「忙不忙」。负载是第一推动力——没有活干,才谈得上省电;活多,才需要提频。
- CPU 空闲子系统(cpuidle):核没活干时选哪个 C-state 睡下去,睡多深取决于预测的 idle 时长。
- 频率子系统(cpufreq 或硬件 HWP):核有活干时选哪个 P-state 跑,可以由内核 governor 决定,也可以交给硬件自主(Intel Speed Shift / AMD CPPC)。
- 功耗管理单元(PCU/PMU,片上一个微控制器):真正的「片内总督」,每毫秒级收集全芯片的温度、电流、功耗,执行 RAPL 功耗封顶、温度墙降频、uncore 频率调节。
- 平台与固件(BIOS/ BMC):设定功耗墙(PL1/PL2)、散热能力边界,决定哪些机制被允许启用。
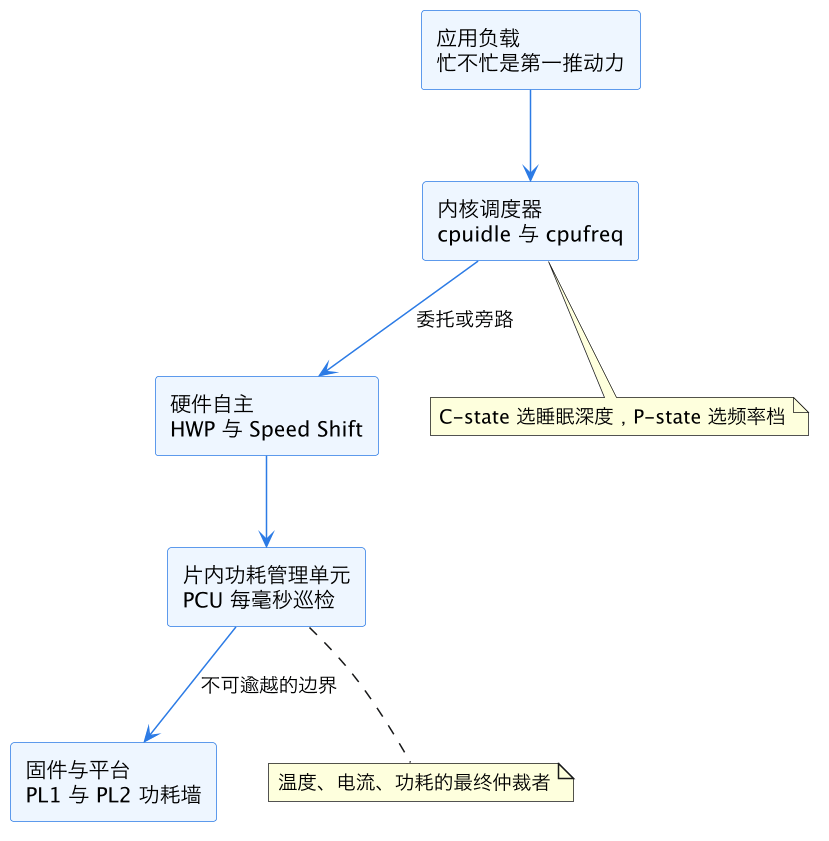
上图的核心信息是:频率决策是「请求-仲裁」结构。操作系统和硬件自主引擎提出「我想跑多快/睡多深」的请求,片内 PCU 手握温度与功耗两张红牌,可以单方面否决。这就是为什么你在 sysfs 里设了性能 governor,全核跑起来频率仍然掉——上层意愿敌不过底层物理。
这条决策栈的存在理由,归根到底是功耗方程:动态功耗约等于 电容乘电压平方乘频率(P ≈ C·V²·f),而电压又必须随频率一起抬。这意味着频率翻倍,功耗可能涨到 2.5-3 倍。一颗 350W TDP 的服务器 CPU 有 64 个核,如果每个核都全速跑,总功耗轻松破千瓦——供电和散热都接不住。所以 CPU 电源与频率管理的本质是在固定的功耗预算里做全芯片的分配题:给谁提速、让谁睡觉、什么时候全体踩刹车。
二、C-state 与 P-state:空闲时睡多深,忙碌时跑多快
理解 CPU 电源与频率管理的第一块基石,是分清 C-state 和 P-state 管的是两个不相交的时间段。一个核任何时刻要么在执行指令(活跃态 C0),要么在睡觉(C1/C1E/C6 等睡眠态)。C-state 只在「没活干」的时候有意义,决定睡眠深度;P-state 只在「有活干」的时候有意义,决定运行频率。两者永远互斥,不存在「C6 态的 P3」这种组合。
C-state 的睡眠深度是阶梯式的:C1 只是停掉核心时钟(时钟门控),唤醒延迟接近零;C1E 顺带降电压;C6 则把核心电压彻底关断(功耗门控),寄存器状态搬进 SRAM 保存,唤醒时要重新上电、恢复状态、重建 TLB 与分支预测热度,延迟可达 50-100μs。睡越深省越多,但醒来越贵。硬件机制细节见 C-state 与 P-state 硬件机制,这里只强调调度含义:cpuidle 子系统选档的依据是「预测这次 idle 会多久」,睡 C6 醒来一次的开销,需要至少睡几百微秒才回本。
P-state 是频率档位表。P0 是最高频(含睿频),Pn 依次降低,每档对应一对(频率,电压)。现代 CPU 的 P-state 已经细化为近似连续调频( granularity 到 100MHz 甚至更细),选择逻辑在三种模式间切换:performance governor 钉死最高频、powersave/schedutil 按负载动态调、硬件自主(HWP)完全交给片内算法,内核只给能耗偏好提示(EPP)。
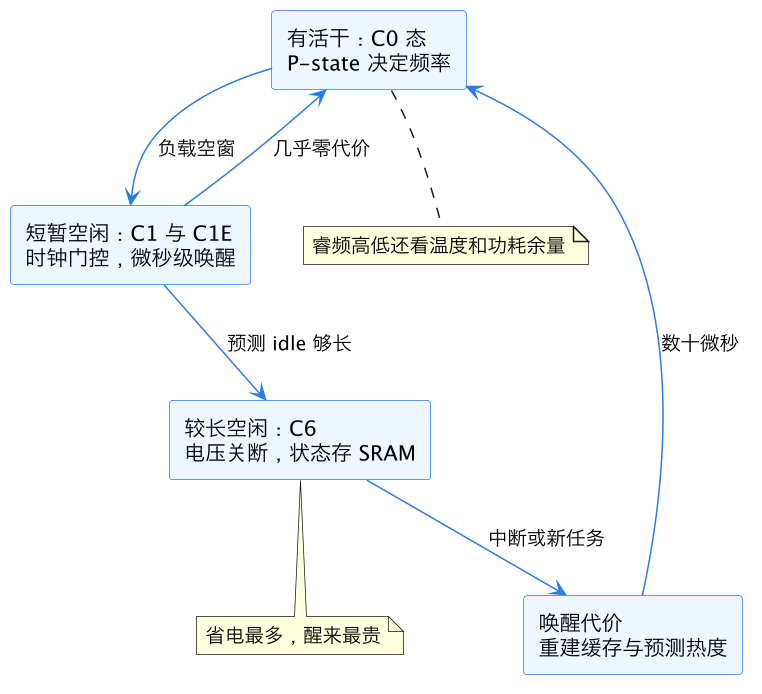
上图是单个核在「忙-闲」之间的状态循环。实践中最容易踩的坑叫 C-state 唤醒抖动:延迟敏感服务(如行情撮合、游戏帧循环)在低负载时段,核被频繁放进 C6,每次来请求都要付几十微秒的唤醒税,P99 延迟因此比高负载时还差。解法是在内核启动参数里限制最大睡眠深度(intel_idle.max_cstate=1),或用 cpupower idle-set 按延迟预算禁用深睡档——代价是整机功耗上升。
还有一个结构性细节值得记住:package 级 C-state(PC2/PC6,整颗插槽一起睡)要求所有核都同意,任何一个核还醒着,整个 package 就睡不下去。所以「64 个核里有一个核被某个后台守护进程每 10ms 戳醒一次」,会废掉整颗 CPU 的深度省电能力——这在排查整机功耗异常时是一个经典嫌疑犯。
三、DVFS:换挡的物理成本与延迟冲突
DVFS(Dynamic Voltage and Frequency Scaling,动态电压频率调整)是实现 P-state 的底层机制:降频率的同时必须降电压(低了带不动高频率,高了白耗电),升频则反之。难点在于电压变化比频率变化慢得多——电压调节模块(VRM)是片外的模拟电路,完成一次电压台阶需要 10-50μs,而频率切换(锁相环重新锁定)只需纳秒到微秒级。所以一次完整的升频过程是:先发请求 → VRM 抬电压 → 电压到位 → 倍频器切档 → 恢复执行。
这几十微秒的换挡窗口,就是 DVFS 频率切换延迟 那篇的主角。它解释了一个普遍现象:负载突增的瞬间,性能反而最差——请求洪峰到来时核还跑在低频档,等频率爬上来,洪峰已经过去了。对吞吐量型负载无所谓(平均下来一样),对延迟型负载就是要命的毛刺。
硬件自主调频(Intel Speed Shift / HWP)的主要贡献就是压缩这个决策回路:把「感知负载-决定升频」的环路从内核定时器(毫秒级)搬进片内(微秒级),换挡响应快了一到两个数量级。但即便硬件自主,电压爬升的物理时间也省不掉,只是把「决定换挡」的延迟压缩到接近「完成换挡」的延迟。
DVFS 还有一个常被低估的二阶效应:换挡期间核处于半失能状态。电压台阶爬升的那几十微秒里,有的实现让核继续以旧频率运行(温和方案),有的实现干脆短暂停摆(保守方案)——后者在换挡密集的场景下会形成「越忙越换挡、越换挡越慢」的恶性循环。powersave 类 governor 的换挡频率可以到每秒数百次,每次付几十微秒的税,累积起来就是几个百分点的吞吐损失,外加全部落在延迟分布尾巴上的毛刺。判断自己的负载是否在这个坑里,可以对比 performance 与 powersave 两种模式下的 P99:差距超过 10% 基本就是换挡税在作祟,而不是平均频率差异本身在起作用,这一点必须先分清。
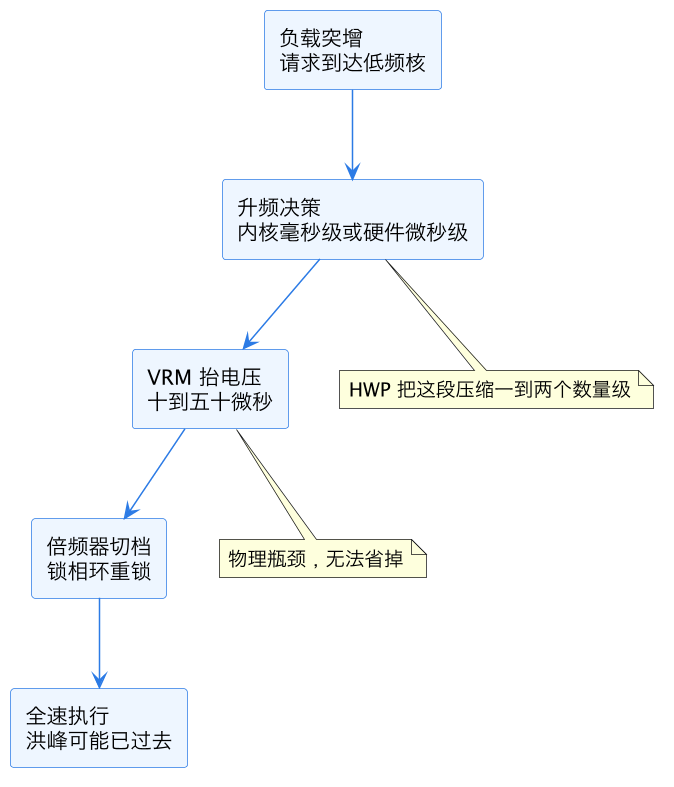
上图是升频路径上的四段延迟。记住结论:「省电模式」与「稳定低延迟」在物理上不可兼得。powersave 策略的代价不是「平均慢一点」,而是「分布尾巴变长」——每次负载起伏都伴随一次换挡窗口。对延迟敏感的服务器负载,标准做法就是 performance governor 加禁用深 C-state,用确定的功耗换确定的延迟。桌面和移动端反过来,能效优先,接受抖动。
四、温度墙:物理极限下的降频保护
频率不是想跑多高就多高,它头顶有一道硬墙:结温。硅片的可靠工作上限一般在 100-105°C,超过就可能永久损伤。CPU 内部散布着几十个数字温度传感器(DTS),PCU 以毫秒级频率轮询,任何一点温度逼近 Tjmax(结温上限),就触发热节流(thermal throttling)——强制降频降压,直到温度回落。传感器的布局与触发逻辑的完整展开见 温度墙与热节流。
温度墙触发的降频是阶梯式且带滞回的:不是温度到 100°C 就瞬间砍半,而是先降一档(如 100MHz 或一个倍频),观察,仍超温就再降;温度回落后也不立刻升回,要低于阈值几度(滞回区间)才恢复,防止在临界点附近来回振荡。除了温度墙,还有两道类似的墙:电流墙(ICCmax,VRM 供电能力)和功耗墙(RAPL 的 PL1 长时均值、PL2 短时峰值)。
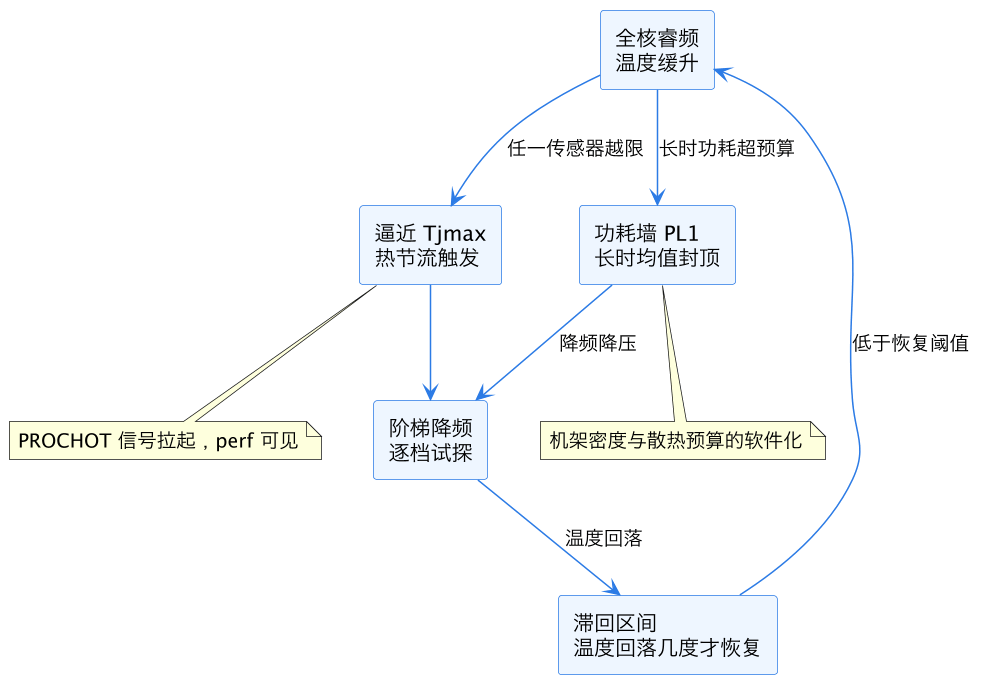
上图把两道墙画在了同一个循环里。两者的区别值得单独说清楚:温度墙是被动保护(物理不允许),功耗墙是主动预算(策略上选择)。RAPL(Running Average Power Limit)让管理员可以给 CPU 设「长时平均功耗不得超过 250W」,PCU 通过周期性微调频率把功耗积分控制在预算内——这就是为什么长时间跑 AVX-512 密集型负载(如科学计算、视频转码),频率会先冲高再回落到一个稳定的「可持续频率」,那个数字由你的散热和 PL1 共同决定,而不是 CPU 标称的睿频。
对性能工程的启示有两条。第一,跑分或压测时必须看温度与功耗余量:同样一段代码,冷机启动头 30 秒的成绩(PL2 短时峰值内)和热稳态成绩可以差 20-40%,基准测试不跑够预热时间就是自欺欺人。第二,数据中心层面,机架功率密度直接决定 PL1 设多少——这就是为什么「同型号 CPU 在云厂商 A 和 B 实测性能不同」,功耗预算不同而已。
温度墙还有一个容易被忽视的空间维度:片内温度是不均匀的。做密集向量运算的核附近温度最高,传感器越限先触发的是局部节流,部分实现会把最热的核单独降档而让其余核维持高频——于是同一颗芯片上不同核的实测频率开始分化。对绑核运行的实时线程来说,这意味着「分到哪个物理核」会影响长期可持续频率。更麻烦的是热点会漂移:负载在核间迁移时热点跟着走,节流的对象也跟着换。观测手段是把 turbostat 按核输出的温度列拉出来看散布,如果最高温和最低温差出 15°C 以上,说明片内热分布已经很不均匀,此时全芯片统一的频率假设就开始失效了。
五、uncore 频率:核心之外的另一条频率轴
前面讲的 P-state 管的是核心频率,但 CPU 里还有一大片「非核心」区域:LLC(末级缓存)、内存控制器、片上互连、PCIe 控制器——统称 uncore。这片区域有自己独立的频率域和电压域(uncore frequency),由 PCU 根据内存与缓存子系统的负载独立调节。
为什么 uncore 要独立调频?因为它的功耗占比不小(高负载时可占整片 15-25%),而它的工作节奏和核心不同步:一个计算密集但缓存友好的循环(核心 100% 忙、几乎不访存)需要核心高频、uncore 低频;一个指针追踪型负载(核心大半时间在等内存)则相反。两个域独立调节,才能做到「谁需要谁多吃」。
uncore 频率波动对性能的影响路径很直接:LLC 和内存控制器的时钟慢了,cache miss 的处理延迟就长。实测中 uncore 从 2.4GHz 降到 0.8GHz 节能档,内存延迟可能恶化 20-30ns,对延迟敏感的访存密集型服务是肉眼可见的劣化。这和 Uncore 环形与 Mesh 互连 里讲的互连架构叠加:mesh 节点跑在 uncore 时钟域上,跳数延迟随时钟同比伸缩。
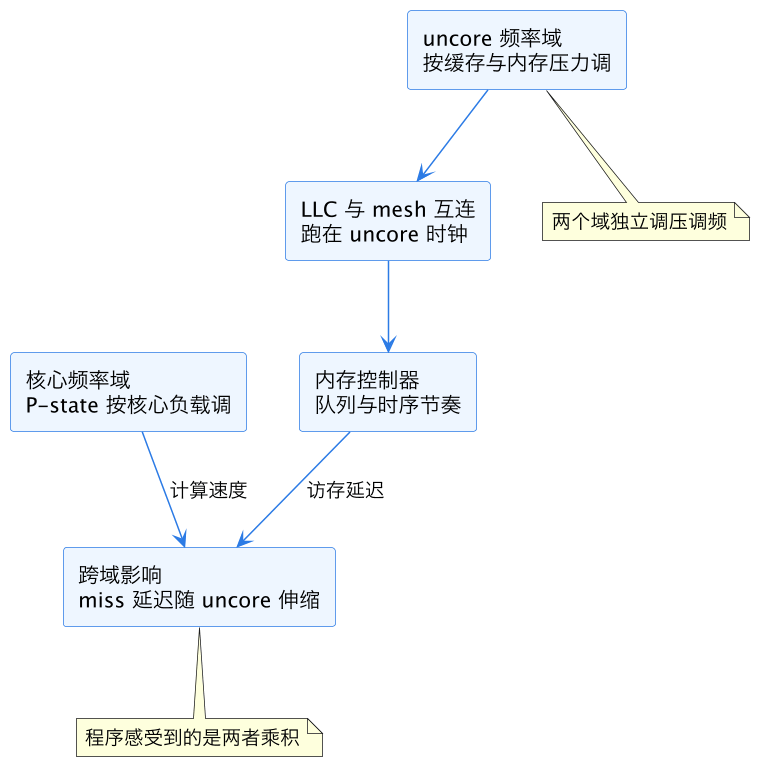
上图是两条频率轴在「程序感受到的性能」这一点的汇合。排查实践中的含义是:当你确认核心频率没问题(performance governor、无节流)但访存延迟仍偏高时,下一个嫌疑犯就是 uncore 频率被节能策略压低了。观察手段:Intel 平台可以用 perf stat 加 uncore PMU 事件(uncore_imc/clockticks/),或直接读 MSR;部分固件允许在 BIOS 里把 uncore 频率钉在最高档。对内存敏感的延迟关键业务,这是一个常被忽略的调优旋钮。
六、落地:频率抖动的排查方法论
前五节把五个零件装进了同一张地图,这一节回答最实际的问题:线上服务延迟抖了,怎么按流程确认或排除 CPU 电源与频率管理这一层。方法论是「先看症状归属,再顺栈逐层证伪」,每一步都有明确的观察工具和判据。
| 步骤 | 检查什么 | 工具与命令 | 判据 |
|---|---|---|---|
| 1 | 核心频率是否真的在期望档 | cpupower frequency-info、turbostat | 实测频率低于 governor 设定即异常 |
| 2 | 是否热节流或功耗墙 | perf stat -e cycles,instructions 加 turbostat 看 PROCHOT 与 RAPL 标志 | 温度逼近 Tjmax 或功耗贴 PL1 |
| 3 | 是否深 C-state 唤醒税 | powertop、turbostat 的 C6 驻留比例 | 低负载期 C6 占比高且 P99 抖动 |
| 4 | 换挡延迟是否赶上负载突变 | DVFS 频率切换延迟 篇的方法:人为阶跃负载观察频率爬升曲线 | 频率爬升慢于负载到达 |
| 5 | uncore 频率是否被压低 | uncore PMU 事件或 MSR 读数 | 内存延迟高且 uncore 在节能档 |
| 6 | 邻居干扰与混部 | 对比单跑与混跑,参考 Top-Down 分析方法 | 混部时频率与 IPC 双降 |
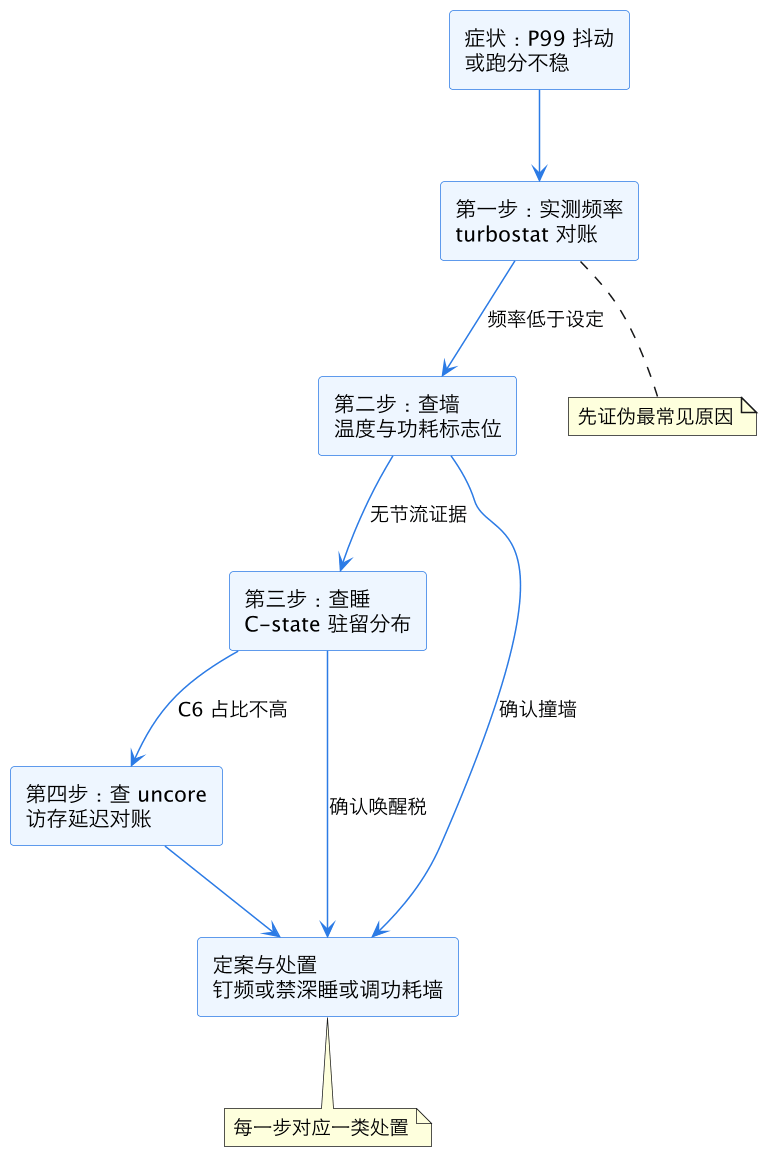
上图是整个排查流程的决策顺序。注意顺序是有讲究的:从最便宜、最常见的原因查起。频率对不上账(步骤 1)两分钟就能用 turbostat 确认;温度墙(步骤 2)看一眼传感器读数就有;C-state 税(步骤 3)需要低负载窗口的驻留统计;uncore(步骤 4)需要专用计数器,放最后。每一步阳性都有对应的处置:撞温度墙就检查散热器贴合与风道、降 PL2 换稳定;撞功耗墙就评估提 PL1 或接受可持续频率;C-state 税就 max_cstate 限深或绑核隔离;uncore 低就在 BIOS 钉档。
处置之外还有一层「防患于未然」的工程实践值得交代。延迟敏感服务的标准姿势是组合拳:性能 governor 钉频率、启动参数限制最大 C-state、BIOS 里 uncore 钉最高档、关键线程绑核隔离,再配合 rq 级的负载均衡关闭(isolcpus 加 nohz_full 加 rcu_nocbs 三件套),把「核的状态变化」这个变量从系统里彻底拿掉。这样换来的确定性是有标价的:实测整机功耗会上升 30-60%,对机架电费和散热都是真金白银。所以更精细的做法是按业务分级——延迟关键的少数核走全锁定配置,吞吐型的大量核保持节能策略,同机混合。这正是 CPU 电源与频率管理机制给工程师留出的操作空间:它不是非黑即白的开关,而是一组可以按核、按域、按时间分别调参的旋钮。
最后把排查中常见的几种「假象」列出来避坑:虚拟化环境里看到的频率可能是宿主机的口径,guest 内的 governor 设置未必生效;scaling_cur_freq 是内核认为的频率,实际频率以 aperfmperf 或 turbostat 的实测为准,两者可能差很远;睿频是「最多几个核能同时睿频」的分档表,全核 AVX 负载下的全核睿频才是可持续数字,拿单核睿频当容量规划依据必翻车。这些口径问题在 perf 计数器与 PMU 编程 的计数语义讨论里有相通之处——测什么、测到的到底是什么,永远是性能剖析的第一问。
这一篇在知识体系里的位置
本篇是微架构模块「功耗与频率」线的枢纽,向上承接 CPU 微架构总览 中「性能不只由流水线决定」的命题,向下分发到四篇零件级深文:睡眠与频率档的硬件实现见 C-state 与 P-state 硬件机制、换挡窗口的量化分析见 DVFS 频率切换延迟、温度保护机制见 温度墙与热节流、电路级省电手段见 时钟门控与功耗门控。横向相关的,是 uncore 频率所作用的物理结构 Uncore 环形与 Mesh 互连,以及定位瓶颈归属时与本篇排查法互补的 Top-Down 分析方法。读完本篇再读任何一篇零件文,都会多一份「这个机制在为谁的功耗预算打工」的全局感。
总结
CPU 电源与频率管理是一场在固定功耗预算里做全芯片分配的博弈:C-state 决定空闲核睡多深(睡越深唤醒税越重),P-state 决定忙碌核跑多快(DVFS 换挡有几十微秒的物理延迟),温度墙与功耗墙从下方否决一切上层意愿(阶梯降频加滞回),uncore 频率独立调节并直接坐在内存延迟的分子上——排查延迟抖动时按「实测频率、查墙、查睡、查 uncore」的顺序逐层证伪,就能用确定的功耗预算换回确定的性能。