CPU 前端流水全景:取指、预测、译码、分发的第一张瓶颈定位地图
更新时间:2026-10-05。本站在前端方向已经攒下一批零件级深文:分支目标缓冲 BTB 讲「跳到哪去」怎么记住,TAGE 分支预测器 讲「跳不跳」怎么猜,返回地址栈 RAS 讲函数返回这条特殊分支,uop cache 与译码前端 讲译码结果的缓存,循环流检测器 LSD 讲小循环的特快通道,x86 预译码位 与 x86 指令长度译码器 ILD 讲变长指令怎么切分,取指重定向与恢复 讲前端跑偏之后怎么掉头。零件都齐了,缺的是一张地图:一条指令的字节从内存进入核,到变成排好队的微操作送进乱序后端,中间到底过了几道关?哪一道关卡住会让 IPC 掉到地板?这篇枢纽文就是这张地图。
本文要回答的问题
- CPU 前端流水完整的一段路有哪几个站点,各自解决什么问题?
- 取指为什么和分支预测焊死在一起,两者谁先谁后?
- x86 的「字节流到微操作」为什么是全流水线最贵的一段,uop cache 和 LSD 各省了哪部分钱?
- 前端瓶颈有哪些典型症状,和后端瓶颈怎么区分?
- topdown 方法里的 Frontend Bound 往下还能拆成哪几类,对应哪些 perf 计数器?
- 拿到一个 IPC 很低的程序,怎么三步定位到前端的具体关卡?
一、全景图:前端的六个站点
先把全篇的主图立起来。现代乱序超标量核(Intel Golden Cove / AMD Zen 4 这一档)的前端,是把「内存里的一串字节」变成「重命名完毕、排进发射队列的微操作」的一段流水线,中间有六个功能站点:
| 站点 | 输入 | 输出 | 一句话职责 | 典型容量/宽度 |
|---|---|---|---|---|
| 取指(Fetch) | 指令缓存行 | 原始字节块 | 每个周期从 L1 I-Cache 取出一个对齐窗口 | 16-32 字节/周期 |
| 分支预测(Branch Prediction) | 取指地址 | 下一个取指地址 | 不等指令译完就猜出下一块从哪取 | BTB 数千项,TAGE 多表 |
| 预译码(Predecode) | 原始字节 | 带边界标记的字节 | 在变长字节流里切出每条指令的头尾 | 预译码位随行进 L2 |
| 指令译码(Decode) | 切分好的指令 | 微操作(uop) | 把 x86 指令翻译成内部定长微操作 | 4-6 宽译码器 |
| 微操作供给(uop cache / LSD) | 地址或循环体 | 已译码微操作 | 命中就绕过译码器直接发货 | uop cache 约 2-4K uop |
| 分发(Allocate / Rename) | 微操作流 | 后端在飞的指令 | 寄存器重命名、分配 ROB 项、送入发射队列 | 6-8 uop/周期 |
这六个站点里有一个反直觉的事实:分支预测在时间上先于译码,但在逻辑上依赖译码。取指单元不会等指令译完才知道往哪取下一块——那样每个 taken 分支都要空转十几个周期。所以预测器和取指是并行工作的:取指地址一出来,BTB 同时查「这个窗口里有没有分支、目标是什么」,TAGE 同时猜「条件分支跳不跳」,如果猜要跳,下一个周期的取指地址就直接换成预测目标。等到几条指令真的译完、发现猜错了,再由译码级或执行级发回一个「重定向」信号,把前端整个扳回正确路径——这就是 取指重定向与恢复 那篇讲的机制,也是前端最贵的自伤动作。
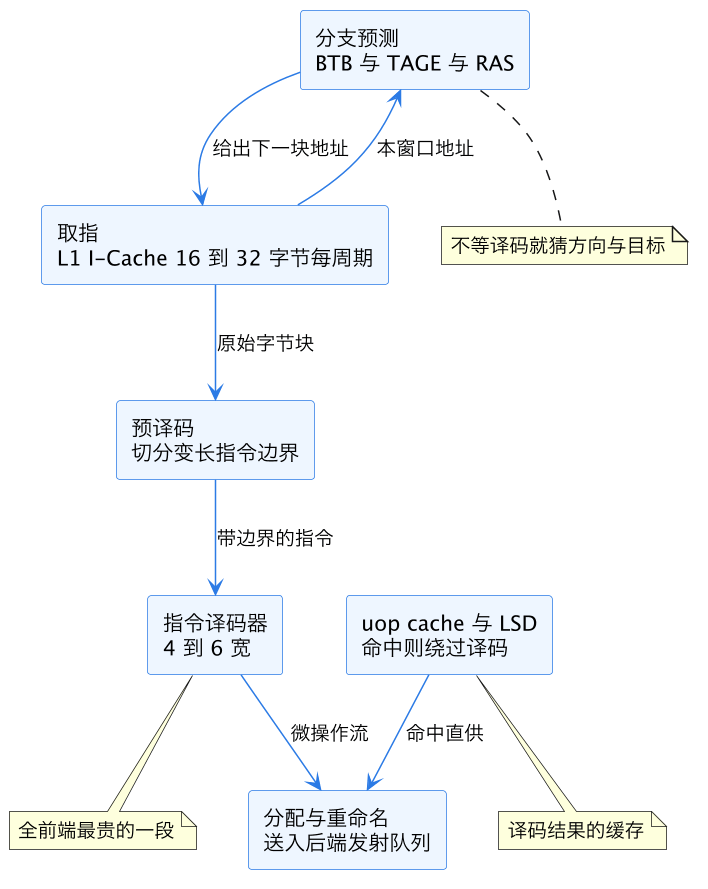
上图是前端的六站主路。注意 bp 和 fetch 之间的双向箭头——这是全图的灵魂:预测器不是译码的下游,而是取指的向导。这张图要记住的另一个要点是 uop cache 的旁路地位:它和译码器是两条并行的供给通道,任何一路都能喂饱分配级,谁的带宽高、谁的命中率高,前端就吃谁的饭。
给这组站点一个量级感:取指级每周期 16-32 字节,对应 x86 平均指令长度下约 4-6 条指令;译码级 4-6 宽;分配级 6-8 微操作。整条链按「最窄的一级」限速——而 x86 前端最窄的一级从来不是取指,是译码,这正是 uop cache 存在的原因。AMD 与 Intel 的布局细节不同(Zen 系的 op cache 容量更大、Intel 的 LSD 在较新核心上已被并入 uop cache 的循环检测),但「取指-预测-译码-分发」的四段骨架两边一模一样,这张地图换平台照用。
二、取指与预测:一对焊死的搭档
取指级的工作看起来最朴素:给地址,拿字节。但它面对一个结构性的难题——程序的字节布局是线性的,执行路径是网状的。一个 16 字节的取指窗口里平均有 3-4 条指令,而服务器代码里平均每 8-15 条指令就有一个分支,意味着几乎每隔两三个取指窗口就遇上一次「下一步去哪」的抉择。如果每次都要等分支译码甚至执行完再决定,前端一大半时间在空转。
硬件的解法是把「去哪」拆成三个子问题,分别交给三个结构:
- 跳不跳(方向):交给条件分支方向预测器,现代旗舰是 TAGE 分支预测器,用多级带历史长度的标记表做多数表决,典型准确率 95-99%。
- 跳到哪(目标):交给 分支目标缓冲 BTB,本质是按取指地址索引的目标地址缓存,数千项。
- 返回到哪:函数返回是间接跳转,目标在调用时才确定,交给 返回地址栈 RAS——call 时压入返回地址,ret 时弹出,对正常调用-返回配对几乎百发百中。
三个结构合起来,让前端在分支指令还没译出来之前就生成下一个取指地址,代价是猜错的惩罚:一次误预测意味着把已经取进来、译了一半甚至执行了一部分的投机指令全部作废,前端从正确地址重新起步,损失 15-25 个周期。误预测率 2% 听起来很小,折算一下:每 10 条指令一个分支、误预测率 2%,就是平均每 500 条指令吃一次 20 周期的冲刷——这还没算 L1 I miss 叠加的放大效应。
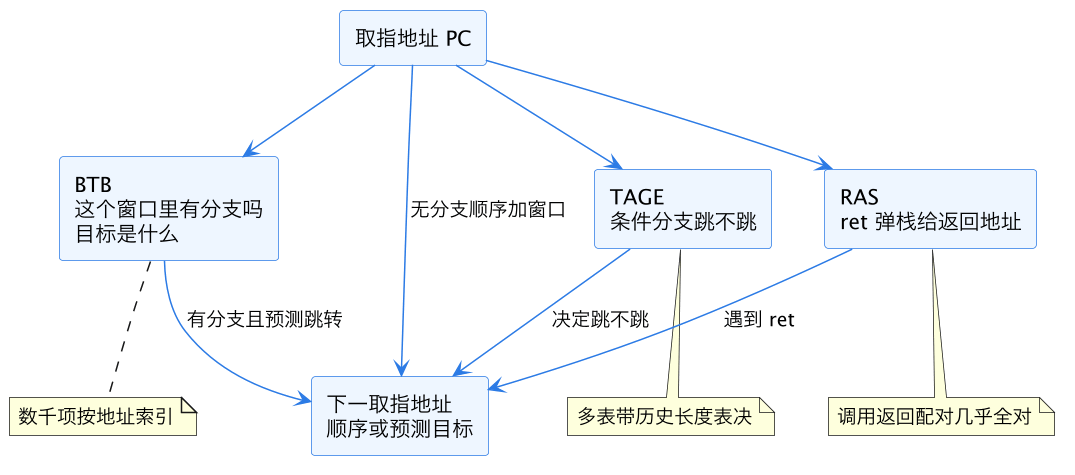
上图是一次取指地址的「三堂会审」。三个预测器并行查询,各自对「下一步去哪」投票,优先级上 RAS 管 ret、TAGE 管条件方向、BTB 提供目标。这套结构有两个对程序员有直接意义的推论。第一,间接分支(函数指针、虚函数、switch 跳转表)是预测器的天敌:BTB 只能记住一个目标,多态热点几个目标轮着出现时命中率骤降,需要专门的间接预测器(ITTAGE,见 间接分支预测器 ITTAGE)才能救回一部分。第二,代码布局本身就是预测器的输入:分支太多、太密、模式太随机的代码,不是「跑得慢」,是「让前端瞎猜」,优化的第一刀常常不是改算法,而是减分支、排布局(PGO/BOLT 干的就是这件事)。
还有一个常被忽视的放大器:指令足迹。预测器和取指都假设 L1 I-Cache 能每周期供货,可服务器应用的指令工作集动辄几 MB,远超 32-64KB 的 L1 I——取指 miss 落到 L2 就是十几周期的断粮,落到 LLC 是三四十周期。足迹大的程序,前端瓶颈往往不是预测不准,而是根本取不到指令。这类问题在 perf stat 里的指纹是 icache_misses 和 frontend_retired.l1i_miss 偏高,对策是让热代码紧凑连续,而不是去改预测行为。
三、译码:x86 最贵的一段路
取到字节之后,前端迎来全流水线物理上最难的一段:把变长的 x86 字节流变成定长的内部微操作。难在两层。
第一层难在切分。x86 指令长度从 1 字节到 15 字节不等,指令里没有任何字段直接告诉你「我有多长」——长度要从前缀、操作码、ModRM、SIB 一路推出来,而且第 N 条指令的起点取决于前 N-1 条的长度,天然串行。这就是 x86 指令长度译码器 ILD 干的活。为了打破串行性,硬件在指令进 L2 时就顺手算好每条指令的边界,把边界标记(预译码位)和指令字节一起存进 L2 和 I-Cache——这就是 x86 预译码位 的机制:用一次性的预译码开销,换掉之后每次取指都要重算的边界推导。
第二层难在翻译。切分好的每条 x86 指令要展开成一到多个内部微操作:简单指令(寄存器加减)1 个 uop,带内存操作数的约 2-3 个,复杂的字符串操作、除法、CPUID 之类直接掉进微码 ROM,一条吐出几十上百个 uop。译码器组是「1 复杂 + N 简单」的非对称结构,比如 1 个能译 4 uop 的复杂译码器配 3-4 个只能译 1 uop 的简单译码器——所以译码带宽是指令混合比的函数:全是简单整数指令能跑满 4-6 uop/周期,混进复杂指令立刻掉档。
这段路贵到硬件厂商专门给它修了两条旁路,这是 x86 前端区别于 RISC 前端的标志:
- uop cache(微操作缓存):把译好的微操作按地址缓存,下次执行到同一段代码直接发货,完全绕过预译码和译码器。命中时供给带宽(每周期 6-8 uop)反而高于译码器本身,详见 uop cache 与译码前端。
- LSD(Loop Stream Detector,循环流检测器):检测到小循环(循环体的微操作能装进队列)时,把整段循环锁在队列里反复重放,连取指都省掉,循环体内前端零取指零译码零预测,详见 循环流检测器 LSD。
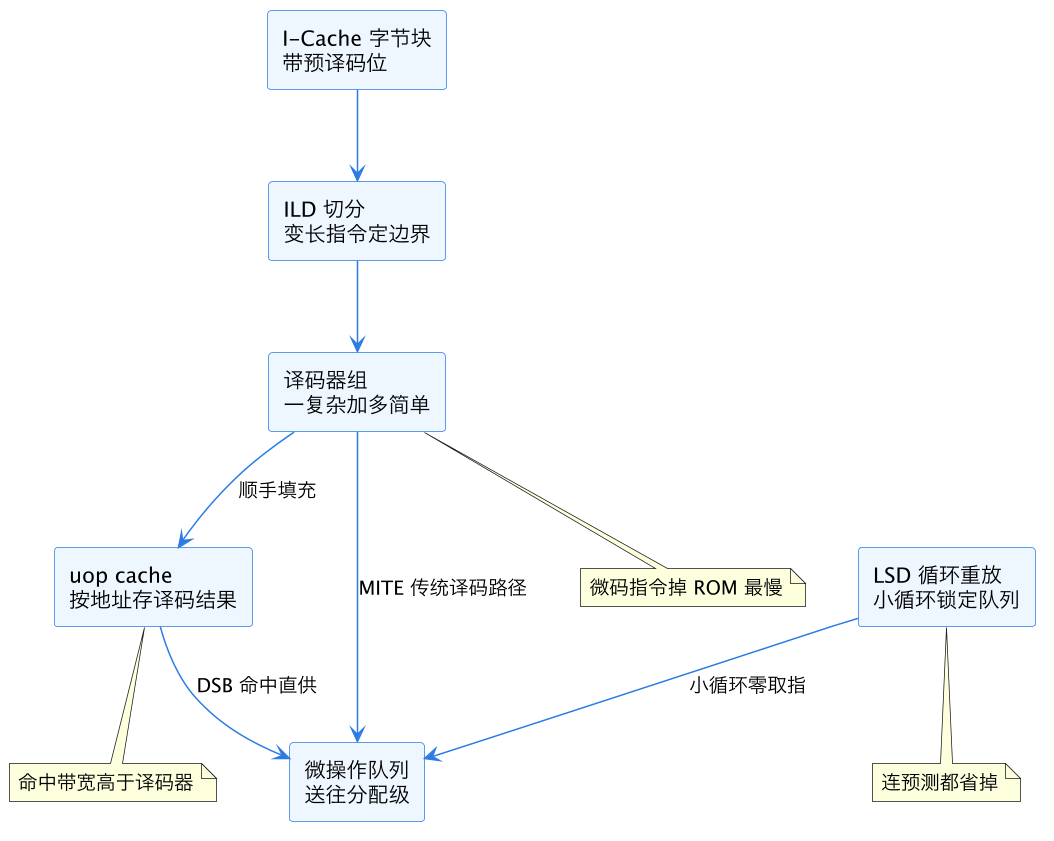
上图是「字节到微操作」的三条供给路径:传统译码路径(Intel 叫 MITE)、uop cache 路径(DSB)、LSD 重放路径。三条路径的带宽和命中率决定了前端的实际供给能力。这张图的实战含义很直接:热循环要小而规整——循环体装进 uop cache(约 2-4K uop)就能享受最高供给带宽;装进 LSD 窗口(几十条 uop)连预测开销都免了;装不进又满是复杂指令的循环,就只能吃译码器的窄带宽。这也是为什么「循环展开太多反而变慢」不是玄学:展开把循环体撑出了 uop cache 容量,供给路径从 DSB 掉回 MITE,每周期少拿两三个 uop。
微码 ROM 是这张图上最暗的角落。一条触发微码的指令(复杂的浮点超越函数、某些字符串指令、TLB 相关的系统指令)会让译码级停顿,从 ROM 里逐拍读出几十上百个 uop,前端带宽瞬间塌方。症状是 idq.ms_uops(来自微码定序器的微操作)计数异常。解法通常不是改微架构,而是换指令——比如用 ERMS 友好的 rep movsb 还是手写 SIMD 拷贝,要看具体平台的微码实现。
四、供给与需求:前端瓶颈和后端瓶颈怎么分
地图画完,进入诊断学。前端的本质角色是供应商:它每周期最多供给 4-8 个微操作,后端的乱序引擎是消费者。IPC 低只有两种宏观原因:供不上(frontend bound)或吃不下(backend bound),区分它们是 topdown 分析方法 的第一层判据,也是一切前端优化的前提——方向错了,优化全是负功。
判据本身一句话说清:看微操作槽位的浪费发生在「没货发」还是「发了白搭」。topdown 把每个周期理论上的发射槽位分成四桶:Retiring(干活的)、Bad Speculation(猜错浪费的)、Frontend Bound(想发射但前端没供上 uop)、Backend Bound(uop 有了但后端资源堵着发不出)。Frontend Bound 占比高,说明分配级经常空等——上游某个站点断粮了。
前端断粮的症状学,按关卡对号入座:
| 症状(perf 指纹) | 病灶关卡 | 典型根因 | 第一刀对策 |
|---|---|---|---|
| branch-misses 占分支数 >3% | 预测器 | 随机分支、间接分支、深调用 | 减分支、PGO、查 ITTAGE 压力 |
| icache miss 与 L2 取指占比高 | 取指 | 指令足迹太大、热代码分散 | 代码布局优化、PGO/BOLT |
| DSB 覆盖率低、MITE 占大头 | 译码 | 热循环太大、复杂指令多 | 精简循环体、换简单指令 |
| idq.ms_uops 占比高 | 微码 ROM | 掉微码的指令 | 换指令实现 |
| LSD 覆盖率异常低 | LSD | 循环体超窗口、循环内有函数调用 | 拆循环、内联小函数 |
| frontend 空泡集中在分支密集处 | 重定向 | 预测恢复延迟长 | 见 取指重定向与恢复 |
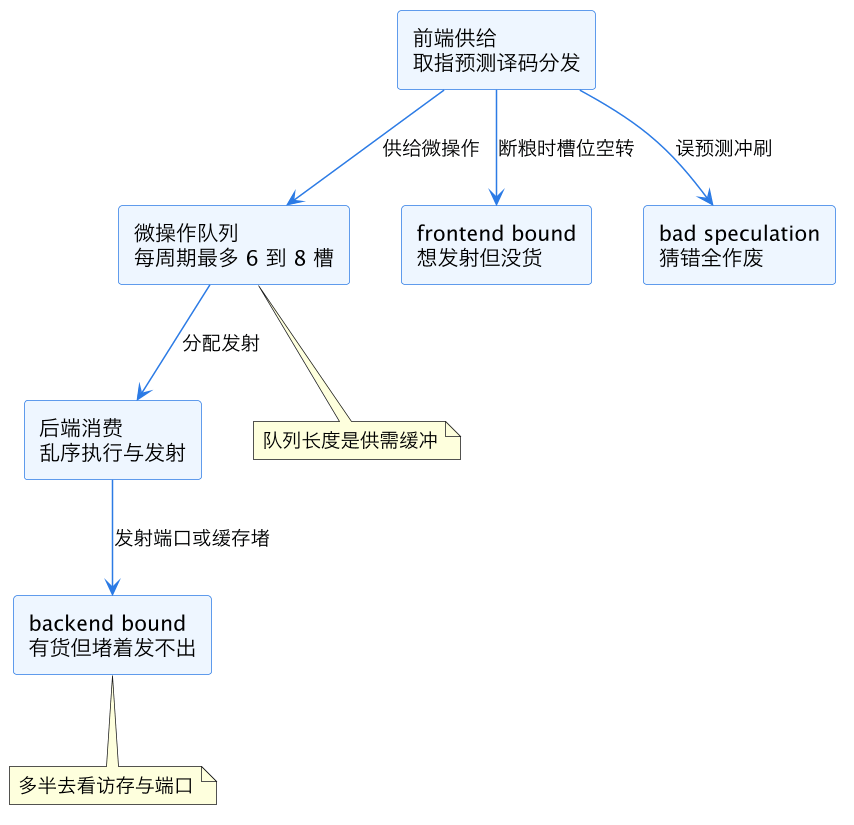
上图是供需视角的前端定位。一个实用的心法:Frontend Bound 和 Bad Speculation 常常是同一个病的一体两面。误预测在 topdown 里计入 Bad Speculation,但误预测引发的重定向同时制造前端空泡——前端从正确路径重新取指、重新译码的那十几个周期里,供给是零。所以看到 Bad Speculation 偏高时,不要只盯着「猜错浪费了多少」,还要算「恢复过程饿死了多少槽位」。取指重定向与恢复 那篇的核心就是这段恢复路径上每一拍花在哪:谁在哪个流水级发现了错误(译码级早发现损失小、执行级晚发现损失大)、重定向请求怎么插队回取指级、投机路径上已经进 uop cache 的错误条目要不要清。
区分 frontend 与 backend 还有一个零成本的快速判据:改变前端供给,看 IPC 动不动。给热循环做手动对齐、或把循环拆小让它进 LSD,如果 IPC 明显上升,前端有瓶颈;纹丝不动,说明后端才是短板,去查访存和端口竞争(见 IPC 瓶颈分析 与 执行端口竞争)。这是「先做可逆的小实验再动大手术」的调优纪律在前端领域的具体化。
五、把 Frontend Bound 拆开:五大子类与计数器
topdown 第一层说「前端有问题」之后,真正值钱的是第二层:Frontend Bound 往下还能拆成五类,每类的计数器、根因、对策完全不同。
第一类,取指延迟型(fetch latency)。前端空泡的原因是「想取但取不到」:L1 I-Cache miss 落到 L2/LLC,取指级断粮。指纹是 frontend_retired.l1i_miss、icache_64b.iftag_miss 偏高,以及 topdown 的 fetch latency 子项主导。根因几乎总是指令足迹超过 L1 I——大型单体服务、模板膨胀的 C++、解释器主循环都是常客。对策是代码布局:PGO 把热路径排连续,BOLT 做函数级重排,__builtin_expect 把冷分支挪出直线。
第二类,取指带宽型(fetch bandwidth)。取指没 miss,但每周期供的字节或微操作就是不够:DSB 覆盖率低、被迫走 MITE 译码路径、或译码器遇到复杂指令掉档。指纹是 idq.dsb_uops 占比低、idq.mite_uops 占主导,topdown 的 fetch bandwidth 子项偏高。对策是精简热循环的指令数和复杂度,让供给路径升级(MITE 升 DSB、DSB 升 LSD)。
第三类,分支误预测连带型。前面说过,误预测的恢复空泡算在前端账上。指纹是 br_misp_retired.all_branches 与 machine_clears 相关计数高,且 Bad Speculation 与 Frontend Bound 同时偏高。对策回到第二节:减分支、把数据相关分支改查表/无分支写法、间接分支多的热点做去虚拟化或手写下发表。
第四类,微码与机器清空型。idq.ms_uops 高说明频繁掉微码 ROM;machine_clears.count 高(内存消歧误伤、SMC 自修改代码、浮点辅助异常)说明前端在被「整管冲刷」——machine clear 比分支误预测更贵,冲刷的是整条流水线而不只是前端。自修改代码(某些 JIT、动态插桩)触发的 SMC clear 一次就是几百周期。
第五类,译码器特殊限制型。x86 还有一些生僻但真实的译码断点:长度变更前缀(LCP)停顿——指令里立即数/位移的长度因为 16 位前缀在预译码之后发生变化,ILD 的预译码边界作废,整条指令重走,一次十几周期;DSB 与 MITE 路径切换时的清空;跨 64 字节边界的指令取指拆窗。这些在计数器上的指纹是 ild_stall.lcp、decode 相关 stall 事件,对策是避免在热代码里生成带 0x66 前缀的立即数指令(编译器偶尔会为对齐造出这种指令)。
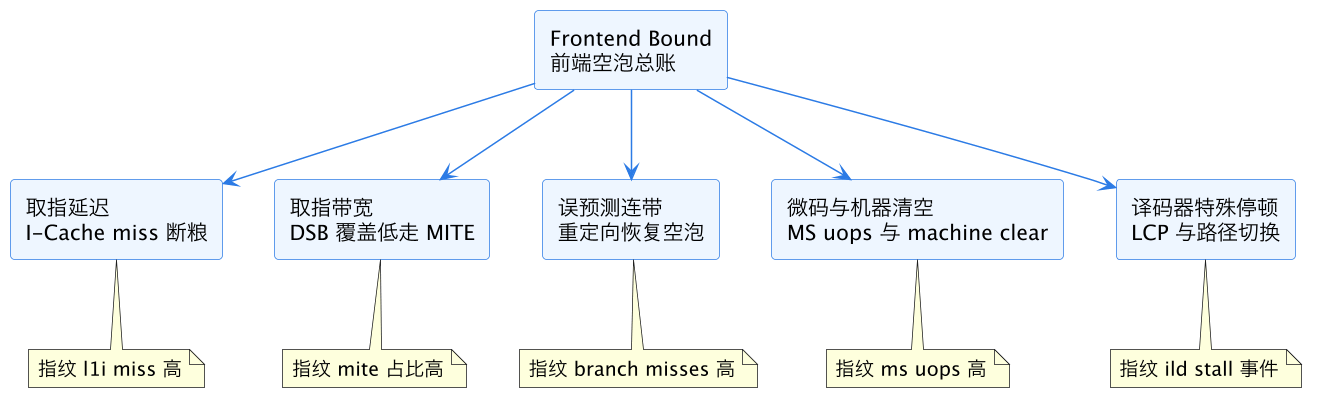
上图是 Frontend Bound 的五叉分解树。用法是自顶向下:先 perf stat 拿 topdown 第一层确认 Frontend Bound 偏高(经验上超过 15-20% 就值得钻),再按五个指纹计数器各查一遍,占比最大的子类就是主病灶。这五类之间经常并存——比如足迹大的程序既 miss 又走 MITE——但一定有一个主项,先打主项。
值得单独强调的是第一类和第二类的区分,因为它们的对策方向相反时也不少见:取指延迟型要「让热代码更紧凑」(减总量),取指带宽型有时要「让循环进 DSB」(改结构,甚至可能略增总量换供给路径)。只看「前端瓶颈」四个字就开优化,很容易把延迟型当带宽型治——给一个大足迹程序拼命做循环拆分,结果 uop cache 是被小循环喂满了,I-Cache miss 却一个没少,IPC 原地踏步。
六、用这张地图做定位:前端瓶颈三步法
把前五节收成一个可执行流程。拿到一个「IPC 低、疑似前端问题」的程序,按三步走。
第一步,定性:前端到底有没有锅。 perf stat 跑一把,看 IPC 和 topdown 第一层(支持 topdown 的平台用 perf stat --topdown,不支持的用 perf record 加 cycles、instructions、idq_uops_not_delivered.core 手工算)。idq_uops_not_delivered 这个事件直接数「分配级想要 4 个槽位但前端只给了 N 个」的差额,是前端供给不足最硬的证据。Frontend Bound 低于 10%,前端无罪释放,去查后端;高于 20%,前端是主犯或主犯之一。
第二步,分层:五个子类哪个是主项。 按第五节的指纹计数器逐项查:icache 相关事件查取指延迟,dsb/mite/ms 三个 uops 来源计数查供给路径,branch-misses 查误预测,machine_clears 查整管冲刷,ild_stall 查译码断点。同时看一眼 Bad Speculation——它和前端空泡经常同根。这一步的产物是一个主病灶加若干次要项。
第三步,对症:先算后改。 对照第四、五节的对策表选刀,改之前先估算收益上限:比如 DSB 覆盖率从 30% 提到 80%,供给带宽从约 4 uop/周期提到 6+,理论上前端供给能力涨 50%——但如果你的程序 Frontend Bound 只占 20%,天花板收益就是 10% 上下,别期待翻倍。改完重跑第一步的计数器验证,形成一个闭环。
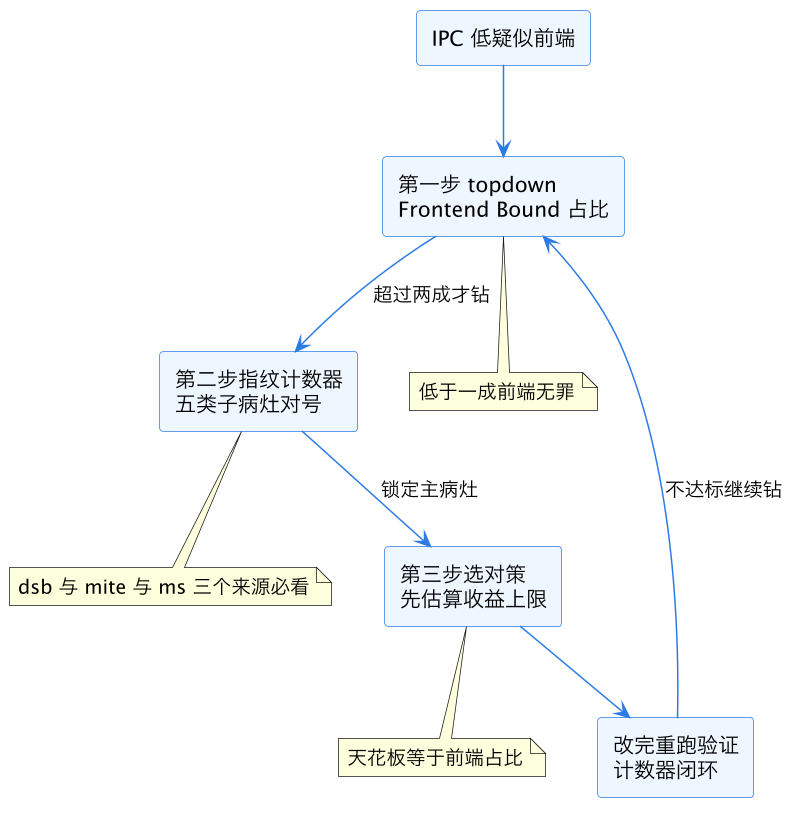
上图是三步法的流程闭环,注意最后的回边:前端优化很少一刀见效,常常是「打一个主病灶,次病灶升上来成为新主项」——足迹缩小后 I-Cache miss 降了,原来被掩盖的译码带宽问题浮出来,循环一轮。这是正常现象,不是失败:每一轮都让 Frontend Bound 的绝对占比下降,直到它跌出主要矛盾。
给一个真实形态的推演把三步法走完:一个模板用猛的 C++ 微服务,P99 毛刺,perf stat 显示 IPC 0.9、Frontend Bound 28%、Bad Speculation 18%——前端有锅且不小。第二步查指纹:l1i_miss 高、DSB 覆盖率 25%、branch-misses 2.8%。主病灶判定为取指延迟型(足迹太大)加误预测连带。第三步选刀:先上 PGO 重排热路径,把热函数聚簇、冷错误处理路径挪走——这一刀同时治两个病灶,因为热代码紧凑后 I-Cache miss 降、分支密度也降。重跑验证:Frontend Bound 掉到 14%,IPC 上到 1.2,P99 毛刺明显收敛。全程没改一行算法逻辑,动的全是代码布局——这正是前端优化和后端优化最大的气质差别:前端问题的解法经常是「把代码摆对位置」,而不是「让代码算得更快」。
这一篇在知识体系里的位置
本篇是 concepts/microarch 目录下前端主题的枢纽,往上承接 CPU 微架构总览 的整管视角和 topdown 分析方法 的第一层判据,往下分发到八篇零件深文:方向预测看 TAGE 分支预测器,目标预测看 分支目标缓冲 BTB,返回预测看 返回地址栈 RAS,间接分支看 间接分支预测器 ITTAGE,译码缓存看 uop cache 与译码前端,循环重放看 循环流检测器 LSD,变长切分看 x86 预译码位 与 x86 指令长度译码器 ILD,跑偏恢复看 取指重定向与恢复。横向对比看访存侧的姊妹地图 访存层级延迟带宽全景——前端管「指令从哪来」,访存管「数据从哪来」,两张地图合起来覆盖 topdown 的绝大多数主病灶。工具侧落地配合 perf 使用指南 的计数器实操。后续前端方向长出新的零件深文(如 FTQ、分支历史寄存器长度、预测器别名干扰)时,本篇的站点表和内链清单同步更新,保持地图始终完整。
总结
CPU 前端流水的全部要点是一张六站地图加一条供需心法:取指、分支预测、预译码、译码、uop cache 与 LSD、分发六站把内存字节变成排队的微操作,预测器与取指焊死并行工作、译码是 x86 最贵的一段、uop cache 和 LSD 是绕开它的两条旁路;定位瓶颈先按 topdown 分清前端供给不足还是后端消费堵塞,前端再用取指延迟、取指带宽、误预测连带、微码冲刷、译码特殊停顿五类指纹对号,三步法定出主病灶后先算收益上限再动刀——而前端问题的解法多半是「把代码摆对位置」,不是「让代码算得更快」。