C-state 退出延迟表:C1/C1E/C6 各档唤醒成本与调度器选择逻辑
承 pm-cstate-pstate-hw 对 C-state/P-state 硬件机制的介绍,以及 monitor-mwait-tpause-wait 对 MWAIT 等待指令的讨论。省电与延迟是一对天生的冤家:核睡得越死,醒来越慢。C-state 退出延迟表(exit latency table)就是这笔交易的价目单——操作系统 cpuidle 子系统每天照着它做几十亿次「睡多深」的决策,延迟敏感服务的抖动根因也常常埋在这张表里。
本文要回答的问题
- C1/C1E/C6/Package C-state 各档睡眠到底关了什么?退出延迟各是多少?
- 一次唤醒的延迟由哪几段硬件动作构成?
- Linux cpuidle 调速器怎么拿这张表做「睡哪档」的决策?
- 这张表对 P99 延迟的真实影响长什么样?怎么测量?
- 延迟敏感服务该怎么调:禁多深、怎么禁、代价多大?
一、档位与延迟:一张量级表
C-state 的编号语义各代略有出入,但主流 Intel 服务器/桌面平台的量级是稳定的:
| 档位 | 关闭内容 | 典型退出延迟 | 省电幅度 |
|---|---|---|---|
| C0(运行) | 无 | — | 基准 |
| C1(HLT) | 核时钟门控 | ~1-3 周期级(亚微秒) | 小 |
| C1E(增强) | C1 + 降电压到最低档 | ~10-20 周期级 | 中小 |
| C3(部分平台) | L1/L2 时钟停 + PLL 保持 | 数微秒 | 中 |
| C6(核级) | 核电源门控,状态存 SRAM,L1/L2 内容丢弃 | ~10-50 微秒 | 大 |
| C6P/C8/C10(更深) | 更大范围断电 | 数十-上百微秒 | 更大 |
| Package C-state | 整 socket:LLC 部分断电、uncore 降频 | 数百微秒-毫秒级 | 最大 |
三个关键的非直觉点。第一,C1 几乎免费:HLT 只是停时钟,一两条指令的工夫就能醒,任何场景都不该禁它。第二,C6 的贵不在「开机」在「重建」:核电源恢复只要几微秒,但 L1/L2 内容丢了、部分实现里 TLB 与分支预测历史也冷了——醒来的核要从 LLC/内存把热数据重新暖回来,这段「隐性暖机」常比表上的退出延迟更伤。第三,Package C-state 是连坐:一个 socket 所有核都睡了才会进,但它会把 LLC 和 uncore 拖下水(背景见 uncore-frequency-scaling),醒的时候全 socket 的核一起付账。
二、唤醒路径的解剖
以 C6 为例,从中断到达到能执行第一条用户态指令,硬件要做这些事:
- 中断送达 APIC,电源控制单元(PCU)收到唤醒请求;
- 核电源域上电、电压稳定——这是物理过程,微秒级,省不掉;
- 从专用 SRAM 恢复核的架构状态(寄存器、MSR 配置);
- 时钟 PLL 重新锁定,流水线复位后重新取指——分支预测器、TLB、L1i/L1d 全冷;
- 内核 cpuidle 退出路径、中断处理、调度器选核,最后才轮到用户代码。
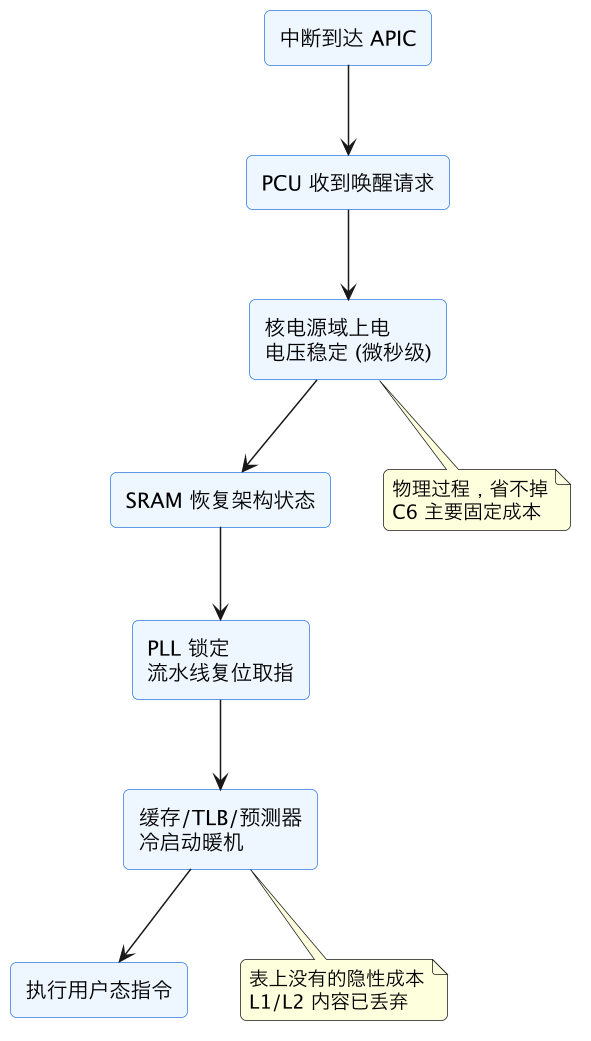
图里要划重点的是 warm 那一段:官方表的退出延迟只数到「核能动」,不数「核跑得快」。实测从 C6 醒来的核,头几百微秒里 IPC 可能是正常值的 60%-80%,因为一切缓存层级都在重新填充。
三、cpuidle 怎么用这张表
Linux 的 cpuidle 子系统为每个档位维护「目标驻留时长(target residency)」——即「预计至少睡多久,进这档才划算」,它基本等于退出延迟的数倍(进出都有成本,要睡够本)。调速器(menu 是主流)每次核空闲时预测「这次会睡多久」,然后选预测时长 ≥ target residency 的最深档。
决策错的两种姿势正好对应两类线上症状。预测偏短选了深档:刚睡下就被叫醒,白付一轮进出成本,还加了延迟尾;预测偏长选了浅档:省电机会流失。menu 调速器靠历史间隔修正预测,但突发性的小包业务(高频短间隔)是它的天敌——上一轮睡了 5ms 预测这轮也长,结果 50µs 后包就到了,核正在 C6 里做上电体操。
还有一个更微妙的变量:中断到达模式本身会被调度器反馈改变。如果业务用 timer 周期性唤醒(比如每 1ms 一次的健康检查线程),menu 会学到「间隔约 1ms」,选档围绕它展开;一旦真实业务请求的到达间隔分布与 timer 间隔错位(双峰分布),预测会在两峰之间来回横跳、两头都不讨好。这类场景下「给 cpuidle 更干净的信号」比换调速器更管用——合并 timer、用 timer slack 聚合唤醒点,让睡眠间隔分布收窄,预测自然准。
手工查这张表:/sys/devices/system/cpu/cpu0/cpuidle/state*/ 下每个 state 目录有 name、latency(微秒)、residency(目标驻留),disable 写 1 可单独禁档。turbostat 能看实际进入各档的占比与平均驻留时长——这是判断「表上的决策和真实负载是否匹配」的第一手工具。
四、一个可复现的尾部延迟实验
想亲手看到这张表的价格,实验不需要任何特殊硬件:一台开着默认 cpuidle 的 Linux 机器,跑一个最简单的 ping-pong 延迟测试——客户端每秒发固定数量的小请求(比如 100 QPS,低到核有空闲),服务端记录每个请求的处理时间戳。
第一组,默认配置。看延迟直方图:大部分请求几十微秒,但尾部会冒出一批 100-500 微秒的 outliers——它们就是落在刚睡熟的核上的请求。把采样拉到小时级,还能看到一个反直觉形态:QPS 越低,P99 越差,因为核睡得更熟更深。
第二组,限档对照。逐 state 禁掉 latency 大于 10µs 的档(echo 1 > /sys/.../stateN/disable),重跑同一压测。典型结果:P50 纹丝不动,P99 砍掉一截,P99.9 几乎抹平——这一刀精确地只切尾部,正好印证了「C-state 是尾部问题」的论断。
第三组,暖机可视化。给被唤醒的核上跑一个固定的小计算循环,记录从唤醒到 IPC 恢复正常的时长(用 perf stat -e cycles,instructions 按 100µs 窗口采样),能看到几十到几百微秒的「爬坡段」——这就是表上没有、但真实存在的暖机成本。
五、对 P99 的真实影响与测量
C-state 对延迟的影响特征鲜明:它打的不是平均延迟,是尾部。平均请求路径上核多半醒着;挨打的是「系统安静了一小会儿,第一个到来的请求」——它正好付全额唤醒账。典型表现:低负载时 P99 反而比中负载差;延迟直方图在 P99-P99.9 处有一个「唤醒价」高度的台阶。
测量套路两个。一是对比实验:perf stat 看不着它,直接跑业务压测,分别在「默认 cpuidle」「intel_idle.max_cstate=1(或逐 state disable)」两组下比 P99/P999,差值就是这张表的真实价格。二是内核侧观察:turbostat 的 C6% 列与业务 QPS 曲线对着看,C6 占比高的时间窗若与延迟尖刺对齐,因果基本坐实。相关背景:DVFS 的频率切换也有类似的尾部效应,见 dvfs-frequency-transition-latency。
五、延迟敏感服务的调优清单
- 分层禁用,别一刀切。先禁 Package C-state 和最深核档(
latency> 50µs 的),保留 C1/C1E——白捡的省电别扔;P99 仍不达标再往浅砍。 - 用
dev_pm_qos/intel_idle的 per-CPU disable 做精细化:跑网络中断和关键线程的核浅睡,批处理核照常深睡。 - 配合 busy-poll 替代方案评估:
SO_BUSY_POLL、DPDK 轮询这些「干脆不睡」方案消灭了唤醒延迟但烧满核——只有微秒级 SLA 值得这么做,算电费和核数账。 - 盯暖机成本而不只退出延迟:禁用 C6 后 P99 若没完全恢复,可能残留的是缓存冷启动,考虑提高中断亲和性让热数据留在固定核的缓存里。
- 验收指标用 P99.9 而不是平均值——这张表本来就是一个尾部问题。
这一篇在知识体系里的位置
C-state/P-state 硬件机制见 pm-cstate-pstate-hw,MWAIT/TPAUSE 等主动等待指令见 monitor-mwait-tpause-wait,频率切换的类似尾部效应见 dvfs-frequency-transition-latency,功耗管理全景见 cpu-power-frequency-management,时钟/电源门控基础见 microarch-clock-power-gating。
总结
C-state 退出延迟表是省电与延迟的价目单:C1 近乎免费、C6 数十微秒外加缓存暖机的隐性成本、Package 档连坐全 socket;它伤的是延迟尾部而非均值,延迟敏感服务的正确姿势是按 latency 列分层禁档、用 P99.9 验收,而不是一口气全关或全盘默认。