AMX 矩阵扩展:tile 寄存器架构、TILECFG 配置与 INT8/BF16 推理加速全解
更新时间:2026-10-02。CPU 微架构总览 给出过一条演进主线:通用核的算力增长,近十年主要靠「一条指令处理更多数据」——从标量到 SSE、AVX2、AVX-512,SIMD 宽度一路翻倍(向量执行单元本身见 向量 SIMD 执行单元)。但向量终究是一维的:一条 AVX-512 指令最多同时处理 16 个 32 位元素。矩阵乘却是二维的活,拿一维指令拼二维运算,大量周期花在数据搬移和地址计算上。Intel 在 Sapphire Rapids(2023)给出的答案是 AMX(Advanced Matrix Extensions)矩阵扩展:一组真正的二维 tile 寄存器加一个专门的矩阵乘加单元,把 INT8 矩阵乘的吞吐一口气推高到 AVX-512 VNNI 的 8 倍左右。这一篇讲它的硬件结构、配置机制、编程模型,以及它为什么特别适合 AI 推理。
本文要回答的问题
- AMX 的 tile 寄存器长什么样,为什么说它是「二维」的寄存器?
- TILECFG 是什么,为什么用 AMX 之前必须先配置,配置错了会怎样?
- 一条 TDPBUSD 指令到底做了多少乘加运算,性能数字是怎么算出来的?
- 用 AMX 写程序的完整流程是什么,操作系统在这里面扮演什么角色?
- AMX 和 AVX-512 VNNI、GPU 各适合什么场景,选型时怎么判断?
一、tile 寄存器:从一维向量到二维矩阵
AMX 最显眼的变化是新增了一组寄存器:TMM0 到 TMM7,共 8 个 tile 寄存器。每个 tile 最大 16 行、每行 64 字节,即 1024 字节,8 个一共 8KB。对比一下:AVX-512 的 32 个 zmm 寄存器每个 64 字节,总共 2KB。AMX 的寄存器堆是向量寄存器的 4 倍,而且组织方式根本不同——向量寄存器是「一条 512 位的线」,tile 寄存器是「一块 16 行 64 列的面」。
这个「面」的形状不是焊死的。16 行 64 字节是上限,实际形状由软件通过配置寄存器 TILECFG 动态指定:每个 tile 各有独立的行数(rows,0-16)和每行字节数(colsb,0-64)。比如做 INT8 矩阵乘时,常用 16 行 64 字节(一个 16×64 的 int8 块)装 A 矩阵、同样规格装 B 的重排块、16 行 64 字节(即 16×16 个 int32 累加器)装 C 的结果块。tile 形状随数据类型和分块策略变化,这是 AMX 与「固定形状矩阵单元」(如某些 NPU 固定 4×4)的关键区别——形状可编程,硬件只负责按配置的形状做搬运和乘加。
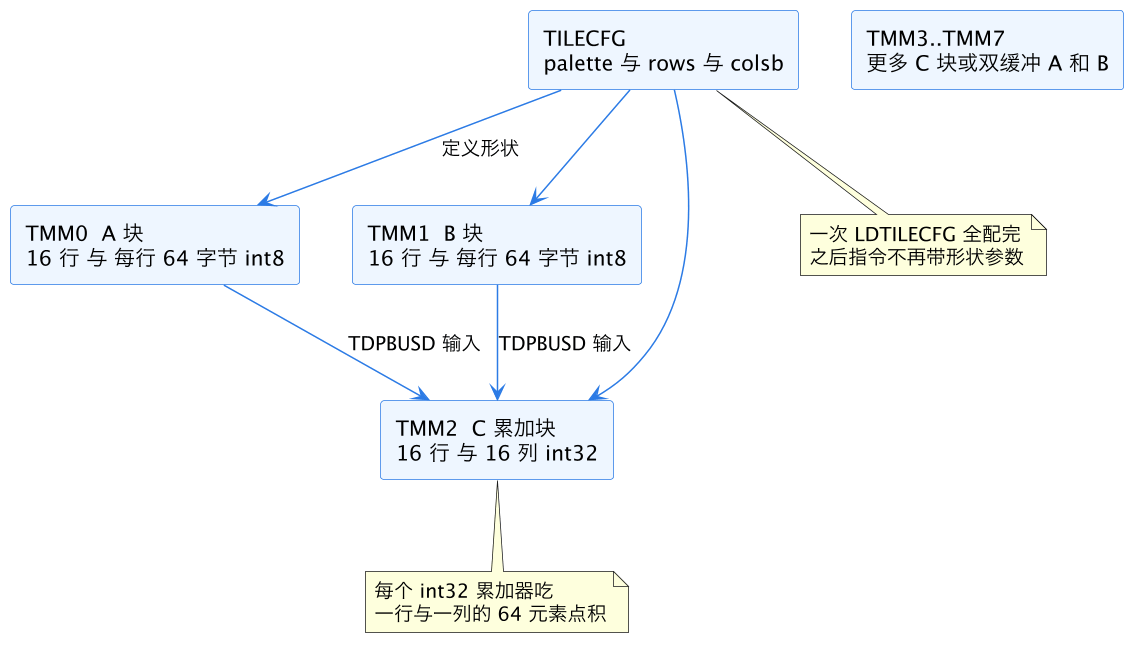
上图是一个典型的 INT8 GEMM 内层:TMM0/TMM1 装两个输入块,TMM2 装累加块。tile 寄存器的第二个要点是「配置一次,指令极简」——所有 tile 指令(加载、存储、乘加)都只带寄存器号,形状信息全部从 TILECFG 隐式读取。这让 AMX 指令的编码非常短,译码压力小,一条指令就干一整个块的活。
二、TILECFG 与 palette:先声明形状,再动手
AMX 的编程纪律从 LDTILECFG 开始。这条指令从内存读一个 64 字节的配置块写进 TILECFG,配置块里有三个关键内容:palette_id(调色板编号,目前只有 1 有效,表示「8 个 tile 可用」)、startRow(供中断恢复用的起始行,正常填 0)、以及 8 个 tile 各自的 rows 和 colsb。
为什么非要先配置?两个原因。其一,硬件需要知道每个 tile 的有效形状才能正确处理加载的步进和乘加的累加边界;形状不在指令里,就必须有地方放。其二,也是更微妙的:配置本身是「启用 AMX」这个动作的开关。TILECFG 处于 INIT 状态(全零)时,执行任何 tile 数据指令都会触发 #NM 异常;LDTILECFG 配好非零 palette 后才解锁。反过来,TILERELEASE 指令把 TILECFG 清零、把所有 tile 标记为无效,显式交还——操作系统上下文切换时看到 INIT 状态就知道不用保存那 8KB 寄存器,这是省电和省切换时间的合谋。
配置出错的行为也很干脆:rows 超 16、colsb 超 64、palette 非法,LDTILECFG 直接 #GP 异常。没有任何「尽力而为」的解释空间——配置协议严格,换来的好处是后续每条指令都不必再校验形状。
还有一个教科书不太爱提、调试时却经常咬人的细节:TILECFG 和 tile 数据是两份独立的状态。LDTILECFG 只写配置,不清数据——重新配置形状后,旧 tile 里残留的字节会按新形状被重新解释。想要干净的累加起点,必须显式 TILEZERO 把目标 tile 清零,而不能指望「重配一次就归零」。这个语义在 K 维分块的 GEMM 里恰恰是有用的:A、B 的形状从头到尾不变,只需要每个输出块算完后 TILEZERO 一次 C,而不是整条流水线推倒重来。
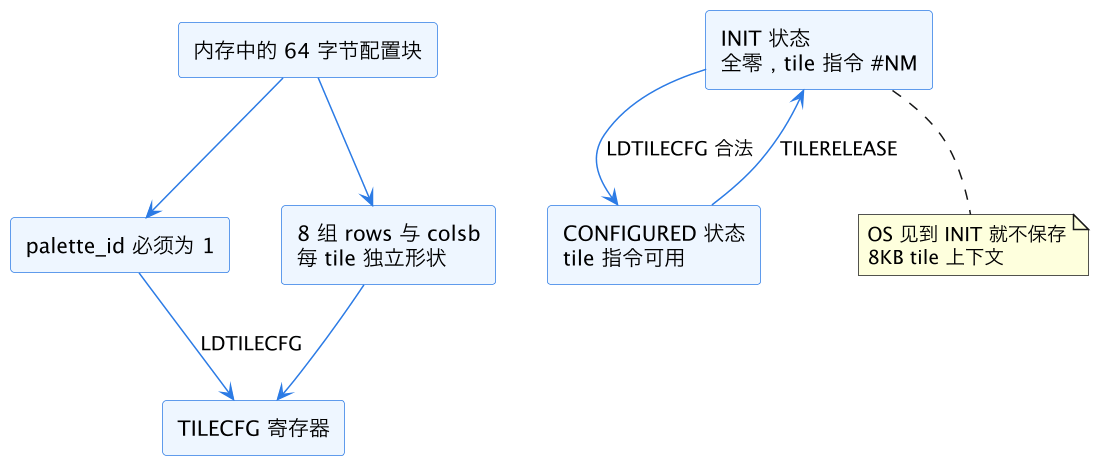
上图是 TILECFG 的状态机与数据流。可以把 LDTILECFG 理解成一次「声明式编程」:先用 64 字节声明整个矩阵单元的几何,然后一小撮动词(load、dot、store、zero)在这个几何上操作。这种「配置与操作分离」的设计,在指令集史上并不多见,它更像 GPU 里 kernel launch 前设定 grid/block 的思路被搬进了 CPU 指令集。
三、TDP 指令族:一条指令一万次乘加
AMX 的计算指令只有一个动词家族:TDP(Tile Dot Product,tile 点积)。四个变体对应推理最主流的数据类型组合:
| 指令 | 输入类型 | 累加器 | 单条指令乘加量 | 典型场景 |
|---|---|---|---|---|
| TDPBSSD | int8 与 int8 | int32 | 16×16×64 = 16384 MAC | 全量化 INT8 推理 |
| TDPBUSD | uint8 与 int8 | int32 | 16384 MAC | 量化推理(激活 uint8) |
| TDPBSUD | int8 与 uint8 | int32 | 16384 MAC | 量化推理的另一朝向 |
| TDPBF16PS | bf16 与 bf16 | fp32 | 16×16×32 = 8192 MAC | BF16 训练与推理 |
以 TDPBUSD 为例,语义是:取 src1 tile 的每一行(64 个 uint8)与 src2 tile 重排后的对应列做 64 元素点积,结果按 int32 累加进 dst tile 的对应位置——一条指令完成 16×16 个 int32 累加器各自的 64 元素点积更新,合计 16384 次乘加。Sapphire Rapids 每个核有一个 TMUL 单元,TDPBUSD 吞吐约每 16 周期一条,折合约每周期 1024 个 INT8 MAC;作为对照,AVX-512 VNNI 的 VPDPBUSD 每周期 2 条、每条 64 个 MAC,合计 128。8 倍差距就是这么来的——不是单条指令更宽,而是「一条指令指挥的运算阵列」整整大了一个数量级。
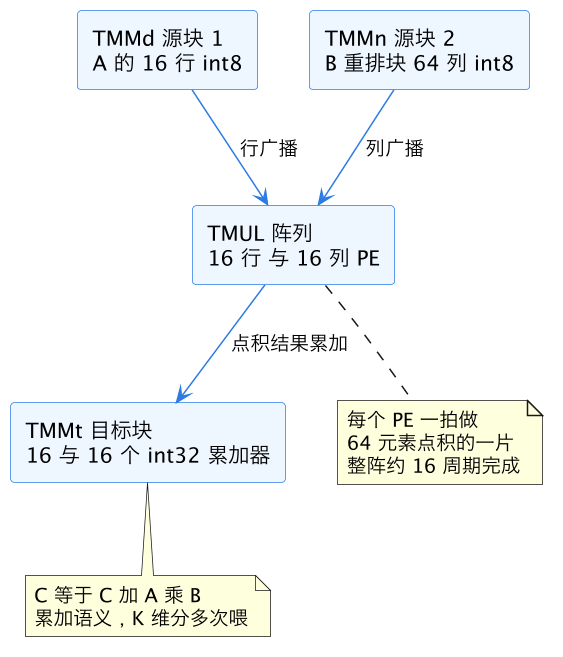
上图是 TDP 的数据流。注意「累加语义」:dst 是 C = C + A×B,不是覆盖写。这是为了支持 K 维(reduction 维)分块——一个 K=1024 的矩阵乘,拆成 16 个 K=64 的 TDP 连续打进同一个 C tile,中间结果零搬运。对比 AVX-512 写法:同样一个 16×16 输出块,需要 16 条向量寄存器装 C 的行,每步做 16 次 broadcast-FMA,寄存器压力山大、中间结果在寄存器堆里反复周转。AMX 把「累加驻留」做成了指令语义,这就是二维寄存器堆的价值。
TDPBF16PS 那一行值得单独说两句。BF16(bfloat16,脑浮点格式)把 fp32 的 32 位砍成 16 位——砍掉的是尾数低 16 位,指数位宽原样保留。动态范围和 fp32 一样,只是精度粗了,而神经网络恰恰对精度不敏感、对范围敏感,这是它在 AI 圈流行的原因。TDPBF16PS 的输入是两个 bf16 tile(每行 64 字节 = 32 个 bf16),累加器却是 fp32——低精度输入、高精度累加,训练圈管这个叫 mixed precision,AMX 把它做成了硬件默认行为,软件不需要像 AVX-512 BF16 扩展那样手工穿插转换指令。每行 64 字节在 bf16 下是 32 个元素,所以单条指令的 K 维深度是 32,MAC 总数 16×16×32=8192,恰好是 INT8 版本的一半。
加载和存储由 TILELOADD/TILESTORED 完成,它们带的参数是基地址加行 stride——硬件按 TILECFG 的形状自动做「矩形块与线性内存」之间的转换,每一行跨 stride 取一次。矩阵在内存里是行优先的一长条,在 tile 里是规整的矩形,这个转置/切块工作以前要靠几十条向量 load 加 shuffle 手工拼,现在一条指令解决。对连续写回 C 的场景,还可以配合 Streaming 非临时存储 的思路绕开缓存污染;大规模推理时 C 矩阵常常只写不读,这一点在带宽吃紧的多路 socket 上很值钱(见 NUMA 本地与远端访存延迟)。
四、上手流程:OS 许可、配置、计算、交还
AMX 的寄存器状态太大(8KB tile 加 64 字节 TILECFG),操作系统默认不给用户态开。Linux 从 5.16 起提供了请求机制:程序先通过 arch_prctl(ARCH_REQ_XCOMP_PERM, XFEATURE_XTILEDATA) 系统调用申请 tile 数据权限,内核在第一次 #NM 时给该进程分配上下文保存空间并置位 XCR0 的 18 号位。这个「按需授权」机制避免了所有进程都为永远用不到的 8KB 状态买单——fork 一个不用 AMX 的进程,上下文切换开销和从前完全一样。
拿到权限后的标准六步:准备 64 字节配置块并 LDTILECFG;TILELOADD 装 A、B 块;TILEZERO 清 C 累加块;沿 K 维循环「装新块、TDP 累加」;TILESTORED 把 C 写回内存;最后 TILERELEASE 交还。真实工程里没人手写这套——oneDNN、OpenVINO、PyTorch 的 CPU 后端在检测到 AMX 后会自动走这条路径,但理解流程对性能分析仍然必要:perf 里看到 #NM 风暴或 TILERELEASE 出现在热循环里,通常意味着上下文管理写错了(PMU 计数器的用法见 PMU 性能监控单元)。
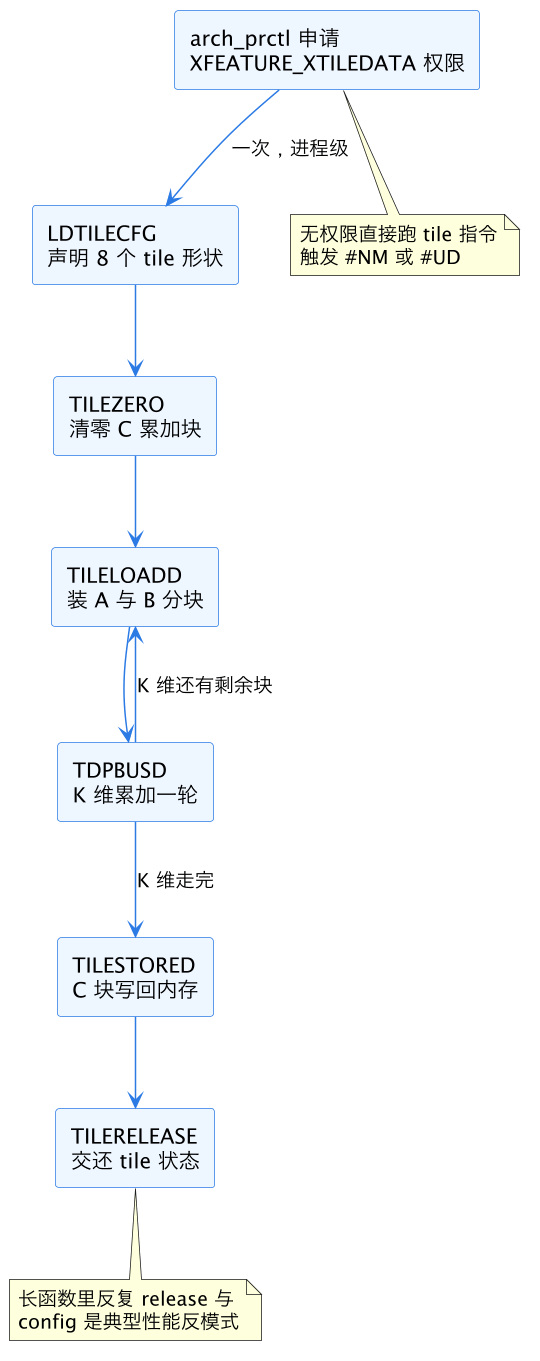
上图是完整生命周期。顺带一提工具链现状:GCC 从 11 版起内置了 AMX 的 intrinsics(_tile_loadd、_tile_dpbusd 一族),Linux 内核对 tile 状态的上下文保存走 XSAVE 的扩展帧,调试器里 GDB 也能直接打印 TILECFG。也就是说除了「形状要先声明」这层心智负担,整套开发体验和写 AVX 代码已经没有本质差别。性能要点有三个:LDTILECFG 不算便宜(几十周期),应该按矩阵形状在循环外配好,别每次内层迭代都重配;TILELOADD 的 stride 若导致每次加载跨大量 cacheline,加载会先成为瓶颈,B 矩阵通常要预先重排(pack)成 tile 友好的布局——这和缓存行行为强相关,预取帮不上所有忙(参见 硬件预取器 的适用边界);多线程下每个核独立的 tile 上下文意味着 AMX 天然线程级并行,OpenMP 按输出块切分即可,不需要线程间共享 tile。
五、选型:AMX、AVX-512 VNNI 还是 GPU
把三条路放在一起看,结论其实清晰:
| 维度 | AVX-512 VNNI | AMX | GPU(如 A100 级) |
|---|---|---|---|
| INT8 峰值(单核/单卡) | 约 128 MAC/周期 | 约 1024 MAC/周期 | 数百 TOPS(整卡) |
| 数据位置 | 向量寄存器 | tile 寄存器 | 显存,需 PCIe 搬运 |
| 适用批量 | 小 batch、低延迟 | 中小 batch、CPU 常驻 | 大 batch、离线吞吐 |
| 部署成本 | 零(已有核) | 零(Sapphire Rapids 起) | 独占卡、驱动、供电 |
| 频率影响 | 重负载降频明显 | 降频温和 | 无关 CPU 频率 |
| 编程门槛 | intrinsics 成熟 | oneDNN 封装好 | CUDA 生态 |
AMX 的甜蜜区是「推理已经在 CPU 上跑、想要数倍算力但不想引入加速器」的场景:推荐系统在线推理、BERT 级模型的实时服务、量化后的 CNN。数据本来就在内存里,省去 PCIe 往返,端到端延迟往往比把请求批给 GPU 还低。AVX-512 VNNI 退居「老平台兜底」和「算子里夹杂大量非矩阵逻辑」的场景。GPU 则继续统治训练和大批量离线推理。
给一个量级感知的具体数字:Sapphire Rapids 单核跑满 TMUL,INT8 理论峰值约 4 TOPS(1024 MAC/周期乘 2 次操作、按 2GHz 出头折算),一颗 48 核的至强整 sockets 接近 400 TOPS;同代核只用 AVX-512 VNNI 大约 50 TOPS。也就是说,一个 INT8 量化充分的模型,单路服务器就能撑起每秒数万次的推理请求——这在 AMX 之前需要一张中端推理卡。当然,前提是算子库里真把 GEMM 落到了 tile 指令上:PyTorch 老版本编译时没开 oneDNN 的 AMX 路径、或者模型的 GEMM 形状太碎(M 维只有个位数),实际拿到的加速可能连两倍都不到。验证方法很朴素:perf record 之后看热点符号里有没有 tile 指令,或者数 amx 相关的内核上下文事件。
另一个值得一提的点:AMX 的频率惩罚比 AVX-512 轻。当年 AVX-512 重指令触发的大幅降频(见 DVFS 频率切换延迟 的背景)让很多人对宽指令心有余悸;AMX 因为阵列是独立供电的单元,跑满 TMUL 时核心频率下降温和,混合负载(矩阵乘加标量逻辑)的整体表现反而好。这也让「AMX 算矩阵、核内流水做前后处理」的单进程流水线成为推理服务的标准形态。
这一篇在知识体系里的位置
本篇是微架构模块「数据并行算力」线的扩展篇。上游是 CPU 微架构总览 的演进主线与 向量 SIMD 执行单元 的一维世界;同线相关的是访存侧——tile 加载的带宽压力落在 内存通道交织 与 MSHR 未决请求 上,写回策略见 Streaming 非临时存储。观测侧,验证 AMX 是否真正被用上、单元利用率如何,靠 PMU 性能监控单元 与 perf 工具链。整条微架构线的入口目录是 微架构专题。
总结
AMX 矩阵扩展给 x86 加上了真正的二维计算能力:8 个最大 16 行 64 字节的 tile 寄存器由 64 字节的 TILECFG 一次性声明形状,TILELOADD/TILESTORED 负责内存矩形块与 tile 之间的搬运,TDP 指令族一条完成上万次 INT8 或 BF16 乘加并原地累加,配合 OS 的按需权限授予与 TILERELEASE 的显式交还,构成了一个配置即编程、累加即语义、单核 INT8 吞吐达 AVX-512 VNNI 八倍的矩阵引擎——它让 CPU 常驻的中小批量 AI 推理第一次不必羡慕加速器,也让「加宽向量」这条走了二十年的老路旁边,多出了一条「直接做矩阵」的新岔路。