Line Fill Buffer:Intel LFB 与 MSHR 的分工、miss 回填路径与耗尽导致的 IPC 塌方
更新时间:2026-10-03。MSHR 未决状态寄存器 那篇讲了「缓存 miss 之后靠什么记住这笔未决的账」——MSHR 是记录未决 miss 的登记簿,让缓存能在 miss 未解决时继续服务新的命中。但那篇留了一个问题:账是记下了,等数据真的从 L2/L3/内存回来时,数据本身落在哪里?一条 cache line 64 字节,从总线上回来的那一刻 L1 里还没有它的家(可能要先踢走一个脏行),这个「中转站」就是本篇的主角——Line Fill Buffer(LFB,行填充缓冲)。Intel 微架构里,LFB 还身兼第二职:非临时(non-temporal)存储的写合并舞台。两篇背景文先垫一下:写分配与写回策略 讲 miss 时为什么要把整行拉进来,存储缓冲与写合并 讲写合并在流水线上游的形态。本篇聚焦 LFB 这一个硬件模块:它和 MSHR 到底谁管账谁管货、一次 miss 数据怎么进 LFB 又怎么搬进 L1、以及为什么 LFB 一耗尽,IPC 会像踩空台阶一样塌下去。
本文要回答的问题
- Intel 语境里的 LFB 和教科书的 MSHR 是同一个东西吗?分工边界在哪?
- 一次 L1 miss 从发起到数据落进 L1,LFB 在其中经历了哪几个状态?
- 非临时存储(NT store)为什么也要用 LFB?合并和满行直写的判据是什么?
- LFB 只有十来个槽位,耗尽时核内发生什么?为什么 IPC 是「塌方」而不是线性下滑?
- 怎么用 PMU 计数器观察 LFB 占用,工程上怎么缓解?
一、LFB 与 MSHR:一个管货、一个管账
先把名词理顺,因为这个领域的术语相当混乱。教科书(Hennessy 和 Patterson 那套)里的 MSHR(Miss Status Holding Register,未决状态保持寄存器)是一个广义概念:记录一笔未决 miss 的地址、状态、以及「回来后数据放哪」的全部硬件。而 Intel 微架构文档里的命名更细——「记账」和「存货」被拆成了两个物理上相邻但职责不同的结构:
- MSHR(簿记侧):只存元信息。每个表项记住未决 miss 的地址(行对齐)、它从哪一级去取(L2、L3 还是 DRAM)、以及有哪些后续的 load/store 在等这笔数据(用一个等待者队列或直接关联到 load buffer 项)。它很小,就是个 CAM(内容可寻址存储器)加状态位。
- LFB(货物侧):真正存数据的 64 字节槽位,外加每字节的有效位掩码(valid byte mask)。数据从下级存储层次分拍回来——现代 Intel 核的 L2 到 L1 接口一般是 64 字节每周期,一拍一整行,但更早的设计或者从非核(uncore)回来可能是 16/32 字节一拍——这些分片先落进 LFB 的槽位,有效位逐段置位,等整行凑齐才一次性搬进 L1 数据阵列。
为什么要拆?因为两者的时间常数完全不同。MSHR 的寿命是「整个 miss 延迟」,可能横跨几百个周期(去 DRAM 一趟就是 80 到 120 纳秒,2.5GHz 下两三百周期);而 LFB 的「装货」阶段只占 miss 寿命的尾巴。更关键的是,数据落进 LFB 之后,等待它的 load 不用等搬进 L1——LFB 有直接的前递(forwarding)旁路,数据一到 LFB 槽位就可以旁路喂给正在等的那几条 load。这个旁路把 miss 的有效延迟又削掉几个周期,是 LFB 必须做成「带读端口的真存储」而不是简单移位寄存器的原因。
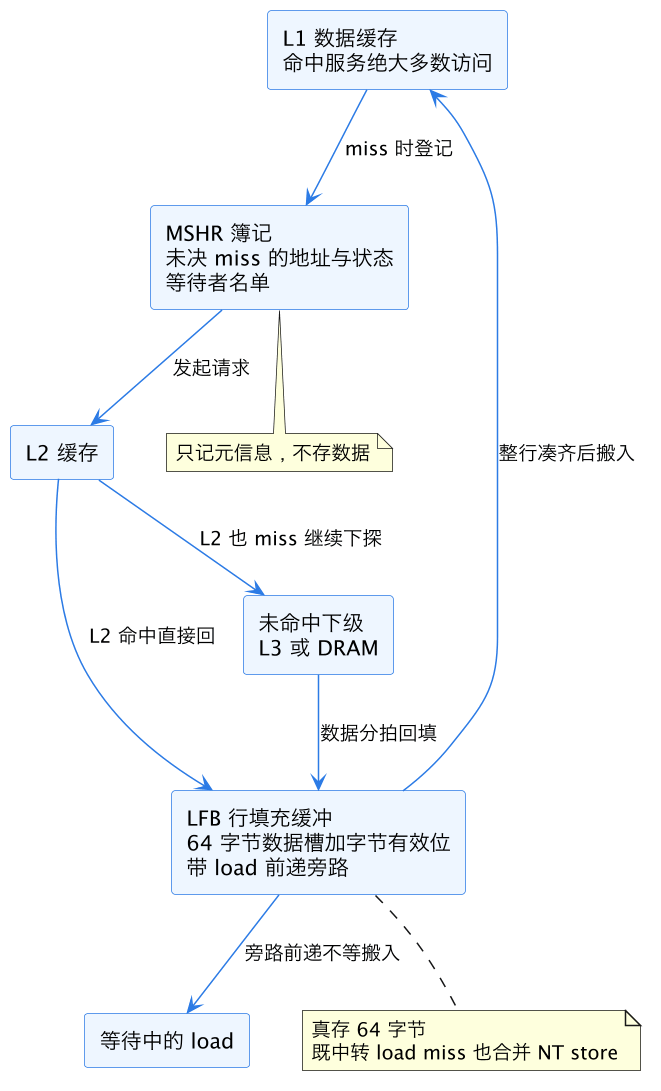
上图把「账」和「货」两条线画开了:miss 的登记、下探、状态翻转走 MSHR 一侧;数据的回填、暂存、前递、搬入走 LFB 一侧。两者的表项通常一一对应(申请 miss 时同时占一个 MSHR 项和一个 LFB 槽),生命周期高度重叠,这就是为什么很多文章干脆把两者混称「MSHR」——在功能讨论里可以混,但分析资源耗尽时必须分开:先耗尽的往往是 LFB 的数据槽,而不是 MSHR 的簿记项。
再用一张卡把「分工—兼职—耗尽」三件事钉在一起,后面第四节讲塌方时会反复引用这张图里的角色:
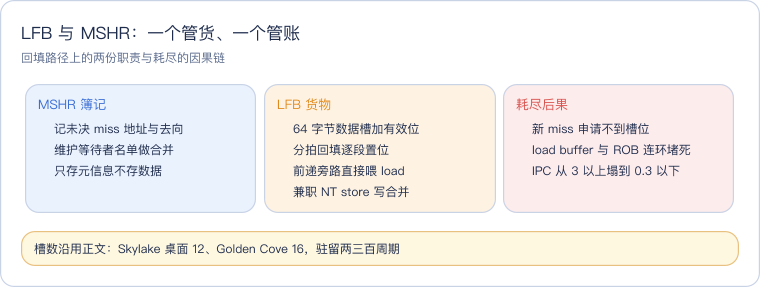
这张卡的读法是从左往右的一条因果链:簿记侧再宽裕也救不了货物侧——LFB 槽是真存储,数量有限、驻留时间长,一旦占满,「miss 无法发起」会顺着 load buffer、ROB 一路传导到前端,这就是后面「塌方」一词的物理含义。
二、一次 load miss 的完整旅程:LFB 的五个状态
跟着一笔 load miss 走一遍。假设核 0 上一条 mov rax, [rbx] 在 L1D 未命中,L2 也没有,得去 L3。
第一步,分配。LSU(load store unit,见 LSU 装载存储单元)确认 L1 miss 后,同时向 MSHR 和 LFB 申请表项:MSHR 项记下地址 0x…C0(行对齐)和等待者(load buffer 里的那条 load),LFB 槽被标记为「已分配、等待回填」,64 字节有效位清零。如果此时 LFB 没有空槽,miss 根本发不出去——这是后面塌方的伏笔。
第二步,请求下探。请求经 L2 未命中,再发往 L3;这几十纳秒里 LFB 槽就干等着,状态是「pending」。期间如果有第二条 load 访问同一行(地址低位不同),MSHR 做地址 CAM 匹配发现「这行已经在飞」,直接在原 MSHR 项上追加一个等待者——这叫 miss 合并(merge),不新占任何资源。合并是 MLP(内存级并行,内存级并行 MLP 有专门展开)能跑起来的前提:十条访问同一行的 load 只占一个 LFB 槽。
第三步,回填。L3 命中,数据经 L2 返回,一拍或几拍灌进 LFB 槽,字节有效位逐段置位。
第四步,前递。有效位覆盖了等待 load 所需的那几个字节后,LFB 直接把数据旁路给 load,load 完成、从 load buffer 退休路径上走人。注意此刻数据还没进 L1——等待者已经满意了,剩下的是把行安顿好。
第五步,搬入与释放。LFB 向 L1D 申请写端口,把整行写进某个 set 的一路(可能要先把原占者驱逐出去,脏驱逐还要先写回下级——这套流程见 写分配与写回策略)。写完成后 LFB 槽和 MSHR 项一并释放,回到空闲池。
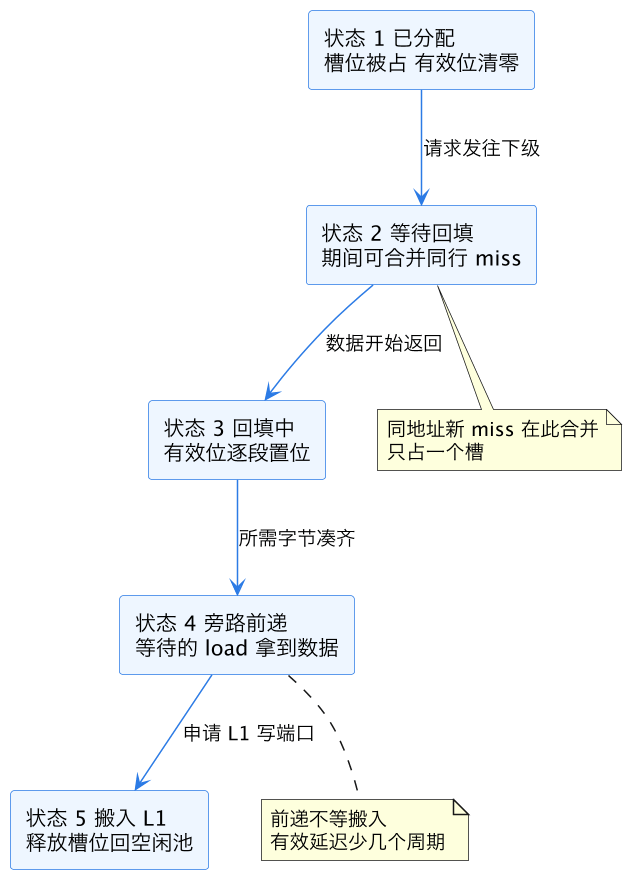
这张图的重点在状态 2 和状态 4:状态 2 的合并窗口决定了「一行数据的并发访问」摊薄成一份资源,状态 4 的前递决定了 miss 延迟的账面数字。一次去 DRAM 的 miss,槽位从分配到释放要占两三百周期——这就是 LFB 周转慢的根本原因,也是它数量少得可怜(Golden Cove 一代才 16 个,早期 Skylake 桌面核只有 10 个)却依然支撑起整个内存子系统的关键:全靠合并和前递把每个槽的利用率榨干。
三、第二职业:非临时存储的写合并舞台
LFB 在 Intel 核上还有一份兼职:合并非临时存储。背景是 流式与非临时装载存储 讲的那个场景——你要写一大片再也不会读的数据(比如 memset 一块大缓冲、GPU 上传缓冲区),按普通写分配流程,每次写 miss 都要先把整行从内存读进来再部分改写,内存带宽白白翻倍。x86 给的解法是 MOVNT 系列指令(非临时存储):告诉硬件「这行我会整个覆盖,别读它,写完直接刷去内存,也别进缓存」。
硬件怎么落实「整行覆盖才免读」?判据就落在 LFB 上。每条 movntdq 只写 16 字节(AVX 版 32/64 字节),硬件把连续的 NT store 导进一个 LFB 槽,用字节有效位记账:攒的过程里有效位不断置位,槽满(64 位全置位)时,这一行就是「完全覆盖」,LFB 直接整行刷往下级内存,一次读都不发——这就是写合并(write combining)在 Intel 核上的实现。如果槽没攒满就因为冲突、刷缓冲(sfence)或资源压力被提前赶走,那硬件只能退而求其次:按有效位把写过的字节做「部分行写」(partial line write),下级内存控制器要为没写到的字节做读改写(read-modify-write),带宽优势打折。
这套机制对软件的要求非常具体:NT store 要按地址顺序、连续、行对齐地写,让一个槽能在被挤走之前攒满。跳着写、倒着写、隔几行写,等于同时占着多个半满槽互相驱逐,LFB 瞬间变成最贵的资源浪费方式。
| 写法 | LFB 行为 | 内存流量 | 效果 |
|---|---|---|---|
| 连续行对齐 NT store | 一个槽攒满 64 字节再刷 | 只写不读,1 倍 | 理想,带宽翻倍 |
| 跳地址 NT store | 多个半满槽互挤提前驱逐 | 部分行写加读改写 | 优势大幅缩水 |
| 普通 store 写大缓冲 | 每行 miss 先读后写 | 读 1 倍加写 1 倍 | 带宽减半 |
| NT store 加及时 sfence | 槽有序排空 | 1 倍 | 正确且高效 |
四、LFB 耗尽:IPC 为什么不是下滑而是塌方
现在到了性能工程师最关心的部分。LFB 一共就 10 到 16 个槽,而一次去 DRAM 的 miss 占槽两三百周期。做一个粗糙的 Little 定律估算:16 个槽、平均驻留 250 周期,核最多维持「每 15 周期左右完成一笔 miss」的吞吐。对一个 IPC 4、每 50 条指令产生一次 L1 miss 的访存密集程序,12.5 周期就来一笔新 miss——已经贴着 LFB 吞吐上限在跑了。此时只要访问局部性稍差一点(合并变少)、或者 miss 更多地去 DRAM 而不是 L2/L3(驻留时间变长),LFB 就会占满。
占满之后发生的事不是「miss 变慢一点」,而是流水线的连环刹车:新的 L1 miss 申请不到 LFB 槽,miss 无法发起;那条 load 堵在 load buffer 里;它后面的指令虽然在 ROB 里还能乱序推进,但凡是消费这次 load 结果的、以及 load buffer 填满之后的一切新 load/store,全部卡死;ROB 一两百项看着深,面对三四百周期的 DRAM 延迟其实撑不了多久;ROB 一满,重命名级停摆,前端很快就跟着断粮。从 PMU 上看就是:LFB 占满的瞬间,IPC 从 3 点多直接掉到 0.3 以下——不是斜坡,是悬崖。这就是「塌方」这个词的准确含义:瓶颈从「内存延迟」变成了「一个 16 项的小缓冲的周转率」,而后者是更硬的墙。
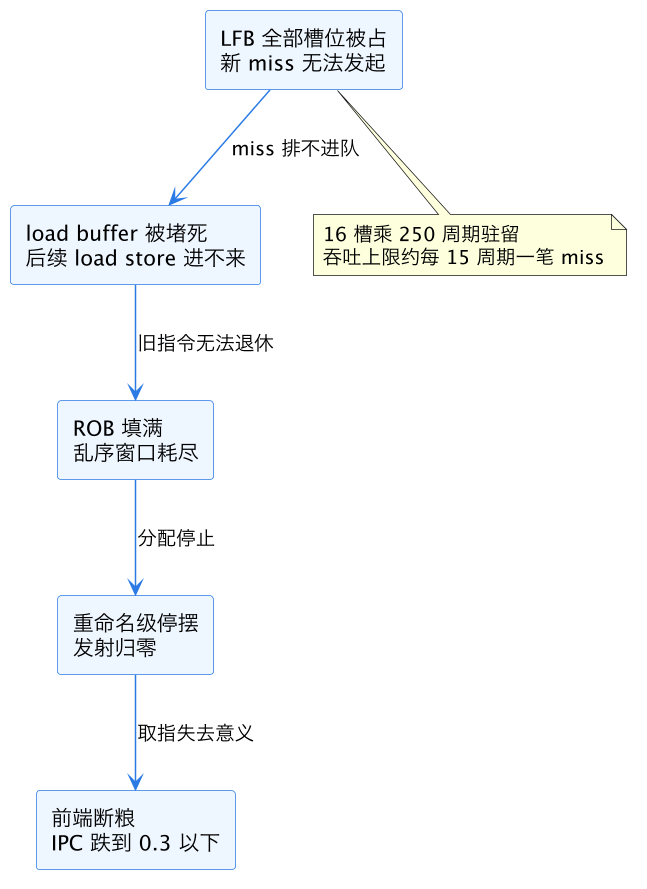
这张塌方链条图要倒着读才有味道:表面上你看到的是前端没指令发(IPC 低),往上游追是 ROB 满,再追是 load buffer 堵,根子却是 LFB 这 16 个槽。这就是 Top-down 分析方法论 反复强调「Memory Bound 要继续下钻」的原因——停在「后端绑定」这一层,你永远不会怀疑到一个十几项的小缓冲。
观察手段上,Intel PMU 给了直接证据:L1D_PEND_MISS.FB_FULL(各代事件名略有差异,含义是「因为 LFB 满导致 L1 miss 挂起的周期数」)占运行周期的比例一旦超过百分之几,就说明已经在撞墙;L1D_PEND_MISS.PENDING 配合周期数可以反推平均在飞 miss 数(即实际 MLP)。缓解手段对症下药:提高合并率(让并发访问落在同一行)、提高预取覆盖(硬件预取器 把 miss 变成命中或提前发起)、减少去 DRAM 的比例(增大数据局部性)、或者干脆用 NT store 绕开读分配。还有一个反直觉的:有时降低 MLP 需求反而更快——把随机指针追逐改成批量顺序扫描,同样的数据量,LFB 压力小一个数量级。IPC 瓶颈 与 数据冒险之 L1 miss 两篇分别从指标和流水线角度给了相邻视角。
五、数量演进与设计权衡
最后把各代 Intel 核的 LFB 规模拉一张表,看趋势背后的权衡:
| 微架构(代表) | LFB 槽数(约) | 同期 ROB 规模 | 备注 |
|---|---|---|---|
| Nehalem/Sandy Bridge | 10 | 128 到 168 | LFB 概念成形期 |
| Skylake 桌面核 | 12 | 224 | 配 72 项 load buffer |
| Ice Lake / Sunny Cove | 16 | 352 | 核大幅加宽,LFB 跟上 |
| Golden Cove(P 核) | 16 | 512 | 更依赖合并与前递效率 |
| AMD Zen 系列对照 | 20 以上 MSHR 项 | 256 到 320 | AMD 走「更多项」路线 |
趋势很清楚:核越宽、ROB 越深,对内存级并行的胃口越大,LFB 必须跟上,但增幅远远落后于 ROB 的增幅——因为 LFB 是真存储(每项 64 字节加有效位加前递端口),面积和功耗代价远高于 ROB 的一项簿记。于是设计的杠杆越来越多地压在「软件可见的效率」上:预取器的积极性、NT store 的合并判据、以及 L2 预取直接进 L1 之类的路径优化。这也解释了为什么同样的程序,换一代 CPU 后「内存墙」的高度会变——墙的高度不取决于内存,取决于这块小缓冲的周转率。和 LFB 同族的还有 牺牲缓存与写缓冲 里讲的 victim/write buffer,那是处理「被踢出去的行」的对偶结构;一个管「进来的行」,一个管「出去的行」,合起来才是缓存层次间数据搬运的全貌。缓存一致性层面,LFB 里的在飞行同样要参与 snoop 应答(别的核问这一行时,不能因为它还没落进 L1 就装作没有),这部分语义见 MESI 与 MOESIF 协议。
这一篇在知识体系里的位置
本篇是微架构模块「缓存与内存层次」线上、继 MSHR 未决状态寄存器 之后的实现篇:那篇管「记账」,本篇管「存货与搬运」。上游背景是 写分配与写回策略(miss 为什么拉整行)、LSU 装载存储单元(miss 的发起方)、存储缓冲与写合并(上游的写缓冲)。同线相邻的是 流式与非临时装载存储(NT store 的指令侧)、内存级并行 MLP(LFB 支撑的性能指标)、牺牲缓存与写缓冲(对偶结构)。下游衔接 Top-down 分析方法论 与 IPC 瓶颈(怎么用 PMU 坐实 LFB 瓶颈)、硬件预取器(缓解手段)。全景见 CPU 微架构总览。
总结
Line Fill Buffer 是 Intel 核里夹在 L1 与下级存储层次之间的十几个 64 字节数据槽:MSHR 记「哪笔 miss 在飞、谁在等」的账,LFB 存「回来的数据」的货,数据回填先在 LFB 凑齐、靠前递旁路直接喂给等待的 load、再整行搬入 L1;同一份硬件还兼职非临时存储的写合并——攒满一整行才免读直写。它数量少、驻留长,一旦耗尽,miss 无法发起、load buffer 和 ROB 连环堵死,IPC 从 3 以上直接塌到 0.3 以下;判断手段是 PMU 的 FB_FULL 类计数器,缓解思路围绕合并率、预取覆盖与减少 DRAM 往返展开。