宏融合与微融合:x86 解码器如何"合体"两条指令,省出带宽与 ROB 空间
在 CISC 与 RISC 里我们说过,x86 核心里跑着的是翻译后的 µop;在 µop Cache 与解码前端 里看过 µop 怎么被缓存和输送。这两篇都默认了一件事:一条 x86 指令对应固定数量的 µop。这一篇把这个假设松动一下——现代 x86 核心会反过来把两条宏指令揉成一条 µop(宏融合),或把解码时拆开的 µop 在 ROB 里重新粘回去(微融合),两种"合体"省的都是真金白银的带宽和队列空间。
本文要回答的问题
- 宏融合(macro-fusion)是什么,为什么 cmp+jcc 能被揉成一条 µop?
- 微融合(micro-fusion)和宏融合有什么本质区别,load-op 为什么值得融合?
- 两种融合分别给解码带宽、ROB 占用、发射压力带来什么收益?
- 写代码、看性能计数器时,怎么利用或观测到这些融合?
一、为什么要融合:前端的每一格带宽都很贵
先回忆一下乱序前端的关键约束。一个 6 发射的核心,理想情况下每拍要从解码器/µop cache 里取出 6 条 µop 送进重命名器。但 x86 解码器是出了名的窄——复杂指令译码器(CSD)一拍只能啃一条复杂指令,简单译码器一拍一条;µop cache 命中时能给到 6~8 条,已经是天花板。
问题在于:真实代码里 µop 的"信息密度"并不满。一条 cmp rax, rbx 本身只设置标志位,一条 jne .loop 本身只根据标志跳转——两条指令各干半件事,却要占两个解码槽、两个重命名槽、两个 ROB 项。如果硬件能看出"这俩其实是一件事",把它们合成一条 µop,等于白赚一个槽位。这就是融合的根本动机:不改程序语义的前提下,提高 µop 流的有效信息密度。
融合发生在两个层面,名字只差一个字,机制完全不同:
| 维度 | 宏融合(macro-fusion) | 微融合(micro-fusion) |
|---|---|---|
| 合体对象 | 两条 x86 宏指令(cmp+jcc) | 一条 x86 指令解码出的多个 µop(load+alu、alu+store) |
| 发生位置 | 解码器/µop cache 出口 | 解码器输出,ROB 内保持融合 |
| 执行时 | 真的只执行一次(比较+跳转一次搞定) | 发射时通常仍拆成两个 µop 执行 |
| 省的是什么 | 解码带宽 + 重命名 + ROB + 执行 | ROB 项 + 部分重命名/发射队列空间 |
| 典型条件 | 算术/逻辑指令紧跟条件跳转 | 带内存操作数的指令 |
下面分别拆开看。
二、宏融合:cmp+jcc 合体记
宏融合是 Intel 从 Core 2(2006 年)就引入的老把戏。条件是:一条会设置标志位的算术/逻辑指令(cmp、test、add、sub、and、inc、dec 等,具体集合每代略有增减),紧跟着一条条件跳转(je/jne/jl/jg/jz/jnz...),且两条指令在同一解码窗口内相邻出现。满足条件时,解码器只输出一条融合 µop:
未融合:  cmp rax, rbx      -> µop1: 计算 rax-rbx,写标志位
        jne .loop          -> µop2: 读标志位,条件跳转
融合后:  cmp+jne           -> µop1: 一步到位,比较并决定跳转方向
收益是实打实的:少占一个解码槽(解码器那拍能多译一条别的指令)、少占一个重命名槽、少占一个 ROB 项、少占一个发射槽。在一个 4 发射核心上,如果热点循环每轮都有一条 cmp+jcc,宏融合能把前端的有效吞吐从 4 条/拍等效抬到接近 5 条/拍——不花任何面积,纯靠解码器多做一次模式匹配。
有几个坑值得记住:
- 32 位与 64 位模式的融合表不同。Core 2 时代 64 位模式的融合组合比 32 位少(比如
cmp只融部分跳转);从 Nehalem 开始才补齐。 - TEST 比 CMP 能融的跳转多。
test可以融合几乎所有条件跳转(含js/jo/jp),cmp不行。所以编译器常把cmp reg, 0优先生成test reg, reg——除了省字节,还为了保住宏融合。 - 跨解码窗口就融不上。cmp 和 jcc 之间隔了哪怕一条无关指令,或者两条指令横跨了 µop cache 的行边界,融合都可能失败。这就是为什么编译器会把比较和跳转紧紧贴在一起排布。
- 部分代次上宏融合会"拆开再融":Sandy Bridge 起,宏融合发生在 µop cache 写入之前,cache 里存的就是融合态,之后每拍取出的都是融合 µop,收益贯穿整个循环。
三、微融合:load-op 打包进 ROB
微融合发生在更低一层。x86 允许 add rax, [rbx] 这种"带内存操作数"的指令,解码器会把它拆成两个 µop:一个 load、一个 alu。但这两个 µop 在 ROB 里只占一个融合项(fused domain),发射时才拆成两条独立的 µop 进入各自的端口(unfused domain):
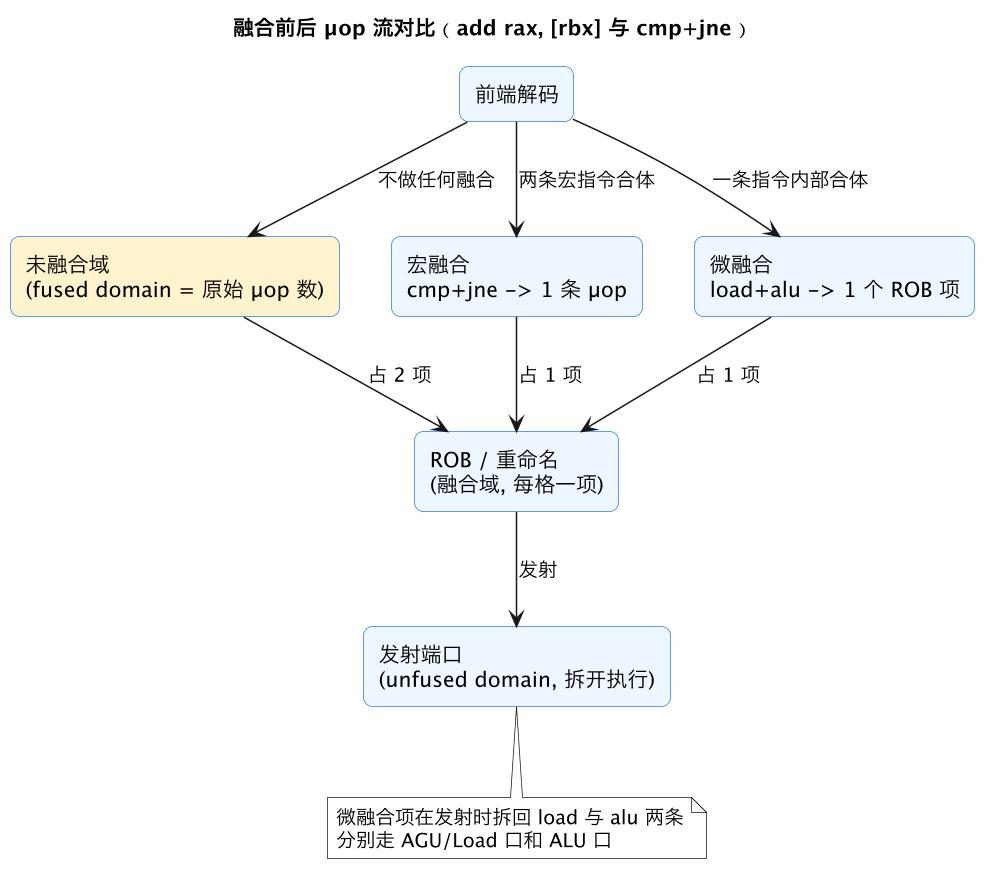
这张图要抓住的关键是"两个域"的概念:ROB 和重命名器工作在 fused domain,看到的是融合后的 µop 数;发射端口和执行单元工作在 unfused domain,看到的是真正要执行的 µop 数。微融合的意义就藏在这两个域的差值里——一条 add rax, [rbx] 在 ROB 里只占 1 格,却能在发射时拆成 load + alu 两条各走各的端口。对比之下宏融合更彻底:cmp+jcc 融合后连执行都是一次搞定,两个域里都是 1。
微融合省的东西有两样:
- ROB 项。ROB 容量是乱序窗口大小的硬上限(现代核心 200~500 项)。如果内存操作数指令占三成,微融合能让 ROB 的有效"指令容量"凭空多出 15% 左右——窗口更大,能挖出的并行度就更多。
- 重命名与分配带宽。每拍分配器按融合域计数,融合后一条槽就能分配原本两个 µop 的资源,前端瓶颈缓解。
代价也有:ROB 项里要多存一个"这是两条 µop"的标记和第二个 µop 的分支信息,退役逻辑复杂一点;发射时拆分要额外的控制通路。另外注意,store 指令的存地址(STA)和存数据(STD)两个 µop 也是靠微融合挤在一个 ROB 项里的——这是 store 能"只占一格"的原因。
还有一点容易混淆:微融合不是 µop cache 的专利。传统解码路径(MITE)产出的 µop 同样可以做微融合,µop cache 只是顺带把融合态缓存起来。两条路径的取舍细节见 µop Cache 与解码前端。
四、收益落到数字上:能观测到什么
两种融合叠加,对性能计数器有直接可读的痕迹:
| 现象 | 计数器线索 | 解释 |
|---|---|---|
| 融合域 µop 数少于发射域 | UOPS_ISSUED > UOPS_RETIRED(部分口径) | 微融合项发射时拆成两条 |
| 分支密度高但 IPC 不掉 | BR_MISP 正常、UOPS_RETIRED 超预期 | cmp+jcc 宏融合省出前端槽位 |
| ROB 未满却前端受限 | Topdown 里 Frontend Bound 偏高 | 融合失败(指令没贴紧、窗口跨界) |
| 同代码换编译器版本变快 | 指令数不变、µop 数变少 | 新版把 cmp 换成了 test,保住融合 |
实际测试里,一个以 cmp+jcc 结尾的紧凑整数循环,宏融合开启与否在窄核心(4 发射)上能差出 10%~20% 的前端吞吐;load-op 密集的指针遍历代码,微融合带来的 ROB 节省能把乱序窗口的有效深度拉长一截,长延迟 load 更容易被重叠。反之,如果你手写汇编时把比较和跳转之间插了条 nop、或者用了不被融合的跳转类型,就可能悄悄丢掉这部分收益。
对写代码的人的实用建议只有三条:比较用 test/cmp 紧贴条件跳转;别在两者之间插指令;性能分析时同时看 fused 与 unfused 域的 µop 计数,两者差值就是微融合在干活的比例。
这一篇在知识体系里的位置
本篇是微架构长尾层,向上承接 CISC 与 RISC(为什么 x86 要翻译成 µop)与 µop Cache 与解码前端(µop 从哪来),向旁连接 超标量设计(发射宽度决定了前端槽位有多贵)与 IPC 瓶颈拆解(Frontend Bound 的融合视角)。
总结
宏融合与微融合是 x86 解码器的两种"合体"技术:宏融合把 cmp+jcc 这类"比较+跳转"对揉成一条真正只执行一次的 µop,省解码、重命名、ROB 和执行四份资源;微融合把 load-op、store 这类拆开执行的 µop 在 ROB 里按一项计账,发射时再拆回,省的是乱序窗口空间。两者共同抬高了 µop 流的信息密度,是"不增发射宽度却提升有效吞吐"的经典微架构手段。