per-core DVFS:单核独立调频的硬件实现与调度器协同,为什么全核同频策略正在被放弃
更新时间:2026-10-03。CPU 功耗与频率管理 那篇讲了 DVFS(动态电压频率调整,Dynamic Voltage and Frequency Scaling)的总体原理:电压频率一起降,功耗近似按立方往下掉。DVFS 频率切换延迟 那篇讲了切换一次频率要等多久。但这两篇都默认了一个前提:调频的粒度。早期处理器的粒度是「整颗芯片一个频率」——所有核同频升降;而近十年的高性能处理器都在往 per-core DVFS 走,每个核自己决定跑多快。本篇就讲这个粒度转变:硬件上怎么实现、调度器怎么配合、以及全核同频为什么撑不下去了。
本文要回答的问题
- per-core DVFS 在硬件上需要哪些组件,每个核独立的电压频率域怎么搭出来?
- 全核同频(package-level DVFS)策略浪费在哪里?
- 调度器在 per-core DVFS 下多承担了什么职责?
- 实际芯片落地到了什么程度,纯 per-core 方案还有什么折中?
一、全核同频的时代与它的浪费
先看老方案。Package-level DVFS 下,整颗处理器共享一路供电和一个时钟源(或少量几个全局时钟域),所有核要么一起跑 3.0 GHz,要么一起降到 1.2 GHz。频率决策的依据是「全片负载的聚合值」——通常是取最忙那个核的需求,因为它决定了用户体验的下限。
问题就出在这个「取最大值」上。假设 8 核芯片上跑着这样的负载:1 个核在跑延迟敏感的前台线程,需要 3.5 GHz 才不卡顿;其余 7 个核在跑批处理,1.5 GHz 完全够用。全核同频策略下,为了那一个核,8 个核全部拉到 3.5 GHz。功耗近似和「核数乘电压平方乘频率」成正比,而电压又是频率的增函数,这一个高频核把整个芯片的电压轨抬高了,7 个低频就够用的核被迫在高电压上空转。实测数据很难看:在这类混合负载下,package-level 方案比理想粒度方案多耗 30% 以上的电。
另一个浪费方向相反。有些芯片做过「取平均负载」的折中,结果高频核饿着、低频核撑着,两头不讨好。全核同频的根本缺陷不是策略选哪种聚合函数,而是它用一把尺子量了八个完全不同的需求。
二、per-core DVFS 的硬件拼图
让每个核独立调频,听上去只是把调频单元复制八份,实际要动三块硬件。
第一块是时钟。每个核(或每个频率域)需要自己的时钟发生器,通常是一片上共享的高频 PLL 加每核一个时钟分频器。分频的好处是切换快:改分频比几个周期就能生效,不像重新锁定 PLL 要等几十微秒。高端方案(如 Intel 从 Skylake 起的每核独立频率请求)就是「共享 PLL + 每核分频」的路线,核间频率只能是 PLL 频率的整数分频,但实际粒度已经足够细。
第二块是电压,这才是大头。频率可以随便切,电压不行——核能稳定跑在某个频率的前提是该核供电电压到位。每核独立电压意味着每核一条独立供电轨,要么在封装/主板上放多个 VR(电压调节器,Voltage Regulator),成本和面积都疼;要么用片上集成调压器(IVR/FIVR,Intel 从 Haswell 起把调压器搬进封装),用片上面积换粒度。FIVR 这类集成方案让 per-core 电压域第一次在商业大核上变得现实。
第三块是电平转换与隔离。各核电压不同,核与核之间、核与共享 LLC(末级缓存)之间的信号要跨电压域传递,必须有 level shifter;核要完全断电时还需要电源门控(power gating)的隔离单元。这些跨域电路带来固定的延迟和面积开销,是「域划得越细越贵」的物理根源。
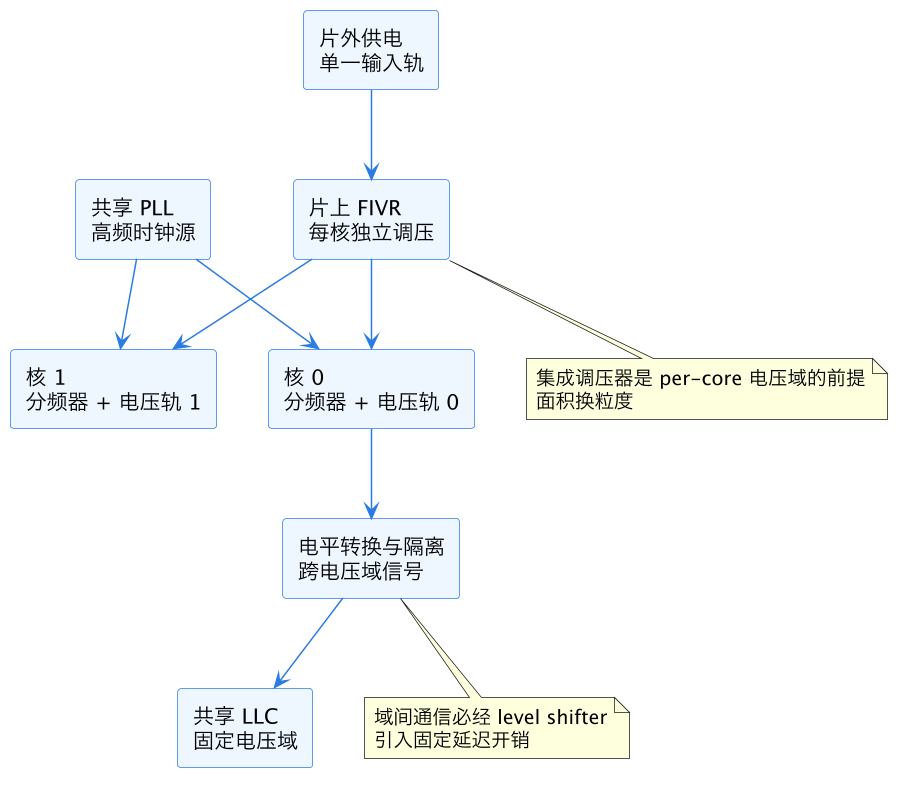
上图是 per-core DVFS 的硬件骨架:单一输入电进片上 FIVR 分出每核独立的电压轨,共享 PLL 经每核分频器给出独立频率,核与共享 LLC 之间靠电平转换电路跨越电压域。三个组件缺一不可——只有分频器没有独立电压轨,核的低频就换不来低电压,省电效果砍掉一大半。
三、调度器从旁观者变成当事人
全核同频时代,调频是硬件或固件(如 Intel HWP、ARM 的 cpufreq 驱动)看着利用率计数器自己做的事,调度器只要把线程放好就行。per-core DVFS 把这个默契打破了:频率现在跟着核走,而线程跟着调度器走,于是「线程放哪个核」和「那个核跑多快」变成了同一个决策的两半。
最直接的影响是迁移成本变了。以前线程从核 0 迁到核 5,代价是缓存冷启动;现在还要加上目标核的频率状态——如果核 5 正停在 800 MHz,一个急活儿迁过去,要么忍受升频延迟(几微秒到几十微秒,见 DVFS 频率切换延迟),要么先在低频上慢吞吞跑一阵。Linux 的 schedutil 调速器和 EAS(能量感知调度,Energy Aware Scheduling)因此把「每核当前频率和升频成本」纳入放置决策:给急活儿挑一个已经在高频的核,或者干脆提前把目标核的频率拉起来再等迁移完成。
第二个影响是负载信号要按核算。utilization clamping(uclamp)这类机制让调度器告诉调频器「这个核上的线程集合,最低需要多少性能」,每核频率请求成了该核上所有任务需求的聚合。调频器从「看硬件计数器猜」变成「听调度器报需求」,响应快了一个量级,也避免了「利用率计数器被短时空转刷高导致误升频」的老毛病。
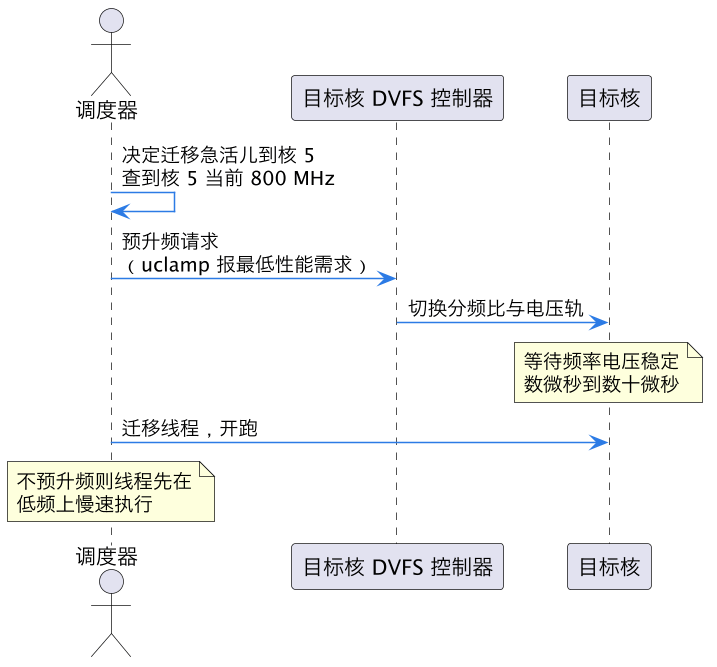
上图是 per-core DVFS 下的一次典型迁移协同:调度器在搬线程之前先把频率需求报给目标核的调频控制器,让升频与迁移准备并行,把「迁过去再傻等升频」的串行延迟藏起来。这个握手在全核同频时代根本不存在——那时频率是全局的,调度器问了也没用。
四、现实落地:纯 per-core 与簇级折中
纯每核一个电压域的成本不低:FIVR 占面积,跨域电路占延迟,VR 相数多了效率还下降。所以工业界落地时出现了几个梯度。Intel 大核从 Skylake 起支持每核独立频率请求,但电压长期是「少数几条轨」,低频核和相邻高频核共享电压时,低频核也只能挂在高电压上,省电压那部分红利拿不到——这叫 per-core 频率、per-cluster 电压。苹果和 ARM 阵营大量采用 cluster DVFS:一簇 2 到 4 个核共享一个电压频率域,簇内同频、簇间独立,用很低的硬件代价拿到了大部分粒度收益。AMD 的 CCX 也是类似思路。
为什么簇级折中往往够用?因为调度器可以在簇内做负载均衡,让同簇的核需求趋同——把急活儿聚到一个簇、把杂活儿扫进另一个簇,簇内「取最大值」的浪费就被摊薄了。这再次说明 DVFS 粒度和调度策略是一体两面:硬件粒度粗,就用调度把负载按需求分类;硬件粒度细,调度就可以粗放一点。
| 方案 | 电压粒度 | 频率粒度 | 硬件成本 | 典型代表 |
|---|---|---|---|---|
| package-level | 整片一轨 | 整片同频 | 最低 | 早期多核 |
| per-cluster | 每簇一轨 | 簇内同频 | 中 | ARM big.LITTLE、苹果、CCX |
| per-core 频率 | 少数几轨 | 每核独立 | 中高 | Intel Skylake 起 |
| 纯 per-core | 每核一轨 | 每核独立 | 高 | 研究原型、部分服务器核 |
五、为什么全核同频正在被放弃
把前面几节串起来,答案就清楚了。其一,负载越来越异质:大小核、前台交互与后台批处理混跑,「取最大值」式的聚合浪费被放大到无法接受。其二,功耗墙越来越硬:单核性能提升越来越依赖短时高频冲刺,只有精细粒度才能让「一个核冲频」的代价不让全片买单。其三,硬件条件成熟了:FIVR 把调压器搬上片,分频器方案把切换延迟压到微秒级,per-core 的成本从「付不起」变成「不付才亏」。其四,软件栈接上了:uclamp、EAS、HWP 这套调度器与调频器的协同协议成熟后,细粒度硬件的红利才真正被软件兑现。四个条件缺一个,全核同频都还能苟着;四个都齐了,它的退场就只是时间问题。
这一篇在知识体系里的位置
本篇是功耗管理线上「粒度」维度的专题。上游总论见 CPU 功耗与频率管理,切换成本见 DVFS 频率切换延迟;异构调度的姊妹话题见 CPU 微架构总览 中的大小核章节。
总结
per-core DVFS 让每个核拥有独立的电压频率域,硬件上靠片上集成调压器、每核分频器和跨域电平转换电路搭出来,软件上靠调度器用 uclamp 之类的接口按核上报性能需求、并在迁移时预升频掩盖切换延迟;全核同频之所以被放弃,是因为它被迫用「最忙核的需求」给全片定频定压,在负载异质化和功耗墙收紧的时代,这份浪费再也付不起——而 FIVR 与调度协同的成熟,让「不付才亏」成了现实。