split lock 性能惩罚:跨缓存行原子操作为何拖累全核、内核 split_lock_detect 怎么检测
更新时间:2026-10-04。现代 x86 上一条带
lock前缀的原子指令(如lock cmpxchg),在操作数完整落在单个 64 字节缓存行内时非常便宜:CPU 只锁这一行,其他核照常工作,背景见 缓存行上的原子锁实现 与 MESI MOESIF 缓存一致性协议。但只要操作数跨过缓存行边界——比如一个 8 字节的 long long 恰好骑在两行交界上——这条指令就退化成 bus lock(总线锁),把整台机器的内存子系统锁住几十到几百个周期。split lock 性能惩罚指的就是这类跨行原子操作带来的系统性拖慢:它不是「某条指令慢一点」,而是「全核都被它堵住」。本篇把发生条件、惩罚量级、内核 split_lock_detect 检测手段讲透,衔接 内存屏障真实开销 与 CPU 微架构总览。
本文要回答的问题
- split lock 和 bus lock 是什么关系?为什么前者必然触发后者?
- 普通行锁几十个周期,split lock 凭什么拖出几百上千周期的惩罚?
- 哪些代码写法会无意中造出跨缓存行的原子操作数?
- Linux 的 split_lock_detect 三种模式有什么区别,线上该开哪个?
- 怎么用 perf 计数器和一个最小 demo 亲手复现并定位 split lock?
一、从行锁到总线锁:split lock 为什么必然触发 bus lock
x86 的原子 RMW(Read-Modify-Write,读改写)指令历史上分两种实现。古早年代没有缓存一致性协议,所有原子操作都靠 LOCK# 信号把前端总线整个锁死——这就是 bus lock 的本义。有了 MESI 之后,硬件学聪明了:如果操作数完整落在一个缓存行里,核只要把这一行锁在自己的 L1 里(cache line locking,行锁),拒绝其他核嗅探成功,RMW 期间独占这一行即可,总线流量照常,其他核完全无感。
问题在于行锁的前提——「整个操作数在一行里」。一旦操作数跨行,比如一个未对齐的 8 字节变量占据行 A 的最后 4 字节和行 B 的前 4 字节,核就必须同时独占两行。而硬件的「锁行」机制一次只能处理一条缓存行的一致性事务,无法原子地锁住两行;要保证 RMW 的两半不被其他核插入,只能退回老办法:锁整个一致性互连(ring/mesh 或前端总线),让所有核的访存请求在锁持有期间排队。这就是 split lock 必然退化为 bus lock 的原因,惩罚从「锁一行」放大成「锁全机」。
上图是 split lock 的舞台:同一个 8 字节操作数,落在单行内走左侧行锁路径,骑在边界上就被迫走右侧 bus lock 路径。两条路径的差别不在指令本身——反汇编里都是同一条 lock cmpxchg——而在操作数的地址对齐。这意味着 split lock 惩罚是数据布局问题,改结构体字段顺序或加个对齐属性就能消除,不需要改算法。
二、惩罚量级:几百到几千周期的全核停滞
直觉上「锁一下总线」听起来不重,实际数字相当吓人。公开基准(Intel 文档与社区复现)给出的量级大致是:
| 场景 | 单次操作代价 | 影响范围 | 说明 |
|---|---|---|---|
| 行锁原子(行内对齐) | 约 20-60 周期 | 仅竞争该行的核 | 其他核完全无感 |
| split lock(退化为 bus lock) | 约 200-1000+ 周期 | 全插槽所有核 | 锁持有期间全核 miss 排队 |
| 高频 split lock 风暴 | 吞吐可掉 10 倍以上 | 整机 | 某核死循环跨行原子即拖垮插槽 |
关键点在第三列「影响范围」:行锁的代价由竞争方付,split lock 的代价由无辜方付。一个核在做跨行原子操作时,其他核连访问完全不相干的数据都会被拖慢,因为它们的一致性请求也在互连上排队。在 SMT(同时多线程,见 SMT 同时多线程)和多核服务器上,这是典型的「一颗老鼠屎」场景——某个进程的一行坏代码能把整机吞吐打下来。
更糟的是它和伪共享(false sharing)经常结伴出现:未对齐的共享计数器既跨行又被多核争抢,bus lock 与一致性流量互相放大,惩罚进一步叠加,相关背景见 缓存一致性写失效与写更新。
一个真实量级感受:某电商大促压测中,业务方一个埋点计数器因结构体 packed 布局跨了行,峰值期这台 64 核机器整体吞吐掉了约三成,排查时 CPU 利用率看着还很高、没有明显的锁竞争热点——因为代价摊给了全核的一致性等待,常规 top 和锁分析工具都看不到凶手。最后靠 dmesg 里 split lock 警告才定位到那行无辜的 __sync_fetch_and_add。修复只是给字段补了个 64 字节对齐属性,改动一行声明、没有碰任何算法逻辑,整机吞吐当天就回来了——这是 split lock 问题的典型性价比:定位难,修复极便宜。
三、哪些写法会造出 split lock
split lock 从不来自「故意的跨行设计」,几乎全是布局事故。常见来源:
- 未对齐的全局/静态原子变量:比如
__attribute__((packed))结构体里塞了一个被lock前缀操作的字段,压缩布局把字段挤到了行边界上。 - 把原子计数器放在动态分配的 buffer 里,分配器不保证 64 字节对齐,某次分配恰好骑线。
- 大于原生字宽的原子类型:某些平台上对 16 字节结构做
cmpxchg16b,起始地址不是 16 对齐时容易跨行。 - 用
std::atomic_ref或手工lock前缀操作外部传入的任意地址,调用方给的地址对齐不可控。
判定规则一句话:操作数起始地址 mod 64 + 操作数字节数 > 64,这条原子指令就是 split lock 候选。对 8 字节变量,地址落在行内偏移 57-63 的任何位置都会骑线——占全部对齐情况的约 11%,所以「偶尔出现、压测时才炸」是 split lock 问题的典型发作方式。
四、内核检测:split_lock_detect 与 perf 计数器
Linux 从 5.7 起引入 split_lock_detect 内核参数,利用 Ice Lake 之后硬件的 split lock 检测能力(触发 #AC 对齐检查异常)来抓现行。三种模式:
| 模式 | 行为 | 适用场景 |
|---|---|---|
| off | 不检测 | 老内核默认值,不推荐 |
| warn(ratelimit) | 检测到就打 dmesg 警告,并给涉事任务限速(每 10 秒最多一次 split lock) | 大多数发行版默认,线上首选 |
| fatal | 检测到即向涉事任务发 SIGBUS | 测试环境/CI,宁可挂掉也不放过 |
查看当前模式:cat /sys/devices/system/cpu/split_lock_detect。设置为 fatal 可在测试机上跑回归:echo fatal > /sys/devices/system/cpu/split_lock_detect,把任何触发 split lock 的进程当场打死,逼开发者修布局。
不靠内核参数,用 perf 也能直接数。较新的 Intel PMU 暴露了专用事件:
# 全系统统计 bus lock 次数(含 split lock 来源)
perf stat -e cpu/event=0xa4,umask=0x10/ -a sleep 10
# 定位到具体进程
perf record -e cpu/event=0xa4,umask=0x10/ -a -g sleep 10
perf report
不同代际事件编码略有差异,先用 perf list | grep -i bus_lock 确认本机支持的事件名(如 mem_inst_retired.lock_loads、bus_locks)。计数器飙升而业务并无跨行原子的「自觉」,基本就是某个未对齐字段在作怪。 PMU 编程细节见 perf 计数器与 PMU 编程。
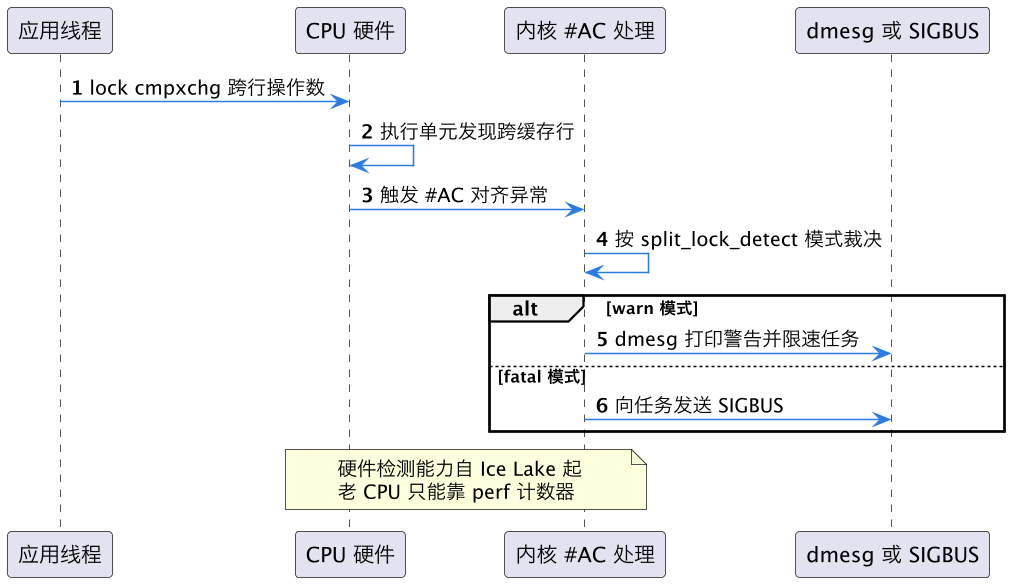
这张时序图把检测链路走了一遍:应用在第一步发出的指令本身语法完全合法,问题在第二步硬件发现操作数跨行,才在第三步抛 #AC 异常交给内核裁决。注意末尾的约束——#AC 检测是 Ice Lake(2019 年后)才有的硬件特性,老机器上内核参数无效,只能靠上一节的 perf 事件兜底。定位到指令后,修复手法固定:给原子字段加 __attribute__((aligned(64)))、用 alignas(64)、或把原子变量挪到独立缓存行(顺带消除伪共享),惩罚即消失。
这一篇在知识体系里的位置
本篇是缓存一致性系列的「病理学」一章:上游机制在 MESI MOESIF 缓存一致性协议 和 缓存行上的原子锁实现,讲清了行锁为什么便宜;本篇解释行锁失效后退化成的 bus lock 及其全核惩罚;同类「单核拖全核」问题还有 TLB shootdown 与失效广播;互连层面的阻塞传播见 Uncore Ring Mesh 互连。方法论上可配合 Top-down 性能分析方法 把 split lock 纳入后端 bound 的排查清单。
总结
split lock 性能惩罚的本质是:原子操作数跨缓存行时硬件无法用行锁保证原子性,只能锁整个一致性互连,单次代价从几十周期暴涨到上千周期且由全核买单;它是纯数据布局问题,用 split_lock_detect(warn/fatal)或 perf 的 bus lock 事件定位后,给字段补上 64 字节对齐即可彻底消除惩罚。