TLB 页表行走:多级 TLB、PW Cache 与大页如何决定一次访存的真实代价
承 TLB(Translation Lookaside Buffer) 对快表基本结构的介绍,以及 页表与地址翻译 里四级页表的由来。这两篇讲了"翻译是什么",本篇回答的是"翻译慢的时候到底有多慢、硬件用了哪些招把它救回来"。TLB 页表行走是微架构里少有的"软件能直接观察到、又能直接优化"的路径——换大页、改内存布局,收益立竿见影。
本文要回答的问题
- 一次虚拟地址翻译,从 L1 TLB 命中到四级页表行走,各要花多少拍?
- 为什么现代 CPU 要搞 L1 iTLB / dTLB + L2 STLB 三级层次,而不是一个大 TLB?
- Page Walk Cache(页表行走缓存)缓存的到底是什么,为什么能砍掉一半以上的行走访存?
- 一次完整的四级页表行走最坏要几次内存访问?2MB 大页、1GB 大页各自把它压到几次?
- 怎么用 perf 观测 TLB miss 和页表行走开销,什么信号说明该换大页了?
一、一次访存的翻译路径:命中与 miss 的代价差
每条 load/store 指令携带的都是虚拟地址。在它能去访问 L1 数据缓存之前,必须先完成"虚拟页号 → 物理页框号"的翻译。这条路径上的延迟分布极不均匀:
| 路径 | 典型延迟 | 发生频率(一般负载) |
|---|---|---|
| L1 dTLB 命中 | 0~1 拍(与 L1 缓存查询并行) | 95%~99.5% |
| L1 miss、L2 STLB 命中 | 7~9 拍 | 0.5%~4% |
| STLB miss,行走命中 PW Cache | 10~20 拍 | 取决于工作集 |
| 完整四级行走,全部走内存 | 4 次访存 ≈ 240~400 拍 | 极少但致命 |
注意最后一行的数量级差距:一次完整页表行走的代价,相当于两三百拍流水线停摆——即使乱序执行能靠 ROB 掩盖一部分,对延迟敏感的指针追踪类代码(链表、哈希表、B+ 树)依然是灾难。这类代码的特点是下一次访存地址依赖本次访存结果,乱序窗口填不满行走带来的几百拍空洞,只能干等。相比之下,顺序扫描类的负载即使 miss 率高,也能靠硬件预取和多个并发未决 miss 把延迟摊平——同样的 TLB miss 率,伤害可以差出一个数量级。
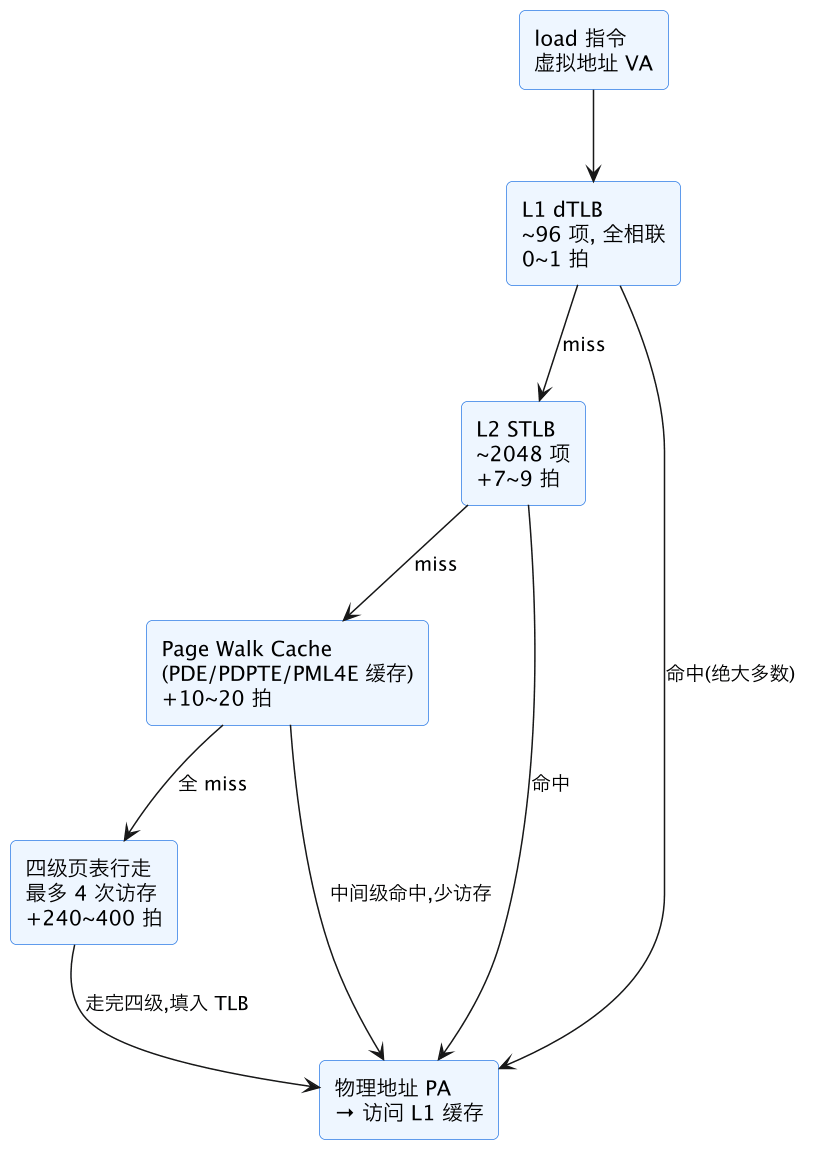
上图是翻译路径的层次全貌:越靠下代价越高,越靠上容量越小。L1 dTLB 只有几十到一百来项,靠的是"与 L1 缓存标签查询并行"做到零额外延迟;一旦 miss 滑到 STLB,就要付出一个 L2 缓存级别的访问延迟;再滑到页表行走,就是内存级别的惩罚。这个层次设计和数据缓存的 L1/L2/L3 逻辑完全同构——用小而快的结构挡住绝大多数请求,把慢路径变成小概率事件。
二、为什么是三级 TLB,而不是一个大 TLB
既然 TLB miss 这么贵,为什么不直接造一个几万项的大 TLB?答案和数据缓存一样:容量和速度不可兼得。TLB 和数据缓存面对的是同一个物理约束——SRAM 阵列越大,字线位线越长,充放电延迟越高,还要乘上组相联的比较器数量。一拍内完成的查找,阵列规模被死死限制在几十项这个量级。
L1 TLB 必须在一拍内完成查找,还要和 L1 缓存的组选并行工作,这决定了它只能做成几十项的全相联结构(Skylake 的 dTLB 是 64 项 4KB 页 + 32 项 2MB/4MB 页)。把容量做大就要加组相联路数或加长布线,时序就收不进一拍。于是硬件厂商在两个极端之间插了一级 STLB(Shared/Second-level TLB):2048 项上下、6 路组相联、七八拍的命中延迟,用稍慢的访问换 30 倍的容量。
指令侧和数据侧分开的 iTLB/dTLB,则是因为取指和访存是两条独立的请求路径,合并会打架。分离之后,代码页和数据页各占各的表项,互不挤兑。另一个不显眼的动机是时序:取指是前端第一拍就要地址,对翻译延迟最敏感;dTLB 则可以和 AGU(地址生成单元)算有效地址的那一拍重叠。两边对延迟的容忍窗口不同,分开优化更容易。
还有一个维度是替换策略。STLB 几千项的规模已经无法做全相联,只能组相联 + 伪 LRU。这意味着 STLB 也会发生"冲突驱逐":两个热点页恰好映射到同一组且组已满,就会互相踢。大页在这里又占一次便宜——一个 2MB 页只占一项,却顶 512 个 4KB 页的覆盖,把组冲突的概率直接摊薄了两个数量级。
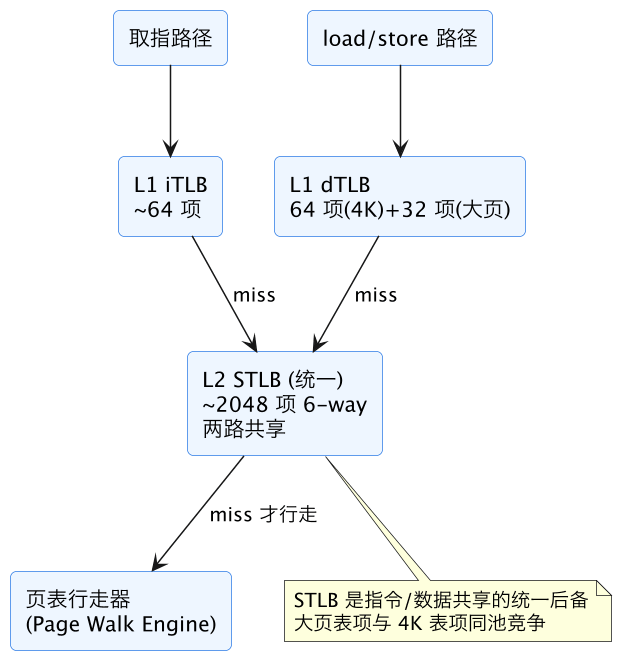
这里有个容易踩的性能坑:很多 CPU 的 L1 dTLB 对 2MB 大页只有 32 项——覆盖范围是 32 × 2MB = 64MB。如果你的大页程序工作集数据超过 64MB 且访问随机,照样会砸穿 L1 落到 STLB。STLB 有 2048 项,2MB 页下能覆盖 4GB,这才是大页真正的"覆盖面积"优势所在。
三、四级页表行走:最坏 4 次访存是怎么来的
STLB 也 miss 之后,页表行走器(Page Walk Engine,硬件状态机)登场。它拿着 CR3 寄存器里的顶级页表物理地址,沿 PML4 → PDPT → PD → PT 四级逐级查下去。每一级都是一次内存读:取出本级页表项,用其中的物理地址定位下一级,同时做权限检查(U/S、R/W、XD 位)。
为什么恰好是 4 次访存?x86-64 的 48 位虚拟地址被切成五段:9+9+9+9+12。每段 9 位索引 512 项的页表页(4KB),页内偏移 12 位。四级索引各需要一次访存才能拿到对应页表项,最后一次 PTE 才给出真正的物理页框。
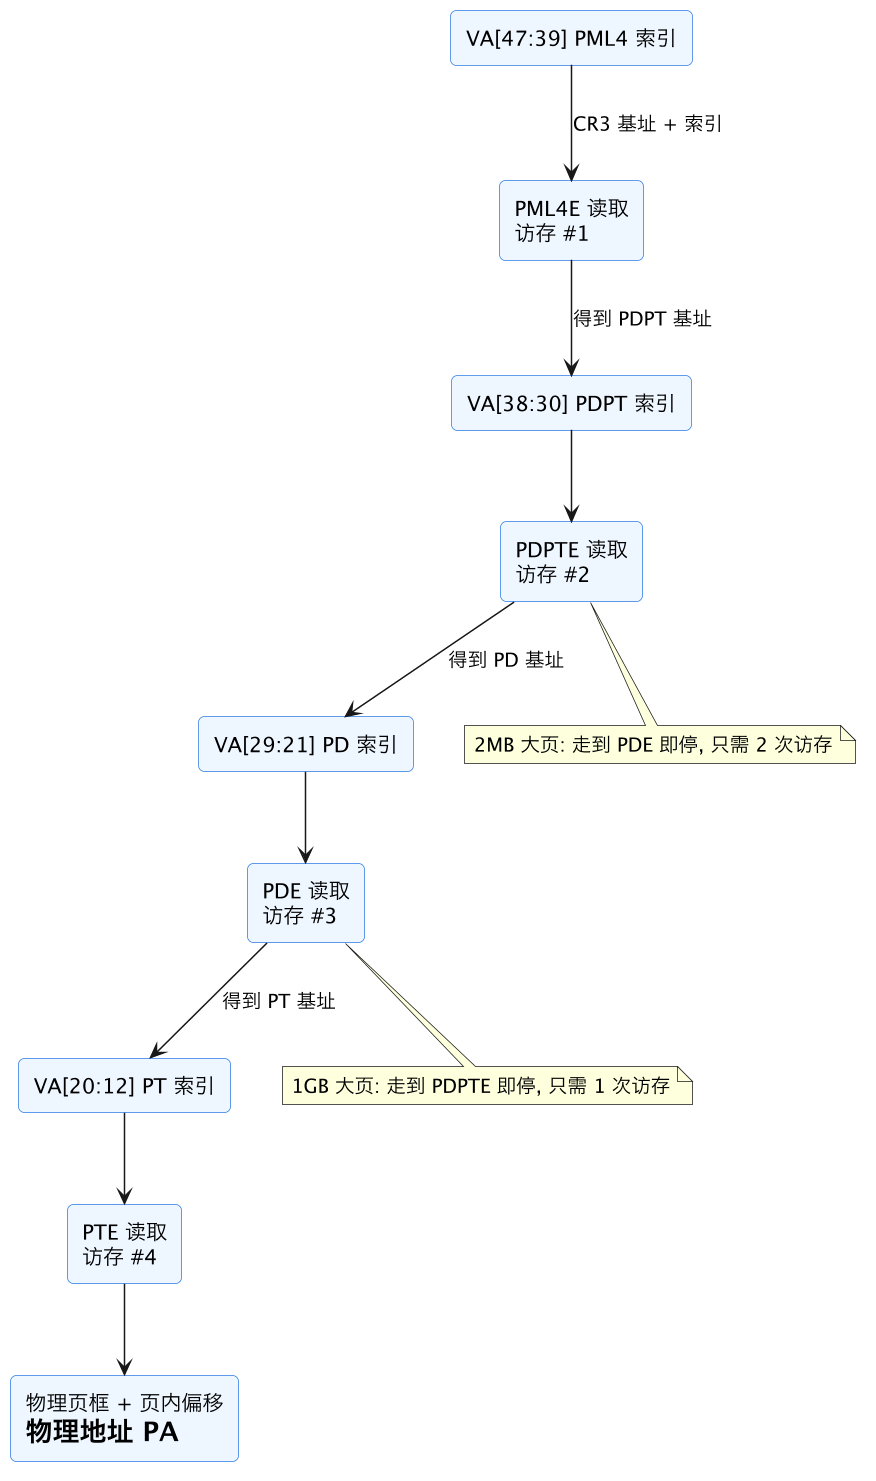
四次访存是串行的——下一级地址依赖上一级的读取结果,无法并行。以 60~100ns 的内存延迟算,一次完整行走 240~400 拍。更要命的是,同一个时刻可能有多个未完成的 TLB miss:行走器本身支持多路并发行走(Skylake 起是 2 路,新微架构更多),行走期间落的页表项还会进普通数据缓存——也就是说,四级页表页本身占着 L1/L2/L3 的空间,和热数据抢缓存。
这种"页表页挤占数据缓存"的效应在随机访问大内存的负载上尤其明显。一个 1TB 内存的数据库如果用 4KB 页,光 PT 层页表就要 2GB;这些页表页本身在缓存里进进出出,和 buffer pool 的热数据互相驱逐。这也是为什么大内存服务对大页的收益总是比小内存程序更显著——它不仅减少行走次数,还缩小了页表本身的体积:2MB 页下同样的 1TB,PT 层直接消失,只剩 PD 层,页表总量降到几 MB。
行走器还有个细节值得知道:行走过程中如果发现某一级页表项的 Present 位为 0,就立刻中止并触发 #PF 缺页异常,后续的级不再访问。所以"访问未映射地址"的代价其实小于一次完整行走——坏事反而便宜。
四、Page Walk Cache:行走路径上的抄近道
四级行走里有个强烈的局部性可利用:高级页表项覆盖的地址范围大,命中率高。一个 PML4E 覆盖 512GB,一个 PDPTE 覆盖 1GB,一个 PDE 覆盖 2MB。大量虚拟地址翻译共享同一批高级页表项。于是硬件把这些中间级页表项单独缓存起来,这就是 Page Walk Cache(Intel 叫 Paging-Structure Cache,按级拆成 PML4E/PDPTE/PDE 缓存)。
效果是:行走不必从 PML4 起步,PW Cache 里命中哪一级,就从下一级接着走。命中 PDE 缓存,只剩一次 PTE 访存;命中 PDPTE 缓存,剩两次。对访问模式规整的负载,PW Cache 能把平均行走访存次数从 4 次压到 1~1.5 次,等于把 miss 代价直接砍半以上。
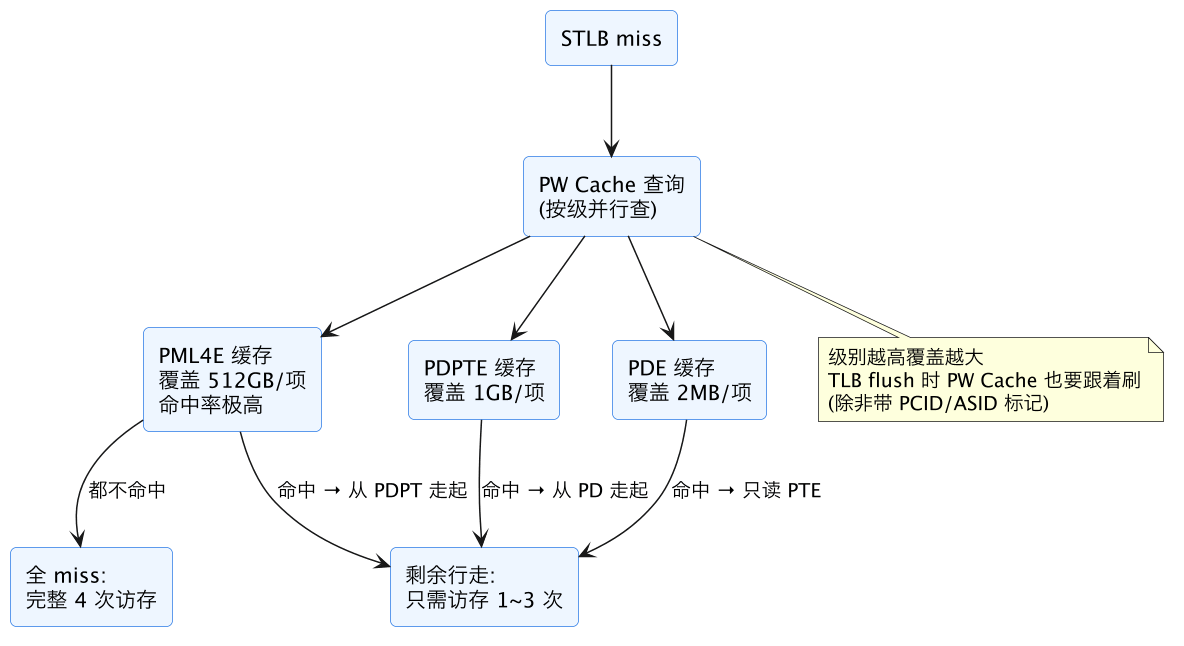
PW Cache 有一个和性能直接相关的副作用:进程切换和 munmap 后的 TLB shootdown 不只是刷 TLB,PW Cache 里缓存的中间级项同样要失效。没有 PCID(进程上下文标识)的内核,每次系统调用进出都要刷一遍,PW Cache 全废——这是 Meltdown 补丁(KPTI)当年造成严重性能回退的机制之一,后来靠 PCID 才救回来。
PCID 的原理是给每个进程分配一个 12 位的上下文标识,TLB 和 PW Cache 的表项都打上这个标签。进程切换只换 CR3 里携带的 PCID,不刷表项;新进程查表时标签不匹配自然当 miss 处理,旧进程的表项留着自己慢慢被替换。系统调用进内核也同理——内核页和用户页各用各的 PCID,进出不用刷。这套机制把 KPTI 的开销从"每次系统调用都冷启动"降到"几乎无感",是硬件给软件安全补丁擦屁股的经典案例。
多线程共享地址空间时还有一层优化:同一进程的多个线程跑在不同核上,它们共享同一套页表,TLB shootdown 需要跨核 IPI(处理器间中断)广播。内核会用惰性策略——被 shootdown 的核如果正在跑不相干进程,可以推迟到下次切回该进程时再刷,减少 IPI 风暴。这也解释了为什么高线程数 + 高频 munmap/mprotect 的程序会出现诡异的系统性抖动:瓶颈不在调用本身,而在 shootdown 广播。
五、大页的收益:一笔账算清楚
大页(2MB huge page、1GB gigantic page)同时从两个方向降低翻译开销:
- TLB 覆盖面积。2048 项 STLB × 4KB 只覆盖 8MB;换成 2MB 页就是 4GB。工作集在 8MB~4GB 之间的程序,STLB miss 率可以从"常驻"降到"接近零"。
- 行走深度。2MB 页的翻译在 PD 级就拿到页框,行走只需 3 次访存;1GB 页更短,2 次。即使 miss,代价也更低。
| 页大小 | STLB 全覆盖(2048 项) | 行走访存次数 | 适用场景 |
|---|---|---|---|
| 4KB | 8MB | 4 次 | 默认,零碎内存 |
| 2MB | 4GB | 3 次 | 数据库 buffer pool、JVM 堆、KV 存储 |
| 1GB | 2TB | 2 次 | 超大内存数据库、科学计算主存区 |
落到配置层面,Linux 给三条路:透明大页 THP(内核自动把匿名页合并成 2MB,/sys/kernel/mm/transparent_hugepage/enabled 控制)、显式 hugetlbfs(预留大页池,应用 mmap 时指定,确定性最强)、以及 libhugetlbfs 这类用户态库做存量程序的零改造接入。经验上:延迟敏感、内存足迹固定的服务(Redis、MySQL buffer pool)用 hugetlbfs 预留,避免运行时碎片;普通服务用 THP 的 madvise 模式,让应用自己声明哪段内存值得大页。JVM 配 -XX:+UseLargePages、Redis 关掉 THP always 的告警,背后都是同一笔账。
一个典型的量化感受:Redis 这类常驻内存几十 GB 的服务,4KB 页下 STLB miss 引起的页表行走可占 5%~15% 的 CPU 周期;切到透明大页(THP)或显式 hugetlbfs 后,这部分开销通常压到 1% 以下,整体吞吐提升 5%~10%。代价是内存碎片和分配延迟(2MB 连续物理页不好凑),所以 THP 的 madvise 模式比 always 更适合通用负载。
观测手段很直接:
perf stat -e dTLB-load-misses,dTLB-store-misses,\
iTLB-load-misses,page-faults ./app

# Intel 还有行走专属事件
perf stat -e cycle_activity.stalls_l2_miss,\
dtlb_load_misses.walk_completed_4k,\
dtlb_load_misses.walk_completed_2m_4m ./app经验判据:dTLB-load-misses / instructions 明显偏高、且程序本身内存足迹超过几 GB 时,先别怀疑缓存,查大页配置;walk_completed 系列计数器的绝对值乘以 200 拍左右,就是行走吃掉周期的量级估算。更直接的思路是对照:同一份负载分别用 THP=always 和 THP=never 跑一遍,cycles 和 dTLB-load-misses 两条曲线的差值,就是翻译开销的真实占比。这一步几分钟就能做完,比从 IPC 公式里反推可靠得多。
需要泼一盆冷水:大页不是免费的。2MB 页意味着物理内存要按 2MB 粒度对齐分配,小文件、短生命周期对象混在大页区里会造成内部碎片;THP 在内存紧张时做页合并(khugepaged 后台扫描压缩)本身吃 CPU,极端情况下合并时的同步压缩会卡住分配路径几十毫秒——这就是 MongoDB 官方文档直接建议关掉 THP 的原因。所以"要不要大页"永远是数据说话:先量化 miss 开销,再评估碎片代价。
六、这一篇在知识体系里的位置
本篇是地址翻译链路上的"性能层",向上向下都有接应:
- 向上接结构篇:TLB(Translation Lookaside Buffer) 讲快表的组织与替换;页表与地址翻译 讲四级页表的格式与权限位。
- 横向看微架构:TLB miss 是流水线停顿的重要来源之一,与 IPC 瓶颈分析 里的前端/后端停顿分类同属"stall 账本";行走期间对数据缓存的挤占,呼应 数据冒险之 L1 miss 的缓存争用视角。
- 向下落到观测:perf 计数器的进一步用法见 tools 观测工具目录 下 CPU 与 memory 分组;进程内存布局对照 pmap 进程内存布局。
一句话串起来:翻译结构(页表)→ 翻译加速(TLB 层次 + PW Cache)→ 翻译开销量化(行走拍数)→ 软件优化(大页),本篇负责后三段。
总结
TLB 页表行走是虚拟地址翻译的兜底慢路径:L1/L2 TLB 层次用"小而快换大而全"挡住绝大多数翻译,漏网的由 Page Walk Cache 靠高级页表项的大覆盖范围把 4 次串行访存砍到 1~2 次;真落到完整行走就是 240~400 拍的内存级惩罚。软件手里最有效的杠杆是大页——2MB 页把 STLB 覆盖面积放大 512 倍、行走深度缩短一级,对大内存常驻服务往往值 5%~10% 的吞吐;用 perf 的 dTLB-miss 与 walk_completed 计数器先量化、再决定要不要动 THP,是标准动作。