gshare 预测器:从 bimodal 两位计数器到全局历史异或,分支相关性如何被捕捉
更新时间:2026-10-02。分支预测 那篇建立了整体动机:取指阶段每个周期都必须猜下一块指令从哪来,猜错一次,深流水线十几级全部作废,代价是十数个周期的气泡。框架文里提到方向预测器走过几代——一位计数器、两位饱和计数器(bimodal)、局部历史、全局历史、gshare、再到 TAGE。这一篇把中间两代的交界处讲透:bimodal 为什么能到 90% 上下的准确率却撞上天花板,gshare(global share)又是怎么只加一个异或门、一条移位寄存器,就把「分支之间的相关性」这座金矿挖开的。它是理解 TAGE 分支预测器 的必要前传——TAGE 的所有复杂度,本质上都是在修补 gshare 暴露出的那几处短板。
本文要回答的问题
- bimodal 的两位饱和计数器是怎么工作的,为什么两位比一位好、三位却没必要?
- bimodal 撞上的精度天花板是什么,为什么它「看不见」分支之间的相关性?
- 全局历史寄存器 GHR 记了什么,异或索引为什么是「穷但聪明」的散列方式?
- 投机执行下 GHR 怎么更新、误预测后怎么恢复,状态一致性怎么保证?
- gshare 的别名冲突有多伤,它留下了哪些短板等 TAGE 来补?
一、bimodal:一张两位计数器表能走多远
bimodal 是方向预测器里最简单能用的一代:一张表,用分支 PC 的低位若干位做索引,每个表项是一个两位饱和计数器。所谓「两位饱和」,是四个状态:强 not-taken(00)、弱 not-taken(01)、弱 taken(10)、强 taken(11)。高位就是预测方向——0 猜不跳,1 猜跳。每次真实结果揭晓,计数器往对应方向挪一格,到端点就停(饱和),不再翻转。
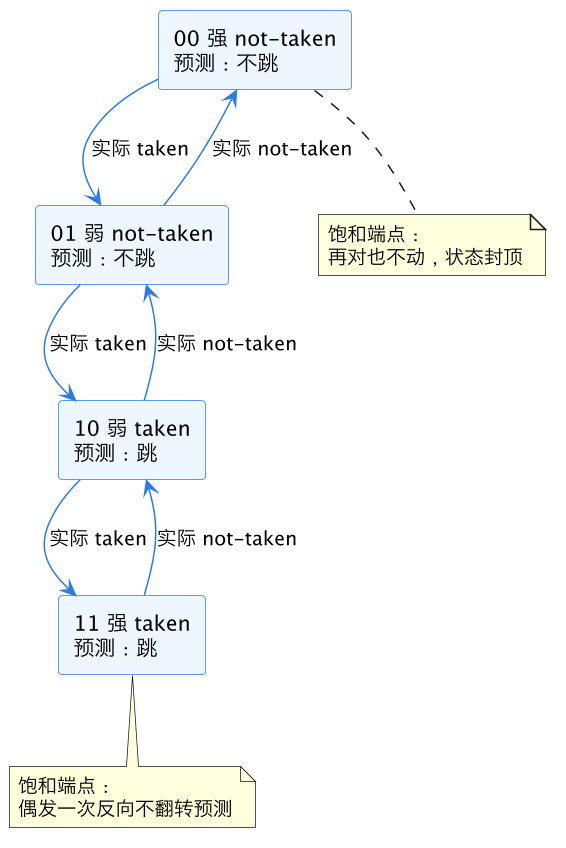
上图是两位计数器的状态机,整张 bimodal 表就是几千个这样的小状态机并排。为什么两位是甜点?拿一位计数器对比最清楚:一位就是直接记「上次跳没跳」,一个跑 N 次的循环,退出那次(not-taken)会把状态翻成 0,下次进入循环第一次迭代(taken)又被猜错——每个循环周期稳定错两次。两位计数器加了迟滞:第一次反向只把状态从「强」打成「弱」,预测方向不变,于是循环退出错一次,重新进入不再错。每周期错两次降成错一次,循环密集的代码上这是实打实的几个百分点。而三位、四位迟滞虽然更「黏」,收益急剧递减——循环退出那一次反正躲不掉,加位只是让预测器对真正的模式变化反应更迟钝,还多花一倍的表存储。两位是「迟滞收益」和「存储开销」的交点,这个结论从 1992 年 Smith 的论文到今天没变过。
一张 4K 表项的 bimodal 表只要 1KB 存储(4096 项乘 2 位),单周期可访问,在 90 年代中期的商用核上就能把方向预测准确率做到 88%-93%。听起来不错,但放在 4 发射、十几级流水的核上,10% 的方向误预测率意味着每几十条指令就清一次流水线,CPI 直接被拖高 30% 以上。bimodal 的天花板不是表不够大,而是它的输入信息里只有 PC,没有上下文。
二、bimodal 看不见什么:分支间相关性
用一句伪代码把问题钉死:
if (a > 0)  { ... }   // B1
if (b > 0)  { ... }   // B2
if (a + b > 0) { ... } // B3
B1 和 B2 都成立时,B3 几乎必然成立。一个只看 B3 自己历史的 bimodal 表项,学到的是「B3 大部分时间跳」;但当 B1 或 B2 偶尔不成立时,B3 翻转的那一拍它永远猜不对——因为决定 B3 方向的关键信息根本不在 B3 的历史里,在 B1 和 B2 的结果里。这种「前序分支的结果决定当前分支的方向」就叫分支间相关性(inter-branch correlation),它在真实代码里无处不在:循环嵌套的外层退出、连续的条件检查、状态机的转移、指针判空链。
还有一类更隐蔽的:路径相关性。同一个 if 语句,从函数调用链 A 走到它和从调用链 B 走到它,方向倾向完全不同。bimodal 把两条路径来的访问混进同一个表项,计数器被来回拉扯停在弱态,等于每次都抛硬币。
总结成一句话:bimodal 把每条分支当成独立事件,而真实程序里分支是一张互相纠缠的网。要破这个局,得给预测器喂「最近发生过什么」——这就是全局历史。
三、gshare:一条移位寄存器加一个异或门
gshare 的硬件增量小得惊人,就两样东西。
第一样是全局历史寄存器(GHR,Global History Register),一条 N 位移位寄存器。每退休(或预测)一条条件分支,就把它的方向塞进最低位、整体左移:taken 记 1,not-taken 记 0。于是 GHR 里永远装着「最近 N 条分支的方向序列」——这就是全局上下文。
第二样是一个异或门阵列。查表时不再只用 PC 索引,而是把 PC 的低位与 GHR 按位异或,结果作为索引去访问那张熟悉的两位计数器表(在 gshare 语境里常叫 PHT,Pattern History Table,模式历史表)。更新的索引同样用异或值,保证写回打到同一个槽位。
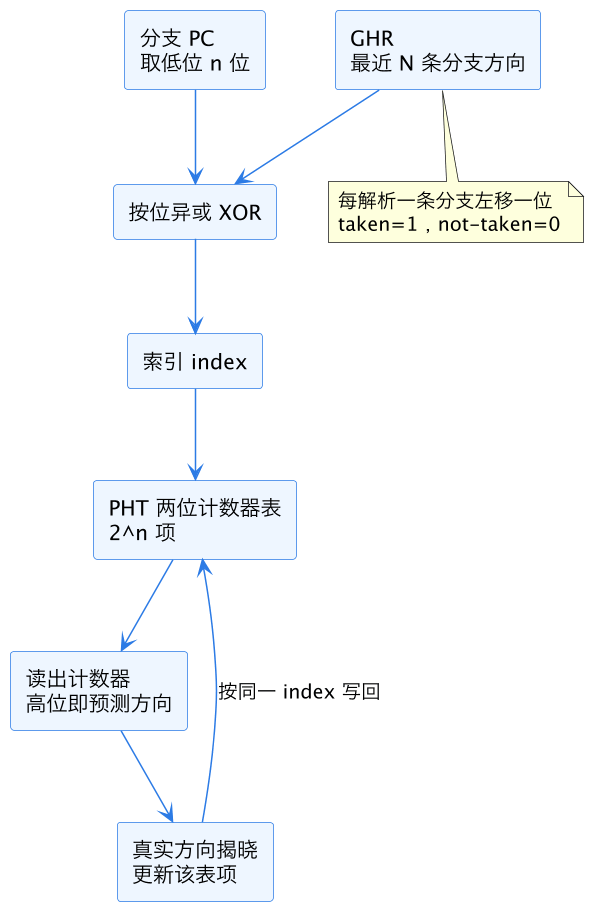
上图就是 gshare 的全部数据通路,名字里 share 指的就是「PC 与全局历史共享索引位」。为什么异或这一步如此关键?可以把它理解成一个零成本的散列:同一条分支(PC 相同)在不同的历史模式下会落到表的不同槽位——B3 在「B1、B2 都 taken」的历史下用一个槽位,在「B1 not-taken」的历史下用另一个槽位,两个槽位各自训练自己的计数器,相关性就被分槽学出来了。反过来,PC 的参与让不同分支在相同历史下也大概率落不同槽,减少互相踩踏。异或的对称、均匀、单周期特性,恰好全中硬件的需求:要散列效果但不能要乘法器的面积和延迟。
回头看第二节那个 B3 的例子:GHR 宽度取 2 就够,「11」历史对应「B1、B2 都跳」,B3 在这个槽位被稳定训成强 taken;一旦历史变成「01」,索引换了槽位,新槽位学到「这时 B3 不跳」。bimodal 里那个被来回拉扯的表项,在 gshare 里被拆成了四个各安其位的表项。硬件代价呢?一条 12 位移位寄存器加 12 个异或门——在今天连一个反相器链的延迟都算不上,却能在典型负载上把误预测率从 bimodal 的 10% 压到 6%-8%。
把上面这套机制浓缩成一张卡,方便和 bimodal 对照着记:输入是 PC 与 GHR 两路,散列只做一个异或,训练按槽位各自进行,收益是相关性被分槽捕捉。
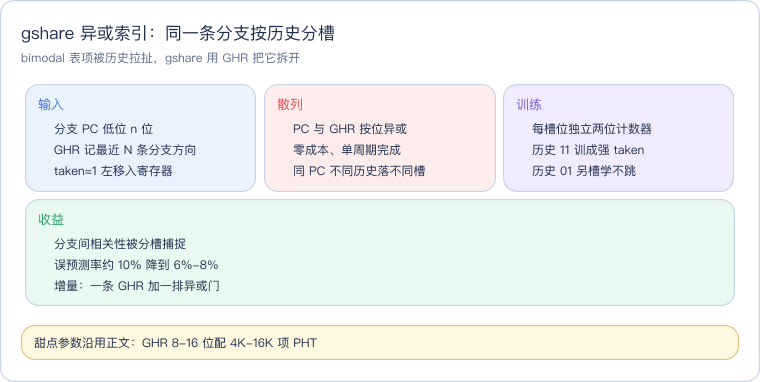
这张卡要抓住的一条主线是「分槽」:bimodal 的一个表项被迫服务所有历史模式,gshare 让每种历史模式各用各的计数器——相关性不是被「算」出来的,是被「散列摊开再各自统计」出来的。
GHR 宽度 N 怎么选,是第一个真正的设计旋钮。N 小了(比如 4),只能捕捉很近的相关性,稍远的前序分支就溢出视野;N 大了(比如 16),表项数不变的情况下,同一个 PC 会散到 2^N 个槽位,训练被摊薄——每条历史模式出现的次数变少,计数器迟迟训不到强态,冷启动期拉长。经典论文(McFarling 1993,gshare 的出处)给的甜点是 8-16 位配合 4K-16K 项的表,这个结论至今仍是教科书默认值。
四、投机的暗面:GHR 的更新与恢复
到这里只讲了「事后诸葛」视角的更新。真实流水线里有个尖锐的时序问题:分支方向要等执行阶段才知道,可取指阶段每个周期都在预测新分支,GHR 等不起。如果等结果揭晓才更新 GHR,中间隔着十几级流水,后面几十条分支的预测用的全是过期历史,相关性还没用上就馊了。
工程上的答案和整个乱序核的哲学一致:投机更新 + 快照恢复。预测出一条分支的瞬间,就把预测方向移入 GHR——不等确认,先信自己。同时把移位前的 GHR 旧值(或等价的恢复信息)随这条分支的预测元数据一起存下来,跟着指令流向流水线后端。一旦这条分支被判误预测,用存下的旧值把 GHR 一把刷回,相当于撤销这条分支及其之后所有投机分支对历史造成的影响。
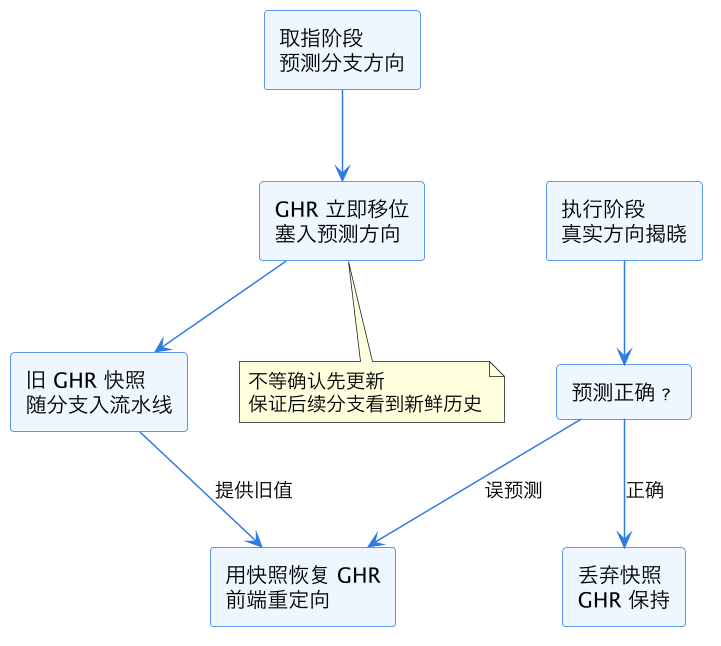
上图是 GHR 的投机生命周期。注意快照存的必须是移位前的旧值而不是「撤销一位」——因为误预测时这条分支的真实方向也要参与重建历史(正确做法是恢复快照后再移入真实方向),而且它和它之后已经投机移入的若干位全都要作废。这套「先斩后奏、错了回滚」的机制和 ROB 重排序缓冲 的提交检查点、精确异常与流水线冲刷 是同一种思想在预测器里的投影:整个乱序核就是一台「大胆投机、精确恢复」的机器,gshare 的 GHR 只是其中一个状态元件。
还有一个容易踩的细节:GHR 该在预测时更新还是提交时更新,各家实现不同。预测时更新(主流)历史最新但依赖恢复机制;提交时更新最干净但历史陈旧。也有折中:取指时更新一份投机 GHR,提交时维护一份架构 GHR,误预测用架构份重建。无论哪种,PHT 表项本身从不回滚——误预测路径上的训练数据被允许留在表里,实验表明这点「脏数据」的害处远小于恢复表项的硬件代价,是预测器设计里一个经典的「容错换简单」决策。
五、gshare 的短板:别名、固定长度与冷启动
gshare 把精度推上了一个台阶,但它的每个简化都对应一个明确的短板,这些短板正是后来所有研究的靶子。
短板一:别名冲突(aliasing)。 PHT 表项没有 tag,索引相同的两组「PC + 历史」就物理共享一个计数器。良性的冲突(两组模式方向一致)无害,恶性冲突(方向相反)会让计数器永远停在弱态来回振荡,两条本来可以完美预测的模式互相把对方打到抛硬币。表越大冲突越少,但表的容量受面积和单周期访问延迟双重卡死,不可能无限加。
短板二:历史长度一刀切。 全表共用同一个 N。但不同分支需要的相关距离天差地别:内层小循环 4 位历史足够,外层大循环退出可能要记住上百条分支前的模式。N 取小了长程相关看不见;N 取大了,短历史就能预测的分支也被迫用 N 位历史散到 2^N 个槽位,训练摊薄、冲突加剧——历史污染:大多数人的需求被少数人的需求绑架。
短板三:训练时间与冷启动。 每条「PC + 历史」组合都是独立表项,程序换了执行阶段、换了输入数据,历史模式大变,等于一大批表项从头训练。两位计数器从弱态训到强态至少要连续对两次,长跑负载无感,阶段切换频繁的负载会持续交学费。
把 bimodal 与 gshare 放在一起对照,以及它们各自指向的后续方向:
| 维度 | bimodal | gshare | 后续补丁 |
|---|---|---|---|
| 输入信息 | 仅 PC | PC + 全局历史 | 多长度历史(TAGE) |
| 表项确认 | 无 tag | 无 tag | tag 匹配消别名(TAGE) |
| 捕捉相关性 | 完全不能 | 固定距离内 | 几何级多距离 |
| 硬件增量 | 一张表 | 表 + GHR + 异或 | 多张带 tag 表 |
| 典型误预测率 | 约 10% | 6%-8% | 3%-5%(TAGE 家族) |
| 主要死因 | 看不见分支间相关 | 别名 + 单一长度 | 循环退出、训练慢 |
这张表还漏了一条暗线:局部历史。在 gshare 之前还有一支用「每条分支自己的历史」做索引的局部预测器(两级自适应),对固定模式的循环分支效果极好,但完全抓不住分支间相关。Alpha 21264 的锦标赛预测器把局部、全局两个预测器并联、再用一个选择器学「这条分支听谁的」,是 bimodal/gshare 思想的直接杂交;而 TAGE 则把「全局历史」这一条路走到极致,用几何级长度的多张表同时回答短板二。这条谱系的展开,正是 TAGE 分支预测器 那篇的内容。
六、为什么今天还要读懂 gshare
gshare 作为独立预测器已经退出高性能核的舞台,但它在三个意义上仍是必修课。
第一,它是精度-成本比的基准线。任何新预测器论文都要回答「比同存储预算的 gshare 好多少」,CBP 竞赛的基线实现里至今有它。读懂 gshare 才知道「每千条分支误预测降 1 个」是多大的事。
第二,它的两个核心机制——GHR 异或散列、投机更新加快照恢复——原样活在所有现代预测器内部。TAGE 的每张表索引仍是「PC 与折叠历史做异或系散列」,只是折叠函数更复杂;GHR 的快照恢复在 TAGE、ITTAGE 里一字不改,只是 GHR 长度从十几位涨到上千位,快照管理跟着复杂化。把 gshare 的数据通路和恢复协议吃透,TAGE 就只剩「表多了、历史长了」这一层增量。
第三,gshare 是观测性能问题时的思维工具。用 perf 看 IPC 瓶颈 里的 branch-misses 计数时,脑子里有「这个预测器大致是按 PC 加历史散列的」这幅图,就能解释为什么某些代码模式(短周期数据相关分支、指针追逐里的条件)是预测器的死穴,也就能理解为什么把分支改成查表或无分支算术常常带来超线性收益——你消除的不只是一次跳转,而是一次 15-20 周期的全流水线清空,清空的全过程见 取指被 taken 分支打断的气泡 与 CPU 乱序执行 两篇的流水线图。
这一篇在知识体系里的位置
本篇是微架构模块方向预测线的中坚篇,上承 分支预测 的整体框架,下启 TAGE 分支预测器 的现代深水区。目标地址侧的并行线见 BTB 分支目标缓冲 与 间接分支预测;投机恢复机制的同族思想见 ROB 重排序缓冲 与 精确异常与流水线冲刷;整条微架构地图见 CPU 微架构总览。
总结
gshare 预测器在 bimodal 两位饱和计数器表的基础上,只加一条记录最近 N 条分支方向的全局历史寄存器和一排异或门,让「PC 异或 GHR」散列出索引,从而把分支间相关性分槽学进计数器,以近乎免费的硬件代价把误预测率从约 10% 压到 6%-8%;它留下的别名冲突、单一历史长度、冷启动三大短板,恰好定义了此后三十年分支预测研究的全部议程,而它发明的「历史散列 + 投机更新 + 快照恢复」范式至今仍是每一颗高性能核里预测器的骨架。