内存一致性模型:SC、TSO 与弱序模型到底允许 CPU 乱到什么程度
承 store-buffer-write-combining——那一篇讲了 store buffer 这个硬件结构为什么存在:写不能傻等缓存一致性消息回来,先扔进 buffer 里继续跑。但它留下了一个更尖锐的问题:写进了 store buffer、还没对其他核可见,这时候另一个核读到了什么? 单核程序里这不是问题(有 store-to-load-forwarding 兜底),多核程序里这就是「我的写什么时候被对方看见、按什么顺序被看见」的生死问题——锁、无锁队列、Dekker 互斥,全押在这上面。内存一致性模型(Memory Consistency Model)就是 ISA 对这个问题给出的契约:哪些重排是硬件保证不做的,哪些是可以做、程序员要自己加 fence 挡的。看不懂这份契约,写出来的并发代码在 x86 上对了、搬到 ARM 上就随机爆炸。fence 在各架构的具体指令形态见 memory-model-fences-arch,本篇聚焦模型本身。
本文要回答的问题
- 顺序一致性(SC)定义的「正确」长什么样,为什么现代 CPU 没一家照它做?
- x86 的 TSO 相对 SC 放开了哪一种重排,store buffer 是怎么把 Store→Load 重排变成现实的?
- 经典 litmus test(Store Buffering、Message Passing、Load Buffering)在各模型下的合法结果分别是什么?
- ARM/RISC-V 的弱序模型比 TSO 多放开了什么,为什么它的能效优势来自这里?
- fence 指令(mfence/dmb)在每个模型里各自堵哪条缝,C++ 的 acquire/release 语义最后映射成什么指令?
一、先把「一致性」和「连贯性」分开
中文语境里 coherence 和 consistency 经常被混成一锅,但它们是两层契约:
- 缓存连贯性(Cache Coherence):对同一个地址,多核看到的写按一个全序到达——MESI 协议保证的就是这件事(见 mesi-protocol)。它是机制层,管一行。
- 内存一致性模型(Memory Consistency Model):对不同地址的多次读写,其他核观察到的先后顺序是什么。它是契约层,管全局。
一个系统可以完全连贯(每行都有 MESI 保护)同时又是弱序的——x86、ARM 全是这样。连贯性保证「X 这个地址的值不会精神分裂」,一致性模型决定「我写了 X 再写 Y,别人能不能先看到 Y 再看到 X」。下面这张图把两层契约的关系摆清楚。
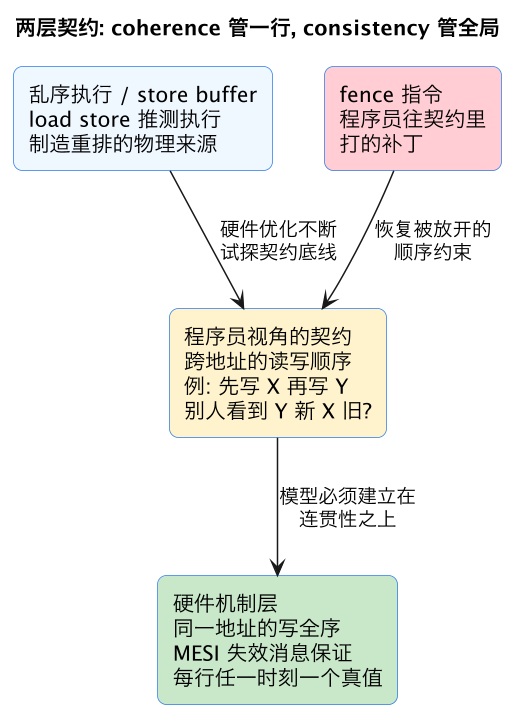
内存一致性模型的本质是程序员和硬件之间的停战协议:硬件答应「这些顺序我一定保」,换取「其余的你们别管我,我要跑快」。不同 ISA 的分歧只在于停战线画在哪。
二、顺序一致性:最直觉也最奢侈的基线
Lamport 在 1979 年给出的定义,至今仍是所有模型的参照原点:**顺序一致性(Sequential Consistency,SC)**要求整个多核系统的执行结果,等价于「所有核的访存操作按某个全局顺序串行执行,且每个核内部的程序顺序不被打破」。两个条件缺一不可:
- 存在全局统一的操作序列(任意观察者看到的顺序一致);
- 每个核的操作在该序列里保持自己的程序顺序。
用人话说:像一台快得离谱的单核机在轮流执行各线程的指令。程序员论证并发正确性时,脑子里跑的就是 SC 模型——Dekker 算法、peterson 锁的正确性证明全部默认 SC。
问题在于 SC 禁掉了几乎所有值钱的硬件优化。乱序执行(见 cpu-out-of-order)在单核内可以放肆重排,因为 ROB 提交时会装出顺序的假象;但访存操作一旦出核、对其他核可见,就装不下去了。SC 要求每次写立刻全局可见、每次读读到全局最新,意味着:写必须等失效消息收齐才能算完成(不能进 store buffer),读不能越过前面未完成的写(不能有 store buffer 导致的写后读重排)。这两条直接把现代微架构的两个关键缓冲结构判了死刑,性能损失实测可达 30% 以上。
于是工业界集体选择了「比 SC 弱一点」的模型,分歧只在弱多少。
三、TSO:x86 的选择,只放开写后读
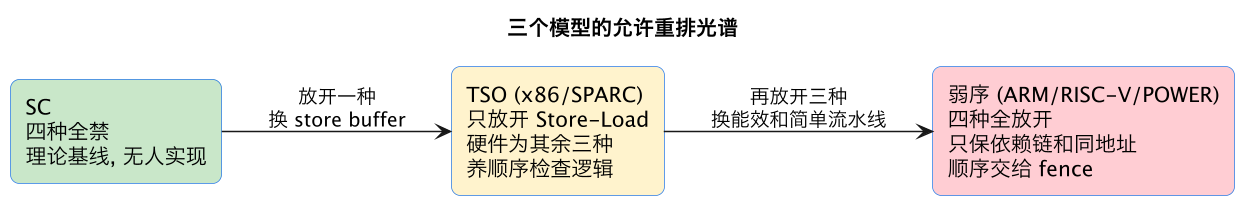
x86(以及 SPARC 的历史选择)采用 TSO(Total Store Order,全存储序):相对 SC 只放开一种重排——写后读(Store→Load)可以乱,其余三种组合(Load→Load、Load→Store、Store→Store)全部保序。
TSO 的允许重排恰好就是 store buffer 的副产品。写指令退休时把值扔进 store buffer 就算「逻辑完成」,CPU 继续执行后面的 load;而 store buffer 里的写要等拿到缓存行独占权才真正刷进一致性域、对其他核可见。于是一个核自己的程序顺序是「先写 X 后读 Y」,但别的核观察到的是「读到 Y 的旧值这件事,发生在 X 的新值可见之前」——Store→Load 被重排了。硬件结构的细节见 store-buffer-write-combining,这里只关心它造成的可观察行为。
经典判例是 Store Buffering litmus test(简称 SB,也叫 Dekker 核心):
| 核 0 | 核 1 |
|---|---|
X = 1(store) | Y = 1(store) |
r0 = Y(load) | r1 = X(load) |
问题:执行结束后 r0 = 0 且 r1 = 0 合法吗?
- SC 下不合法。两个 store 必有一先一后,后执行 store 的那个核,它随后的 load 至少能看到对方先发生的那个 store,不可能两个 load 都读到初值 0。
- TSO 下合法。两个核的 store 都蹲在各自 store buffer 里没刷出去,两个 load 都读了内存旧值——各自「自己的写对自己后面的读」靠 store-to-load forwarding 不受影响(见 store-to-load-forwarding),但对别人的写就是看不见。
这个测试在真实 x86 机器上能稳定复现 r0 = r1 = 0,大约每几十万次迭代出现一次——它不是理论恐吓,是每天都在发生的硬件行为。而它的直接推论非常反直觉:x86 上两个核互相写标志位再读对方标志位做互斥(Dekker 算法),不加 fence 是错的。这正是 Peterson/Dekker 在现代 CPU 上必须插 mfence 的原因。
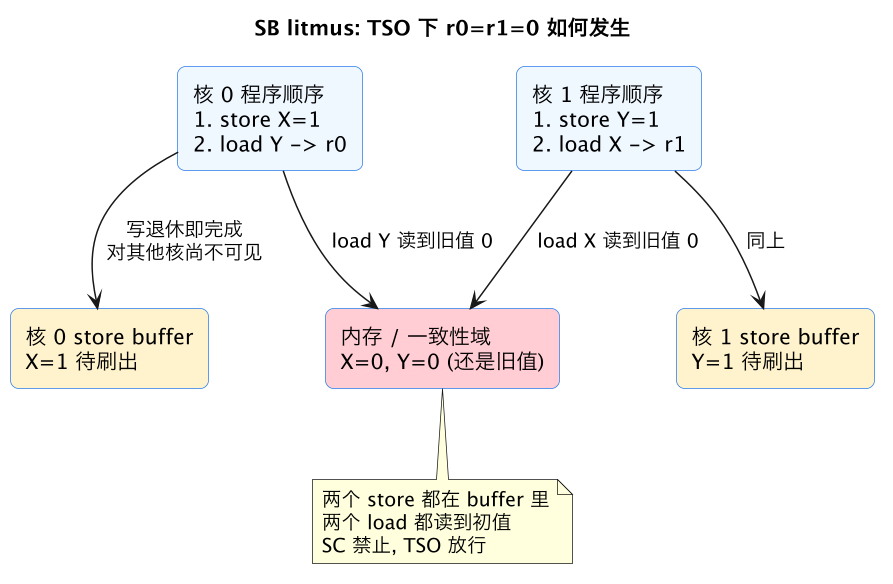
这张图的关键点:重排不是发生在「执行」阶段——load 确实在 store 之后执行——而是发生在「可见性」阶段。TSO 保的是提交序,不保可见序,中间的时间差就是 store buffer 的驻留窗口。
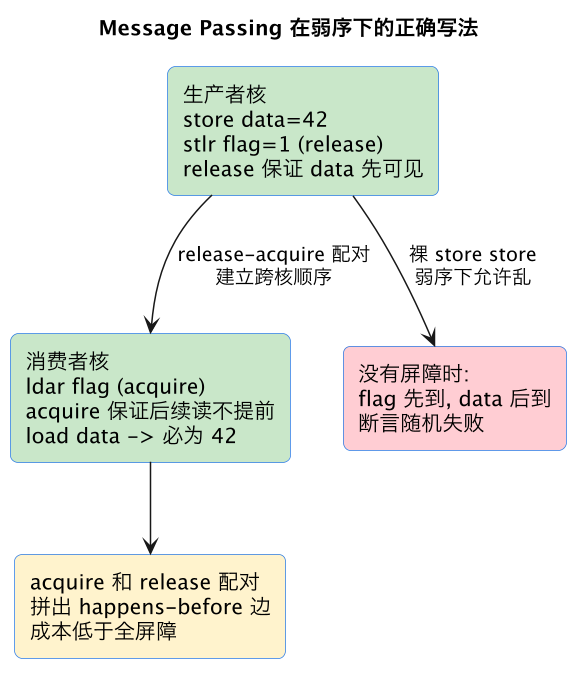
TSO 里还保留一条常被忽略的保序:Store→Store 保序意味着消息传递模式天然安全:
| 核 0(生产者) | 核 1(消费者) |
|---|---|
data = 42 | while (!flag); |
flag = 1 | assert(data == 42) |
在 x86 上这个断言永远不会失败:两个 store 按序刷出 store buffer,消费者看到 flag=1 时 data=42 必然已可见。海量 x86 并发代码隐含依赖这条性质——这也是同一份代码搬到 ARM 上爆炸的重灾区,后文详述。
四、弱序模型:ARM 和 RISC-V 放开的全部四种重排
ARM(AArch64)、RISC-V(RVWMO)、POWER 走的是另一条路:四种 load/store 组合的重排全部允许——Load→Load、Load→Store、Store→Store、Store→Store 之外还包括 Store→Load。契约退守到只剩几条底线:
- 同一核内,有数据依赖、地址依赖、控制依赖的操作保序(依赖链不能断,否则单核语义都保不住);
- 对同一地址的访问保序(coherence 兜底);
- 其余一切顺序,程序员想要就自己插屏障。
为什么敢这么干?因为保序是有价的。Store→Store 保序要求 store buffer 按 FIFO 顺序刷出,后一个写不能插队;Load→Load 保序要求 load 队列(LSU 结构见 lsu)里的推测读不能随便提前发出、或者提前了要能被load-store-queue-disambiguation 和 memory order violation 检测机制兜底回滚。x86 为了保这些序,在 LSU 里养了昂贵的顺序检查硬件;ARM 把这些全砍掉,换来的是更简单的流水线、更低的每访存能耗——移动端处理器对功耗的执念,直接体现在内存模型的选择上。
回到上一节的 Message Passing 例子,在弱序模型下 assert(data == 42) 可以失败:flag = 1 先刷出 store buffer、data = 42 还在排队,消费者看到旗子举起来了,数据还是旧值。同样 Load Buffering 测试(两个核各自 load 对方的变量再 store 自己的,r0 = Y; X = r0 之类)在弱序下允许读到对方「未来的写」这类循环因果结果——ARM 连部分这类结果都放行,POWER 更甚,RVWMO 则在反复修订中收紧了最怪异的几条。
四种重排的合法性与典型后果汇总:
| 重排组合 | SC | TSO (x86) | 弱序 (ARM/RISC-V) | 出事的典型代码 |
|---|---|---|---|---|
| Store→Load | 禁 | 允许 | 允许 | Dekker 互斥、SB 测试 |
| Store→Store | 禁 | 禁 | 允许 | 消息传递、发布数据加标志位 |
| Load→Load | 禁 | 禁 | 允许 | 读后读的因果链、指针解引用(ARM 对地址依赖例外保序) |
| Load→Store | 禁 | 禁 | 允许 | 读标志位再写数据的传播模式 |
五、fence:往契约上打补丁
模型放开得越多,程序员手里的 fence 就越重要。fence(内存屏障)的语义一句话:屏障之前的访存对外的可见顺序,不得晚于屏障之后的访存。它不改变单核执行顺序,改的是「出核可见」的顺序——本质是把 store buffer 刷空、或给 load/store 队列加约束标记。
各架构的指令形态(细节见 memory-model-fences-arch):
| 需求 | x86 | ARM64 | RISC-V |
|---|---|---|---|
| 全屏障(堵 Store→Load) | mfence(或 lock 前缀指令) | dmb sy | fence rw,rw |
| 写屏障(堵 Store→Store) | 编译器屏障即可(硬件保序) | dmb st | fence w,w |
| 读屏障(堵 Load→Load) | 不需要 | dmb ld | fence r,r |
| 带序原子操作 | lock cmpxchg 天然全序 | ldar/stlr(acquire/release 版 load/store) | amoswap.aq/rl |
注意这张表揭示的一个事实:x86 的 lock 前缀原子指令自带全屏障语义,它要把 store buffer 刷空才能拿总线锁——这是 x86 原子操作贵的真正原因之一(其余原因见 cache-lock-contention-bouncing)。而 ARM 的 ldar(load-acquire)和 stlr(store-release)是「半屏障」:stlr 保证它之前的访存先可见,ldar 保证它之后的访存不能提前。一对 acquire/release 恰好拼出消息传递所需的顺序,成本却比 dmb sy 低得多。
C++11 内存序到硬件指令的映射,最能看清模型差异的经济学:
memory_order_seq_cst的 store:x86 编译成mov + mfence(或xchg),ARM 编译成stlr前置dmb ish——x86 为堵 Store→Load 付了全价;memory_order_release的 store:x86 是普通mov(TSO 的 Store→Store 保序白送),ARM 是stlr——同一段 C++ 代码,x86 零成本,ARM 一条带序指令;memory_order_acquire的 load:x86 普通mov,ARM 是ldar。
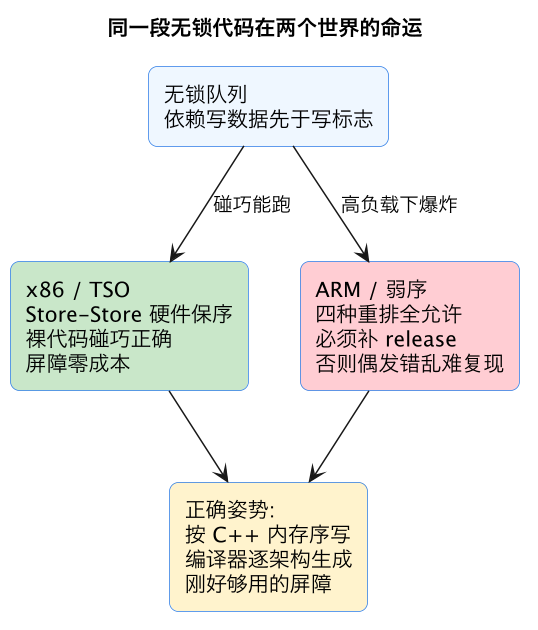
结论:写可移植并发代码,正确的姿势是按 C++ 内存序语义写(让编译器替你在每个架构上生成该架构刚好够用的屏障),而不是按「x86 上这样能跑」的经验写。x86 是最宽容的测试环境——在 x86 上对的弱序代码几乎什么都不能说明。
六、工程启示:模型差异在真实代码里的三个落点
把模型理论收回工程现场,差异集中在三处:
其一,无锁数据结构的移植。 x86 上依赖 TSO 隐式保序的无锁队列(比如省掉屏障的 SPSC 环形队列),搬到 ARM 必须补上 release/acquire,否则高负载下偶发数据错乱,且几乎无法稳定复现——litmus 级的错误要几十万次迭代才冒头一次。验证手段是 herd7 这类 litmus 测试工具:把内存模型公理化,直接在真实硬件上跑 SB/MP/LB 测试枚举所有合法结局。
其二,性能分析时识别 fence 开销。 x86 上 mfence/lock 指令要刷空 store buffer,在高频写的热点路径上是实打实的停顿——perf 里表现为原子指令处 CPI 尖峰。优化的方向不是删掉屏障(那会错),而是换数据结构:减少对共享变量的写频率、用 per-cpu 计数器聚合(思路同 data-layout-aos-soa 的局部性重构),让屏障出现的次数本身降下来。
其三,理解「为什么 x86 服务器在并发基准里常占便宜」。 TSO 比弱序模型白送了三种保序,大量历史并发代码的隐性假设在 x86 上免费成立;弱序架构要显式屏障补齐,多花的指令和停顿就是模型税。这不是微架构强弱,是契约松紧。
这一篇在知识体系里的位置
本篇是微架构专题里「多核可见性契约」这一层,向上承接硬件结构、向下支撑并发编程语义:
- store-buffer-write-combining:TSO 放开的 Store→Load 重排的物理来源,本篇是它的契约层解读。
- store-to-load-forwarding:单核内兜住写后读正确性的机制,与多核可见性是一体两面。
- lsu 与 load-store-queue-disambiguation:x86 为 TSO 保序养的顺序检查硬件。
- mesi-protocol:coherence 层契约,本篇反复强调的「一致性模型建立在连贯性之上」指的就是它。
- memory-model-fences-arch 与 memory-model-orders:fence 指令细节与 C++ 内存序语义的完整展开。
- spectre-meltdown-transient-execution:推测执行与内存模型交互失控的著名事故。
总结
内存一致性模型是 ISA 与程序员之间关于「跨地址读写顺序」的停战契约:顺序一致性要求全局串行等价但判了 store buffer 死刑无人敢用;x86 的 TSO 只放开 Store→Load 一种重排(store buffer 的直接副产品),Store→Store 保序让消息传递天然安全,代价是 LSU 里昂贵的顺序检查硬件;ARM/RISC-V 弱序模型四种重排全放开、只保依赖链,换来能效优势但要求程序员用 dmb/ldar/stlr 显式补序——SB litmus 的 r0=r1=0 和 MP 测试里乱序到达的 flag 就是两份契约差异的可观测证据,而写出可移植并发代码的唯一正路是按 C++ acquire/release 语义写,让编译器在每个架构上生成刚好够用的屏障。