非临时访存:NT load/store 绕过 cache 的流式读写
在 写合并缓冲区:store buffer 如何攒批 里我们已经见过 non-temporal store 是怎么被 WC buffer 攒成整行事务的;在 写分配与写回策略 里看过普通写"先 RFO 读进缓存再改"的默认路径。这一篇把镜头拉远:非临时访存(non-temporal access)是一整个指令家族——load 和 store 两侧都有——它回答的是一个共同的工程问题:流式数据只碰一次,凭什么要进缓存?
本文要回答的问题
- 什么是非临时访存?x86 上有哪些指令,各自语义差在哪?
- NT store 为什么要求"顺序写满整行",写碎了代价多大?
- NT load 和
prefetchnta适合什么读取场景,为什么限制比 store 多? - 哪些场景是非临时访存的甜蜜点,哪些是反模式?
一、缓存的时间局部性假设,流式数据偏偏不满足
CPU 缓存体系赌的是时间局部性:刚访问过的数据很快会再访问。LRU 类替换策略(见 缓存替换策略)把"最近用过"的行留在缓存里,挤走"最久没用"的。
流式数据恰恰是这个假设的反例:视频编码的输出帧、几十 GB 的 memcpy、AI 推理里只读一次的权重张量——每个字节这辈子只被碰一次。让它走默认路径会发生两件坏事:
- 污染:一次性数据把 LLC 里真正热的行(代码、热点表、其他线程的工作集)挤出去,后面全是 miss。
- 放大:普通写要先做 RFO(Read For Ownership)把目标行读进缓存,写 64 GB 实际产生 64 GB 读 + 64 GB 写,带宽白白翻倍。
非临时访存就是硬件给的"我不赌局部性"声明:告诉缓存子系统这行数据不用留,该绕过绕过、该用最少占位用最少占位。
二、指令家族:store 侧成熟,load 侧挑剔
x86 的非临时访存指令可以列成一张表:
| 指令 | 方向 | 语义 | 目标内存要求 |
|---|---|---|---|
MOVNTDQ / MOVNTPS / MOVNTPD | store | 绕过缓存直写内存,弱序 | WB 内存即可,走 WC buffer 攒批 |
MOVNTI | store(通用寄存器) | 同上,标量版 | 同上 |
MOVNTDQA | load | 从 USWC 内存(如显存)做合并读 | 仅对 USWC 有效;WB 内存上不退化但也不走特殊路径 |
PREFETCHNTA | 预取 | 拉行进 L1,标记"用过即弃",不占/少占 LLC | WB 内存 |
CLDEMOTE(新平台) | 提示 | 把行从 L1/L2 降级到 LLC | WB 内存 |
要点有三个。第一,NT store 是主力,MOVNTDQ 在 WB(普通可回写)内存上就能用,语义是"绕过缓存、弱序、靠 WC buffer 攒批"——攒批机制的细节(槽位、字节掩码、部分行驱逐)在 写合并缓冲区 里讲过,这里不重复。第二,NT load(MOVNTDQA)是个"显存专用件",它只在 USWC 类型的内存上才有合并读效果;在普通 WB 内存上用它,多数微架构就当普通 load 处理,别指望它绕过缓存。第三,想让普通读"少污染",工具是 PREFETCHNTA:它把行拉进 L1 但打上"先淘汰"标记,替换时优先被逐出,LLC 层面尽量不留痕。
三、两条路径的对照:默认路径 vs NT 路径
用一张结构图把"写 64 字节"在两条路径上的流量差异画清楚:
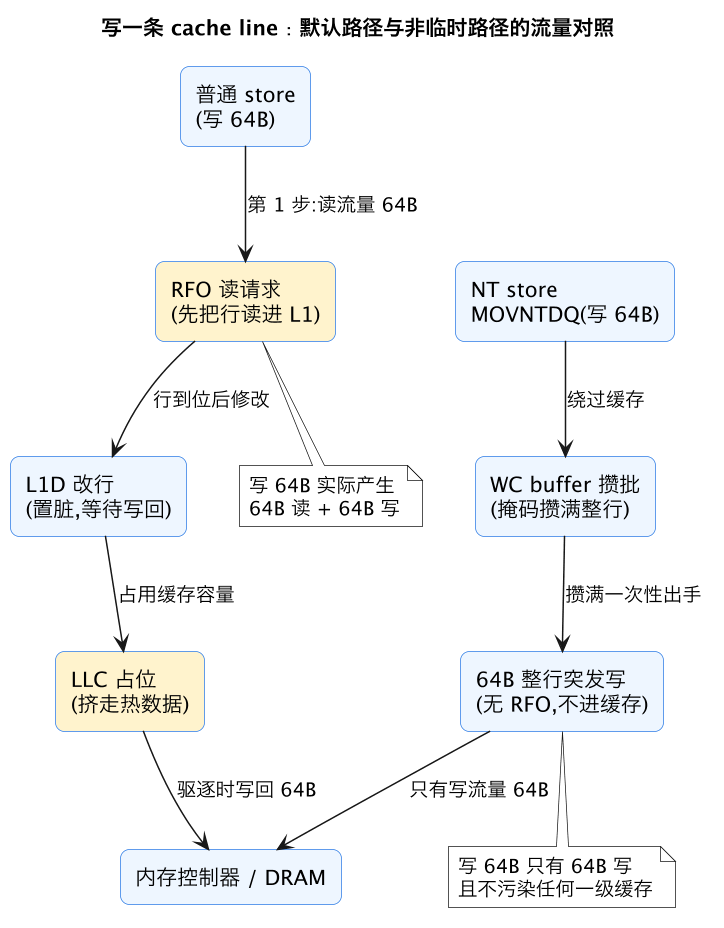
读这张图抓住两点。流量上,默认路径写一条行要先花一次读(RFO),总线事务是 NT 路径的两倍;大拷贝场景下这就是"省出一倍写带宽"的来源,实测大 memcpy 用 NT 版本常常快 30% 以上。缓存行为上,默认路径会在 L1/LLC 留下脏行,把别人的热数据挤走;NT 路径全程不留痕。流式写场景这两个红利叠加,收益是乘法不是加法。
四、写组合是硬约束:MOVNT 的"姿势要求"
NT store 的性能承诺不是白给的——它依赖写组合(write combining),合并失败时代价比普通写还惨。规则可以压缩成四条:
- 按 64 字节对齐、顺序写:循环里按行递增地址,每条 SIMD 写落在同一行内,攒满再进下一行。
- 活跃流条数别超 WC 槽数:现代核心十来个槽,稳妥口径同时写 ≤4 条流;8 路 strided 输出会频繁触发部分行驱逐,带宽腰斩。
- 写完同一行再干别的:写半行就跳走,槽被超时/压力驱逐,带空洞的掩码退化成小事务甚至读改写。
- 别忘了 SFENCE:NT store 弱序,消费者看到数据前,生产者必须
SFENCE保证槽已刷出;顺序语义的背景见 load/store 数据冒险。
还有一条容易踩的坑:NT store 与普通 store 别写同一条 cache line。同一行一部分走缓存、一部分走 WC 路径,行状态在两条路径间打架,合并直接失效,性能比普通写还差。混用场景(比如先 NT 写大块、再普通写修补头部几个字节)要么把修补也改成 NT,要么把边界对齐到整行。
读取侧的姿势简单得多:PREFETCHNTA 只管发,不保证时机,属于"发了不亏"的提示;真正有约束的是别对会被复用的数据用它——预取进来又被立刻驱逐,等于白发。
五、适用与反适用:甜蜜点很窄但很深
| 场景 | 该用吗 | 理由 |
|---|---|---|
| 大于 LLC 数倍的大 memcpy / memset | NT store,强烈推荐 | 省 RFO + 不污染,双赢 |
| 视频/编码输出帧、一次性写盘缓冲 | NT store | 写后短期不读,典型流式 |
| 扫一遍不再碰的大表(分析型查询) | PREFETCHNTA 可选 | 保护 LLC 里的其他热数据 |
| 从显存/USWC 区域读(如零拷贝采集) | MOVNTDQA | 这是它唯一的主场 |
| 小于 LLC 的工作集 | 别用 | 进缓存复用才是正道,NT 反而每次 miss |
| 随机/稀疏写 | 别用 | 合并不起来,比普通写更慢 |
| 写后马上读(边写边校验) | 别用 | NT 写完不在缓存,读回来全是内存往返 |
| 多线程细粒度共享 | 别用 | 弱序 + 无缓存一致性红利,正确性和性能双输 |
给一个具体的工程例子:某内存数据库做全表 compaction,输出 40 GB 新段文件,LLC 只有 60 MB。普通写版本里,RFO 读流量把有效带宽砍掉一半,compaction 结束后线上查询的 LLC 命中率暴跌、尾延迟毛刺持续十几秒——因为缓存全被写目标冲掉了。切到 MOVNTDQ 版本后,compaction 吞吐提升约 35%,更关键的是查询延迟全程无感:缓存里一行都没被挤走。这是典型的"两个答案都是是"的场景。
判断口诀一句话:数据量是否显著大于 LLC,且每个字节是否只碰一次。两个都答"是",非临时访存大概率赚;任何一个答"否",老老实实走默认路径。想实测验证,可以用 perf stat 对比 NT 版与普通版的 DRAM 读写流量与 LLC miss 计数——方法和计数器解读同样见 写合并缓冲区 的观测一节。
这一篇在知识体系里的位置
本篇是微架构长尾层,向上承接 LSU:load/store 单元 的访存路径全景,与 写合并缓冲区(NT store 的攒批机制细节)、写分配与写回策略(默认写路径的对照)互为姊妹篇;缓存侧的背景是 缓存替换策略 与 硬件预取器(流式读的另一个优化维度)。
总结
非临时访存是给"只碰一次的流式数据"开的旁路:NT store(MOVNTDQ)绕过缓存、靠 WC buffer 攒成整行写,省掉 RFO 读流量又不污染 LLC,大拷贝能多出三成以上带宽;PREFETCHNTA 让流式读用过即弃,MOVNTDQA 则是显存合并读的专用件——但它有硬姿势:顺序、对齐、写满整行、流别太多、刷出靠 SFENCE,数据量小于 LLC 或会被复用时,用它只会更慢。