投机唤醒调度:发射队列如何赌依赖延迟、猜错了付出多少 replay 代价
更新时间:2026-10-05。乱序执行的核心引擎是发射队列(Issue Queue,IQ),它每个周期做两件事:唤醒(wakeup)——广播「谁的源操作数已经算出来了」,选择(select)——从就绪的项里挑一个送上执行端口。这套循环的基本原理在 发射队列的唤醒与选择 里讲过,但那里有一个被轻轻带过的关键假设:操作数「算出来」的时刻是确定的。现实不是这样——load 的延迟取决于命中 L1 还是 L2 还是内存,跨越 4 个到 200 多个周期。如果调度器等到 load 数据真正回来才唤醒它的消费者,依赖链上每条 load 都要白白多等好几个周期。现代高性能核的选择是投机唤醒调度:不等结果确认,赌一个最可能的延迟(通常是 L1 命中的 4 到 5 周期)就提前把消费者排上发射日程。赌对了,load 和消费者背靠背执行;赌错了,消费者发射时操作数还没就绪,只能把它抓回来重发,这就是 replay。本篇把投机唤醒调度的机理、replay 的代价模型、以及它背后的调度器面积与时序取舍讲透。流水线整体的背景见 CPU 微架构总览,load 猜错后与内存序违规纠缠的重放在 load replay 与流水线恢复 里讨论,本篇聚焦调度器内部的那一面。
本文要回答的问题
- 为什么发射队列不能等操作数真正就绪再唤醒依赖者?「确定唤醒」慢在哪里?
- 投机唤醒调度具体怎么赌?赌的标的是什么?
- 猜错了会发生什么——replay 重发的机制与代价有多大?
- 哪些微指令适合投机唤醒,哪些必须等确定结果?调度器怎么区分?
- 投机唤醒与调度器面积、频率目标之间是什么关系?各家核怎么取舍?
一、确定唤醒为什么不够快:背靠背发射的时序死结
先看不调度的理想世界:一条 add rax, rbx 后面紧跟 add rcx, rax,第二条依赖第一条的结果。在乱序核里,第一条被选中送上 ALU 端口,1 个周期后结果出现在旁路网(bypass network)上,第二条可以在紧挨着的下一个周期发射,直接从旁路网抄走结果而不必等它写回物理寄存器堆(读寄存器堆的机制见 物理寄存器堆读)。两条指令「背靠背」执行,关键路径上每拍只花 1 个周期——这是 IPC 能大于 1 的根基。
要做到背靠背,调度器的动作必须这样排:第 N 周期选中第一条 add,同一个第 N 周期就得把「rax 将在第 N+1 周期可用」的消息广播给发射队列里所有等 rax 的项,第二条 add 的唤醒逻辑在第 N+1 周期开头的 select 仲裁里已经算「就绪」,于是第 N+1 周期它被选中发射。也就是说,唤醒广播和选择仲裁是串在同一个周期里的组合逻辑:先比中 producer 的目的寄存器号、置起消费者的就绪位、再从所有就绪位里仲裁出一个胜者、最后把胜者推出队列——这一长串逻辑必须在一个时钟周期内收敛。
ALU 的 1 周期延迟恰好卡在这个时序预算里,所以 ALU 依赖链的「唤醒」天然是投机的:广播发生时结果根本还没算出来,调度器是假设它 1 周期后必然算出来。这个假设对定点 ALU 永远成立(延迟固定),所以没人觉得它「投机」。但一旦 producer 是 load,情况就变了。
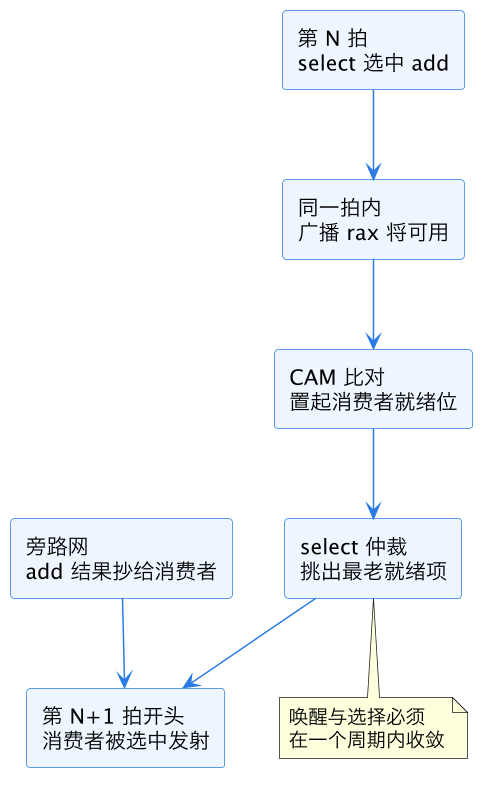
上图把一拍之内塞下的整条组合逻辑摊开看:选中 producer 的同一拍要完成广播、CAM 比对、就绪位置位、select 仲裁四步,消费者才能在下一拍开头准时发射,并从旁路网而不是寄存器堆拿到刚出炉的结果。这条链就是调度器的时序关键路径,后面谈面积取舍时还会回到它。
二、投机唤醒调度的对象:load 延迟是个概率分布
load 的有效延迟不是一个数,而是一条分布:命中 L1D 大约 4 到 5 周期,命中 L2 十几周期,L3 几十周期,内存 200 周期以上,TLB miss 再加页表行走。而且命不命中在调度时刻不可知——地址可能还没算出来,算出来了 cache 有没有这行也不知道。
如果调度器采取「确定唤醒」策略——等 load 真的从数据缓存返回、确认命中之后才广播唤醒——依赖 load 的消费者要在数据到达之后才开始走唤醒加选择的流程,等它发射又是下一拍,数据早到了却要空转好几个周期才能被旁路抄走。基准测试里 load 占动态指令的 25% 上下,且大量整数代码的关键路径就是 load 串 load(指针追逐)、load 接 ALU(载入即计算)。每条链多 3 到 4 个周期空转,IPC 直接掉一截。
所以自 Pentium Pro 之后的几乎所有高性能核都选择了同一个答案:对 load 的消费者做投机唤醒,一律按 L1 命中最小延迟排程。load 一发射,调度器立刻按「4 或 5 周期后数据可用」的假设给消费者排上日程;消费者在预定拍点被选中发射,操作数直接从 load 返回路径上旁路进来。赌对了,整条依赖链以 L1 延迟全速前进。
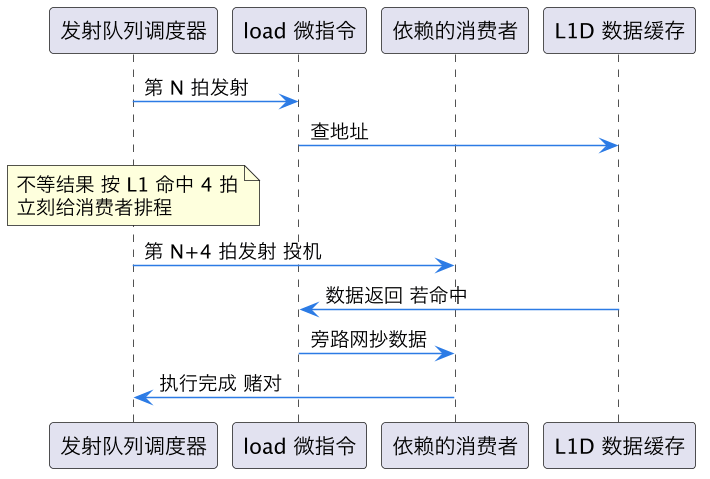
上图是赌对的路径:调度器的排程动作(N+4 拍发射消费者)发生在数据确认之前,消费者发射的同一拍数据恰好从旁路网到达,一拍不空转。注意这条序列里没有任何一次「等待确认」——这就是投机唤醒调度的本质:把确认环节从关键路径上摘掉,用概率换延迟。
三、猜错了怎么办:replay 重发机制
赌错的情形有两类。第一类是 cache miss:load 没命中 L1,第 N+4 拍数据根本不存在,但消费者已经按日程发射了,它在执行级读到的是无效数据(或一个「数据未就绪」标记)。第二类是消歧猜错:load 的地址与前面尚未执行完的 store 冲突(内存消歧,memory disambiguation),哪怕命中 L1 数据也是错的——这条线属于内存序恢复,本篇不展开,参见 load replay 与流水线恢复。
对 cache miss 型猜错,调度器的处理是 replay:执行级在数据应到而未到的那一拍发出「miss」信号,把已经投机发射的消费者(以及它身后已经按同样投机逻辑排程的二级、三级消费者)从流水线里抓回来,标记为「未就绪」,等 load 真的从下级缓存或内存返回后重新唤醒、重新发射。不同微架构的实现分两派:
- 重放队列(replay queue)派:Intel 从 Pentium 4(NetBurst)起把已发射但未确认的微指令留在调度器里一个循环队列中,不确认就不退役,猜错时原地重放。NetBurst 把这个机制推到极致——它按 L1 命中 2 周期的激进口径排程,猜错率很高,replay 成了常态流量。
- 选择性重发(re-issue)派:发射项在「确认完成」之前不释放发射队列的槽位,猜错时把该项的就绪位清掉,回到队列里参与下一轮唤醒选择。现代 Intel 大核与 AMD Zen 系列基本走这条路,调度器顺带承担重放缓冲的角色,省掉独立的 replay 队列面积。
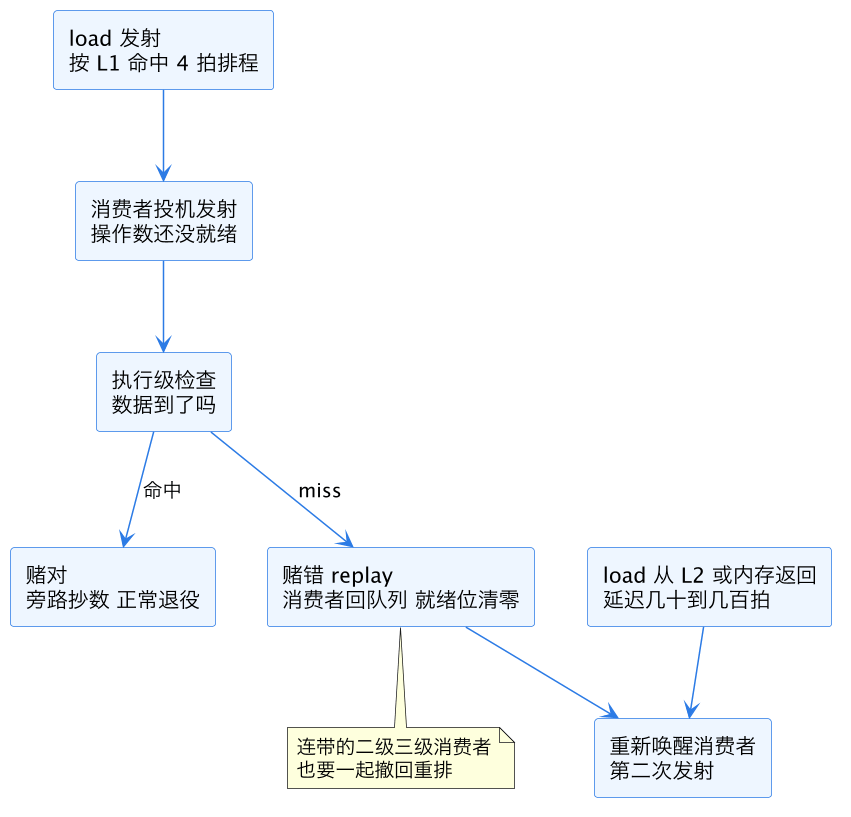
上图是 replay 的完整环路。要格外注意「连带撤回」:消费者 C1 依赖 load,C2 依赖 C1,调度器排程时 C2 是跟着 C1 的投机日程走的,C1 抓回来,C2 也得抓回来——一条猜错在依赖链上传染,链越长、撤回越多。这就是为什么指针追逐型代码(链表、树遍历,每一步都是 load 依赖上一步 load)对 L1 miss 极度敏感:每一次 miss 不只是多等内存延迟,还附带一整条链的调度撤回与重排。
四、replay 的真实代价:不只是晚几拍
replay 的成本可以拆成四笔账。
第一笔是延迟本身:白发射一次的消费者晚了一个 miss 处理时间才重新执行,这笔是显然的。第二笔是端口挤占:投机发射的那一拍,消费者占用了一条执行端口的时隙,这个时隙本可以给别的就绪微指令。在 4 到 6 端口的宽核上,高 replay 率意味着有效发射带宽被「幽灵发射」吃掉一块。第三笔是选择逻辑回滚:被撤回的消费者重新进入唤醒选择循环,与正常流量竞争 select 仲裁,调度器复杂度上升。第四笔是功耗:每次幽灵发射都是一次完整的前递、读操作数、执行级翻转,纯浪费的动态功耗。NetBurst 时代 replay 流量大时功耗账很难看,这也是后来设计收敛到「只对确定延迟的短操作投机」的原因之一。
| 代价项 | 表现 | 量级 |
|---|---|---|
| 重发延迟 | 消费者晚一个 miss 延迟再执行 | 十几到几百拍 |
| 端口挤占 | 幽灵发射占用执行时隙 | 高 replay 率时有效带宽缩窄 |
| 调度回滚 | 撤回项重新竞争 select | 队列压力与仲裁复杂度上升 |
| 动态功耗 | 白做的前递与执行翻转 | 与 replay 率成正比 |
哪些微指令值得投机唤醒,调度器是按「延迟确定性」分档的:定点 ALU(1 拍)永远投机,这是无风险赌注;load 按 L1 最小延迟投机,命中率通常 90% 以上,期望值划算;乘法、除法、浮点延迟固定但较长,走确定性排程即可;store 没有消费者数据依赖(消费者走 store-to-load forwarding 的消歧路径),不进这套账本。有些核还给 load 准备「慢速重放排程」——miss 过一次之后,同一条 load 再次被调度时按更保守的延迟排,避免在同一条链上反复猜错,这相当于一个单 bit 的延迟学习器。
五、面积与频率的取舍:为什么调度器是乱序核最贵的一块
把镜头拉远看设计哲学。发射队列的唤醒逻辑本质是一个内容可寻址存储器(CAM):每个等待项都要在每个周期拿自己等的源寄存器号和所有「本拍广播的目的寄存器号」比对,项数越多、每拍发射越宽,比较线是项数乘以宽度的规模;选择逻辑是从最多几十个就绪项里仲裁出最老的若干个,是个优先级编码大网。唤醒加选择串在一个周期内收敛,这条路径的延迟直接卡住核的频率上限——想上 5GHz、6GHz,这条链就不能做太深。
于是调度器规模成了频率与乱序窗口之间的零和:队列做大(更多在飞指令、更高 IPC 潜力),CAM 比较和 select 仲裁变慢,频率掉下来;频率拉高,队列只能做小,IPC 潜力受限。投机唤醒调度恰好踩在这个矛盾的正中央——它之所以能成立,恰恰因为 ALU 的 1 拍延迟与「唤醒加选择」的一拍预算严丝合缝,这是多年协同设计磨出来的均衡点;而 load 投机是把这个均衡向外推了一把,赌概率吃掉本不属于时序预算的确认环节。
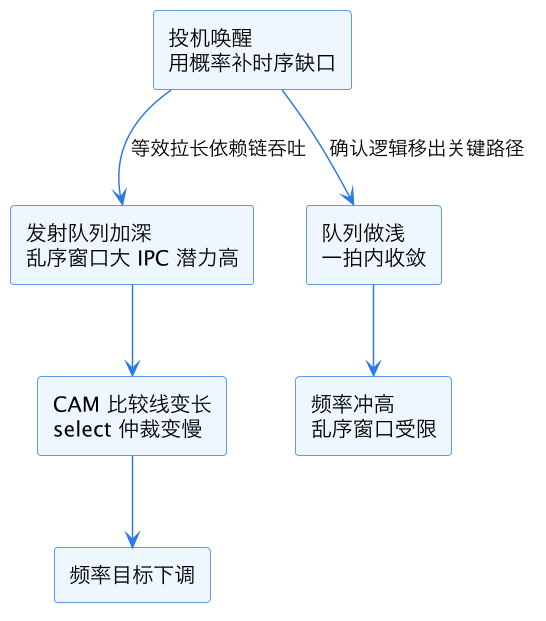
上图是这组取舍的张力图:左支是「加深队列换 IPC、牺牲频率」,右支是「做浅队列冲频率、牺牲窗口」,中间的投机唤醒是在两头都沾便宜的技巧——它既不加深队列,又让依赖链以接近确定性的速度推进,代价只是猜错时的 replay 流量。各家核的落点不同:追求极致频率的设计倾向小队列加激进投机(NetBurst 是极端样本,教训也最深);追求每瓦性能的设计倾向中等队列、保守投机加精细的 miss 后重排;苹果大核则走了「宽发射加超大调度窗口、频率中等」的另一极,用面积换 IPC 而非换频率。执行端口侧的竞争如何反过来限制这套调度的收益,见 执行端口争用。
六、可观测性:在 PMU 里看到 replay
replay 不是纯理论,它在性能计数器里有直接踪迹。Intel 平台上可以关注几组事件:LD_BLOCKS 系列统计各类 load 阻塞;部分代际提供调度器重放相关计数(如 Sandy Bridge 系的 UOPS_DISPATCHED_PORT 与退役微指令数的差值可以间接反映幽灵发射流量);更通用的做法是看「发射的微指令总数 vs 退役的微指令总数」的剪刀差——差值越大,被撤回重发的流量越多。AMD Zen 平台有对应的 dispatch 与 retire 计数。工程上的实用信号是:同一段代码在数据全驻 L1 和刻意打出 L2 的两个版本之间 IPC 的落差,减去纯内存延迟能解释的部分,剩下的就是 replay 与调度撤回的开销。计数器编程方法见 PMU 性能计数器编程。
对代码编写的启示也很直接:让关键依赖链上的 load 尽量命中 L1(数据局部性、预取、压缩指针),收益不只是省内存延迟,还包括整条链免遭 replay 撤回;把长指针追逐链改平(数组化、池化),是在帮调度器减少投机赌注的连锁敞口。
这一篇在知识体系里的位置
本篇是微架构模块「乱序执行引擎线」的调度篇。基础机制的上游是 发射队列的唤醒与选择,数据通路背景见 物理寄存器堆读。猜错后的两条恢复路径分属两篇邻居:内存消歧型重放在 load replay 与流水线恢复,分支猜错的重命名状态回滚在 重命名检查点与分支恢复。端口侧约束见 执行端口争用,观测手段见 PMU 性能计数器编程。全景地图见 CPU 微架构总览。
总结
投机唤醒调度是乱序核对「load 延迟不可知」这个现实的一次下注:发射队列不等数据确认,一律按 L1 命中的最小延迟给消费者排程,赌对了依赖链背靠背全速推进、把确认环节彻底移出「唤醒加选择一拍收敛」的时序死结,赌错了就把已发射的消费者连同它身后的依赖链一起撤回,付出重发延迟、端口挤占、调度回滚与动态功耗四笔 replay 成本。这套机制之所以成为所有高性能核的共同选择,是因为调度器的 CAM 唤醒与选择天然是频率与窗口的零和,投机唤醒恰好用概率补上了时序缺口;对软件层的启示则很朴素——让关键链上的 load 命中 L1、把指针追逐链改平,省的不只是内存延迟,还有整条依赖链的撤回重排。