搬移消除与零惯用:重命名阶段就把 mov 和 xor 清零"消化"掉,执行端口一拍不占
在 寄存器重命名 里我们说过:重命名的本质是一张逻辑寄存器到物理寄存器的映射表。这张表除了消除假依赖,还能干一件更"鸡贼"的事——把某些指令整个吃掉。
mov rax, rbx不用真的搬数据,改一下映射表里 rax 的条目就行;xor eax, eax不用真的做异或,直接把 rax 映射到一个"恒为零"的物理寄存器就行。这两招分别叫搬移消除(move elimination)与零惯用(zero idiom)识别,它们就是本篇的主角:搬移消除与零惯用。
本文要回答的问题
- 搬移消除与零惯用分别"吃掉"哪些指令,原理是什么?
- 被消除的指令是不是真的什么都不占?ROB 里还有它们的位置吗?
- 哪些写法能被消除、哪些会"翻车"退回普通执行?
- 这两招对 IPC 分析和手写汇编优化有什么实际影响?
一、问题背景:寄存器 mov 和清零有多频繁
真实编译产物里,mov reg, reg 密度高得惊人。调用约定要求参数放在固定寄存器(rdi、rsi、rdx……),函数开头往往先 mov r10, rdi 把参数挪到别处腾位置;中间表达式求值、寄存器分配器 spill/reload 的边缘、循环变量的拷贝,都会产出大量寄存器间搬移。清零也一样:返回值 xor eax, eax、计数器初始化、清空标志位,xor reg, reg 是编译器最爱的清零写法(比 mov reg, 0 编码短,还不留假依赖——因为目的寄存器的内容是自己读自己改写,旧值被读了一次,但重命名照样给它分配新物理寄存器)。
如果每条 mov、每条 xor 清零都老老实实走"分配物理寄存器 → 进发射队列 → 占一个 ALU 端口执行一拍 → 写回"的全流程,这些"语义上是空气"的指令会白白消耗执行资源。一个 6 发射核心碰上 20% 的 mov 流量,等于有五分之一的发射带宽在搬纸箱子。搬移消除与零惯用的思路就是:这类指令的结果在重命名那一刻就能算出来,何必劳烦执行单元?
二、原理:重命名阶段的两种"吸收"操作
先回忆重命名的核心数据结构:一张 RAT(Register Alias Table,重命名映射表),记录每个架构寄存器当前对应哪个物理寄存器。一条普通指令进重命名级,硬件做三件事——查表拿到源操作数的物理编号、给目的寄存器分配一个新物理寄存器并改表、把 µop 塞进 ROB 和发射队列。
搬移消除与零惯用改写的正是中间那一步:
搬移消除(move elimination):遇到 mov dst, src,不分配新物理寄存器,直接把 RAT 里 dst 的条目指向 src 当前映射的那个物理寄存器。数据根本不用搬——dst 和 src 从此共享同一个物理寄存器。src 以后再被改写也没关系,因为 src 的改写会分配新物理寄存器,共享只发生在"此刻"。
零惯用(zero idiom)识别:遇到 xor dst, dst、sub dst, dst、pxor xmm, xmm 这类"自己跟自己运算、结果恒为零"的写法,硬件认识这个模式,直接把 dst 映射到一个专门的零寄存器——一个硬连线为 0、所有 µop 都可以共享的物理寄存器。同样不分配新寄存器、不做运算。ARM64 架构层面就有 WZR/XZR 零寄存器,x86 是在微架构层面自己造了一个出来。
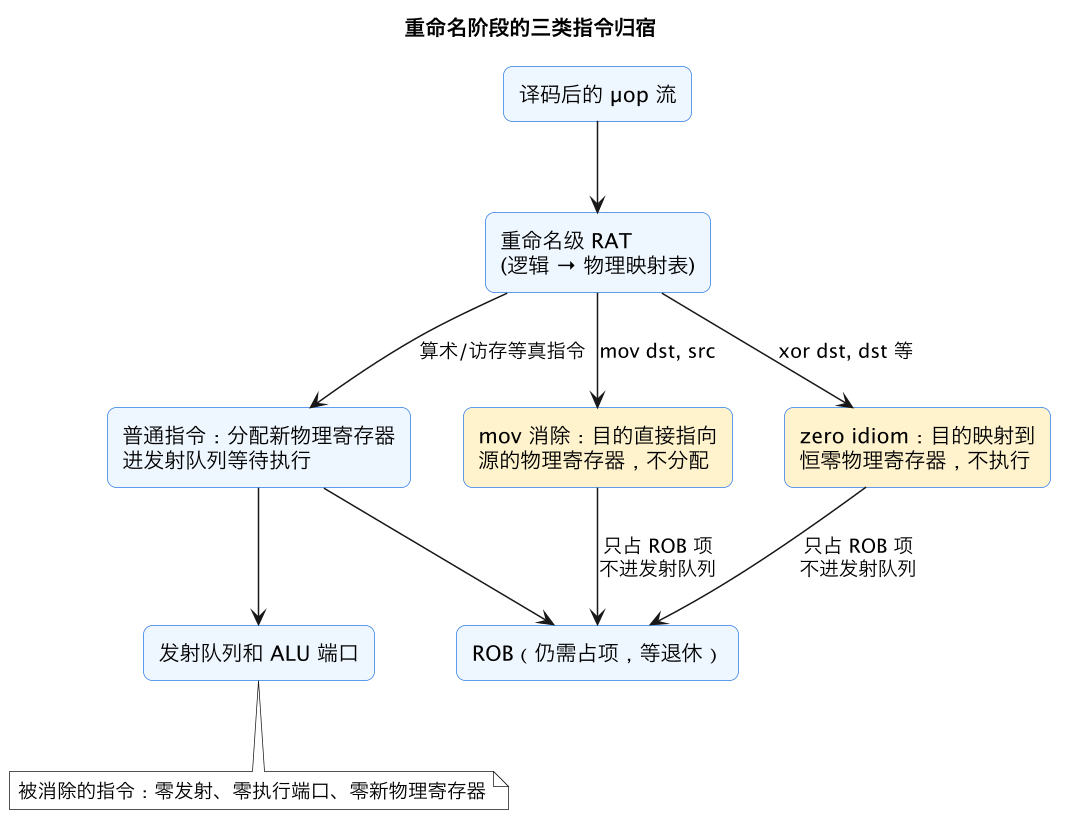
这张图的要点在三条出边:普通指令走全链路;被消除的 mov 和 zero idiom 绕过发射队列和执行端口,只留一个 ROB 项用于按序退休和精确异常(万一前面有指令触发异常,处理器得能说清楚"这条 mov 之前的机器状态",所以 ROB 记账不能省)。这就是"不占执行端口"的准确含义——它们消耗的资源只剩 ROB 的一项和重命名级的一个槽位。
三、代价与收益:省下来的都是硬通货
被消除的指令到底省了多少?对照一下全链路开销:
| 资源 | 普通执行 | 搬移消除 / 零惯用 |
|---|---|---|
| 新物理寄存器 | 分配 1 个 | 不分配 |
| 发射队列项 | 占 1 项 | 不占 |
| 执行端口 | 占 1 拍 ALU | 不占 |
| 旁路网 | 结果上总线广播 | 无结果可广播 |
| ROB 项 | 占 1 项 | 仍占 1 项 |
| 重命名带宽 | 占 1 槽 | 仍占 1 槽 |
| 退休延迟 | 取决于执行完成 | 重命名完即"完成",可立即退休 |
收益立竿见影:mov 的"延迟"从 ALU 的一拍变成零拍——消费者指令的源操作数在重命名后直接指向同一个物理寄存器,连旁路前推都不用等(前推机制见 RAW 与前推旁路)。Intel 从 Ivy Bridge 开始做寄存器 mov 消除,AMD Zen 系列也支持;zero idiom 识别更早,Pentium M 时代就有了。现代核心(Golden Cove、Zen 4/5)每拍能消除 4~6 条这类指令,等于重命名级免费多"吞"了几条指令的吞吐。
四、哪些写法能消除,哪些会翻车
不是所有长得像的写法都能被消除,边界值得记:
能消除的典型写法:mov r64, r64(寄存器对寄存器,同宽度);xor reg, reg / sub reg, reg / pxor xmm, xmm / vpxor 等 SSE/AVX 清零;sbb reg, reg 在部分核心上也被认作零/负一惯用。ARM 侧的 mov x0, xzr 之类更直接。
会翻车退回普通执行的情况:
- 部分寄存器写:
mov ax, bx这种 16 位写要保留高 48 位旧值,本质是合并操作,没法简单改映射,只能老老实实执行(部分核心对 32 位写 64 位寄存器的高 32 位清零语义有优化)。 - 跨簇搬移:部分设计里整数和向量是不同的物理寄存器堆(见 物理寄存器堆),
vmovq这类跨域搬移无表可改,只能走执行端口。 - 消除失败回退:Intel 部分代际的 mov 消除不是承诺式的——如果依赖的物理寄存器退休时机不合适,消除会在后端"失败",µop 重新进发射队列补执行,反而多付一点延迟。实测里 mov 消除率大约 70~90%,不是 100%。
还有一个有意思的细节:xor eax, eax 除了清零,硬件还顺手把它标记为"无依赖指令"——它不等任何输入,在 乱序执行机制 里属于"出生即就绪"的 µop,不会卡在发射队列的唤醒逻辑上。
五、对性能分析的启示
第一,看 IPC 时要给消除指令"打折"。perf 数到的指令数包含被消除的 mov 和 xor,它们不占执行端口,所以 IPC 超过核心标称执行宽度并不奇怪——比如 6 发射核心跑出 IPC 6.5,多出来的往往是被消除的指令在 ROB 里按拍退休。分析 IPC 瓶颈拆解 时,执行端口压力和指令吞吐要分开看。
第二,手写汇编别自作聪明。有人为了"省指令"用 lea 代替 mov 加法链,或者担心 mov 太多而手工重排——在支持搬移消除的核心上,寄存器 mov 基本是免费的,编译器生成多少都无所谓,优化重点应该放在真依赖链长度和访存上。反过来说,清零一律用 xor reg, reg 而不是 mov reg, 0:前者触发 zero idiom,后者是带立即数的普通 mov,虽然也能被消除(目的改映射、零值由立即数直接喂给映射),但在不支持该优化的旧核心上两者待遇不同,xor 写法永远稳赢。
第三,前端成了新瓶颈。消除把执行端口的压力挪走了,瓶颈前移到译码和重命名带宽——每拍能消除几条,取决于重命名级每拍能处理几条 µop。这也是 µop 缓存与译码前端 里强调 DSB(µop cache)命中率的原因之一:喂得越宽,消除的红利吃得越足。
这一篇在知识体系里的位置
本篇是微架构长尾层,向上承接 寄存器重命名(映射表机制)与 乱序重命名与退休(ROB 与按序退休),向旁连接 RAW 与前推旁路(正常指令的依赖传递,与被消除指令的零延迟形成对照)、物理寄存器堆(不分配新物理寄存器省下的正是它的压力)与 IPC 瓶颈拆解(消除指令对实测 IPC 的稀释效应)。
总结
搬移消除与零惯用是重命名级的"伪指令消失术":寄存器间 mov 直接改映射表让目的共享源的物理寄存器,xor reg, reg 这类清零写法则把目的映射到恒零寄存器——两者都不分配新物理寄存器、不进发射队列、不占执行端口,只在 ROB 里留个退休记账的位置;理解它们,才能解释为什么 IPC 能超过执行宽度,也才知道哪些 mov 值得操心、哪些纯属免费。