DRAM 控制器调度:FR-FCFS 怎么在几十纳秒里决定先服务谁
承 data-hazards-l1-miss——那一篇追到末级缓存未命中就打住了:请求被交给内存控制器,然后呢?然后才是 DRAM 世界里最精彩的一段。内存控制器手里攥着几十上百个排队请求,而 DRAM 颗粒的动作慢得惊人(一次行激活几十纳秒,折合 CPU 上百拍),先服务谁、后服务谁,顺序差一点,带宽就差一倍。决定这个顺序的就是 DRAM 控制器调度,而工业界事实标准是 FR-FCFS(First-Ready First-Come-First-Serve,就绪优先的先来先服务)。本文把它从策略、代价到公平性讲透。DRAM bank 层面的并行性背景见 cache-banking-bank-conflict,本篇聚焦请求队列里的排序问题。
本文要回答的问题
- 为什么 DRAM 控制器敢"乱序"执行访存请求,CPU 却对此一无所知?
- 行缓冲命中、行缺失、行冲突三种请求状态,代价差多少?
- FR-FCFS 的两层排序规则具体怎么工作,为什么"行命中优先"能榨出带宽?
- 读写切换为什么贵,控制器怎么处理"写什么时候发出去"?
- FR-FCFS 的饥饿问题有多严重,多核争抢下公平性怎么补救?
一、DRAM 为什么需要调度:慢、贵、还有状态
先建立量级感。一次 L1 命中约 1 纳秒,L3 命中约 10 纳秒,而一次 DRAM 访问要 50~100 纳秒——更要命的是这 50~100 纳秒不是均匀花的,它取决于你要访问的行当前是什么状态。
DRAM 颗粒内部按 bank(存储体)组织,每个 bank 有一个行缓冲(row buffer),相当于一小条 SRAM 暂存整行数据。访问一个地址分三种情况:
- 行缓冲命中(row hit):目标行正好在行缓冲里,直接读写列,最快,约 tCL 量级(15 纳秒上下)。
- 行缺失/行关闭(row miss):bank 空闲,先激活目标行(ACTIVATE,tRCD 约 15 纳秒),再读写,总代价翻倍。
- 行冲突(row conflict):行缓冲里是另一行,得先预充电关掉旧行(PRECHARGE,tRP 约 15 纳秒),再激活新行,再读写——三段串联,最贵,接近 45 纳秒起步。
同一个请求,是命中还是冲突,完全取决于它前面执行了谁。顺序从"按到达先后"换成"把打同一行的请求凑一起",平均延迟立刻砍半、带宽接近翻倍。这就是调度的全部动机:DRAM 控制器是处理器里少数"重排就是性能"的部件。
它敢重排,是因为访存请求之间绝大多数没有依赖——CPU 那侧的内存序保证由缓存一致性协议和 load/store 队列(见 load-store-queue-disambiguation)在上游维护好,到了控制器这一层,请求就是一堆带着地址和年龄的独立任务,只要不违反 DRAM 自身的时序约束(tRCD、tRP、tFAW 那一大家子参数),怎么排都行。
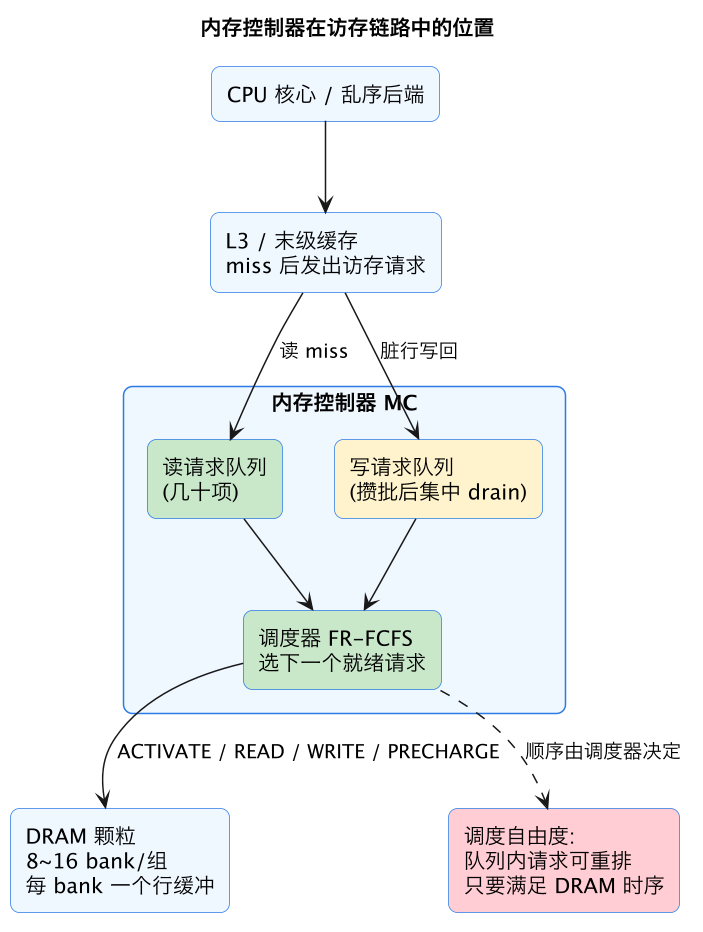
这张图的关键是中间那个调度器:它面前是两个队列,背后是一个"有状态且状态很贵"的 DRAM。它每拍要做的决定只有一件——下一个命令发给哪个 bank、是激活还是读写——但这个决定累积起来就是内存子系统的有效带宽。
二、三种请求状态的代价拆解
把三种状态摆在一起对比,调度的收益就一目了然:
| 请求状态 | 需要的命令序列 | 典型延迟 | 相对代价 |
|---|---|---|---|
| 行缓冲命中 | READ/WRITE(列命令) | ~tCL ≈ 13~15 ns | 1x |
| 行关闭(bank 空闲) | ACTIVATE + READ/WRITE | ~tRCD + tCL ≈ 28~30 ns | 2x |
| 行冲突 | PRECHARGE + ACTIVATE + READ/WRITE | ~tRP + tRCD + tCL ≈ 42~45 ns | 3x |
注意这张表里还有个隐藏维度:延迟之外,命令还占用命令总线和 bank 本身。一个行冲突请求要发 3 条命令,每条命令都占命令/地址总线若干拍,还独占这个 bank 几十纳秒——期间这个 bank 对其他请求完全不可服务。所以行冲突不只让自己慢,还把"银行柜台"锁住了。调度器把行命中请求优先放行,本质是让每条命令的"吞吐单价"最高:一条 READ 命令就换 64 字节数据,而不是三条命令才换一次。
还有一个bank 间并行的维度:不同 bank 可以同时工作(一个 bank 在激活,另一个在传数据)。好的调度器会把请求摊开打到不同 bank 上,让 tRCD/tRP 这些"准备时间"被其他 bank 的数据传输掩盖掉。地址到 bank 的映射(地址哪些比特决定 bank 号)直接决定了常见访存模式能不能摊开,这也是为什么现代控制器用哈希化的地址映射打散连续地址,细节见 cache-banking-bank-conflict。
三、FR-FCFS 的两层规则
FR-FCFS 的名字本身就是算法:First-Ready(就绪优先)+ FCFS(就绪者中先来先服务)。所谓"就绪",主流实现里核心含义就是行缓冲命中——不用激活、不用预充、当下就能发列命令的请求。完整的选择优先级大致是:
- 行命中的请求优先,其中按到达时间老的先走(FCFS 兜底);
- 没有行命中的,选能让 bank 尽快就绪的请求(比如给已关闭 bank 发 ACTIVATE),仍按年龄排;
- 一切平手时,最老的请求赢——FCFS 是饥饿的最后防线。
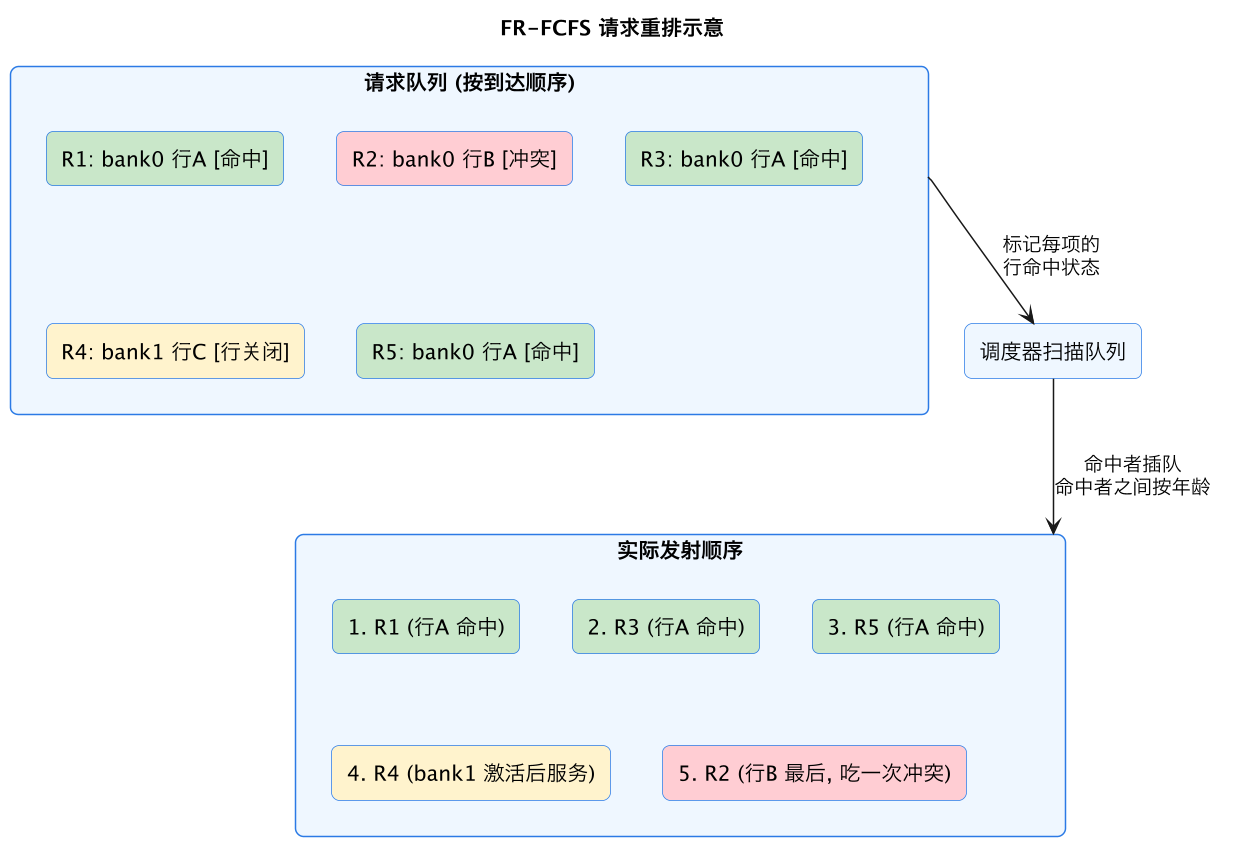
这张示意图里,R3 和 R5 明明比 R2 后到,却因为打在同一行 A 上被提到前面——三个命中请求连续发射,三条列命令换来 192 字节数据,bank0 的行 A 全程不关。等到没有命中可用了,才轮到 R4(bank1 本来就在另一行上,激活和 bank0 的传输并行,几乎免费)和 R2(最惨:它要求把行 A 关掉换行 B,是全场唯一的冲突,被压到最后)。严格按到达顺序要 2 次激活加 1 次预充;重排后只剩 1 次激活加 1 次预充,省下的都是几十纳秒级的真金白银。
FR-FCFS 之所以成为默认答案而不是某种更花哨的算法,一是它只需要给每个队列项加一比特"是否命中当前行"的比较逻辑,硬件便宜;二是它在真实负载(行局部性普遍不错,程序访存总有空间和流的聚集)下能拿到理论带宽的 90% 上下。这和一个老话题呼应:cache-friendly-code 里讲的"按行连续扫内存"在 DRAM 层面又一次被奖励——局部性好,行命中就多,调度器就偏爱你。
四、读写分组与总线翻转
请求除了"命中/冲突",还有第二个正交维度:读还是写。DRAM 的数据总线是双向的,读转写、写转读之间要插入空闲拍(总线翻转时间,tWTR/tRTW 等),一次翻转浪费 5~15 纳秒。如果读写请求严格交替,带宽会被翻转吃掉一大块。
工业界的通用解法是读写分组(read/write batching):控制器优先把读请求服务掉(读在关键路径上,CPU 正干等着数据),写请求在写队列里攒着;等写队列水位超过阈值,或者读队列空了,就触发一次"写 drain"——集中把一批写连续打出去,然后切回读模式。这样总线翻转次数从"每对相邻读写一次"降到"每批一次"。
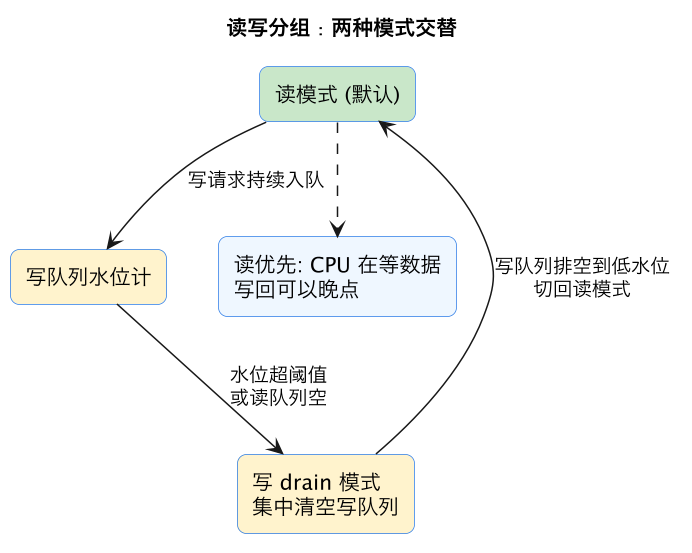
这个机制解释了 perf 里一个常见现象:写密集型负载的内存带宽曲线呈锯齿状——读服务段和写 drain 段交替出现。写队列满而读又多时,控制器被迫频繁 drain,翻转开销回升,有效带宽下滑,这就是"读写混合流量比纯读纯写都难跑满"的根因之一。
五、饥饿与公平性:FR-FCFS 的阴暗面
"行命中优先"在单线程世界里是纯赚,但多核多线程共享一个控制器时,它有个著名的副作用:行局部性差的线程会被行局部性好的线程饿死。
设想两个线程:线程 X 顺序扫一个大数组,请求哗哗地全是行命中;线程 Y 做指针追逐,每次访问都跳行、全是冲突。FR-FCFS 眼里 X 的请求永远比 Y 的"更值得服务",于是 X 的请求不停插队,Y 的请求在队尾越等越老。学术界的经典实验(Moscibroda 和 Mutlu 的 STFM/ATLAS 那支工作)表明,某些混合负载下差的线程减速可达数倍——不是因为它本身慢,而是调度器系统性地歧视它。这也是"拒绝服务型"性能攻击的理论基础:一个恶意线程可以靠疯狂制造行命中请求挤占内存调度资源,把同机其他租户的访存拖垮。
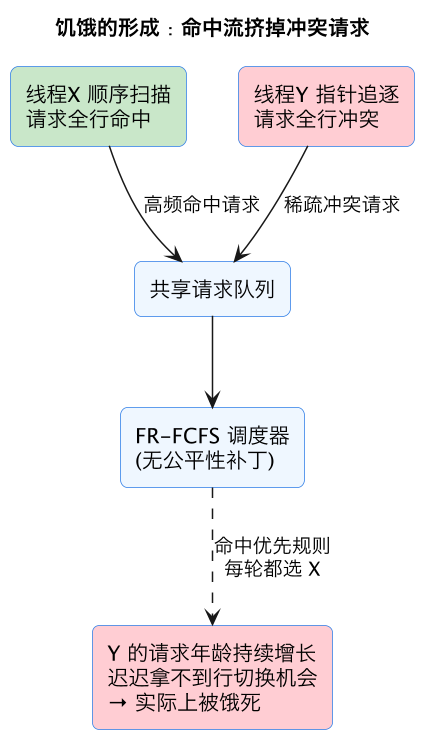
补救思路都围绕"给 FCFS 的兜底加牙齿":
- 年龄上限/请求截止期:等得太久的请求强制升格为最高优先,行命中规则让路。简单有效,但阈值定高了等于没装,定低了伤吞吐。
- 按线程配额/黑名单(如 PAR-BS、STFM 系):给每个线程分批服务,批内仍然 FR-FCFS,批间轮转,吞吐损失控制在个位数百分比。
- 感知减速的调度(ATLAS、TCM 系):控制器观测各线程近期从内存拿到的服务量,优先补给被拖慢最多的线程,把"公平"从按请求数改成按减速程度度量。
商用服务器控制器(Intel/AMD 近几代)实际落地的是这些思想的简化混血:在 FR-FCFS 骨架上加 starvation counter 和 QoS 等级。对性能工程师来说,结论是反直觉的一条:多租户/多实例混部时,P99 访存延迟毛刺不一定是缓存争抢,还可能是内存控制器调度层面的公平性失效——画像特征是某个实例带宽正常但延迟抖动大,且与邻居实例的访存模式强相关。NUMA 场景下这个问题还会被跨节点流量放大,配合 numa 的本地性策略一起看更完整。
六、对程序和调优的实际启示
DRAM 控制器调度是硬件行为,软件改不了策略本身,但可以顺着它的偏好写代码、读指标:
- 访存尽量成流、成行:顺序遍历、结构体数组(SoA)、大粒度连续读写,都在给调度器制造行命中,等效于给自己开了优先通道。随机指针追逐不仅 cache miss 多,到了 DRAM 还要吃行冲突加排队歧视,三重惩罚。
- 读写在时间上分开:能攒批刷脏数据就别读写交替着来,降低总线翻转次数;写密集阶段尽量让写是纯顺序的,drain 时命中率高。
- 观测层面:
perf stat看不到控制器内部,但 Intel 的 uncore IMC 事件(如uncore_imc/cas_count_read/、uncore_imc/clockticks/)能算出每通道实际带宽与利用率;带宽利用率 60% 以上延迟就开始非线性爬升,这个拐点位置和调度效率直接相关。 - 排查混部干扰时,把"邻居是不是在行命中轰炸"纳入怀疑清单:受害者带宽分不到、延迟暴涨,而加害者一切正常。
顺便一提,这个"重排排队请求以服务有状态的慢设备"的范式并不孤独:存储栈的 I/O 调度器(电梯算法)和它在精神上完全同构,只是一个面向磁头位置、一个面向行缓冲状态。
这一篇在知识体系里的位置
本篇是微架构篇里"访存出了末级缓存之后"这一段的开篇专题,上下游衔接如下:
- 上游:data-hazards-l1-miss 追到 L1 miss 的请求之旅;load-store-queue-disambiguation 交代 CPU 侧的访存排序保证,正是它让控制器可以放手重排;cpu-out-of-order 提供乱序后端持续产生并发 miss 的背景。
- 平行:cache-banking-bank-conflict 讲 bank 并行与地址映射;cache-friendly-code 的局部性原则在 DRAM 行缓冲层面再次兑现。
- 下游:numa 把单控制器的调度问题放大到多节点;内存带宽与延迟的测量方法见 tools/ 下的观测工具篇目。
总结
DRAM 控制器调度解决的是"一堆排队访存请求按什么顺序发给慢且有状态的 DRAM":FR-FCFS 用"行缓冲命中优先、同龄先到先服务"两层规则把请求重排成行命中的长串,一次激活服务一整行,带宽和延迟都远好于朴素 FCFS;再叠加读写分组省掉总线翻转,拿到主流负载下九成上下的有效带宽。代价是公平性——行局部性差的线程会被系统性饿死,于是商用控制器在 FR-FCFS 骨架上加年龄上限和 QoS 兜底;对软件而言,结论很朴素:访存越成流成行,调度器越偏爱你。