感知器分支预测器:权重表结构、训练规则与相比 TAGE 的可解释性和硬件代价
更新时间:2026-10-04。现代 CPU 的方向分支预测器基本是 TAGE 一家的天下:一堆带几何级数历史长度的标记表层层兜底,命中就用最长历史那层的计数器拍板,这套机制的来龙去脉见 TAGE 分支预测器。但学术界一直活着另一条路线:把分支预测当成一个机器学习分类问题,用感知器(perceptron,最简单的单神经元线性分类器)来做。它没有标记、没有层级、没有兜底逻辑,只有一张权重表和一次点积——却能在 2001 年 Jiménez 和 Lin 提出时把 gshare 类预测器的误预测率砍掉两到三成,背景铺垫见 分支预测基础 与 双峰与 gshare 预测器。本篇讲透感知器分支预测器的权重表结构、预测与训练规则、以及它相比 TAGE 的可解释性优势与硬件代价短板。
本文要回答的问题
- 感知器分支预测器的权重表长什么样?一次预测要做哪些运算?
- 「用全局历史异或索引」之后,点积里的正负号从哪来?
- 在线训练规则是什么?为什么它允许把历史长度拉到几十位而不炸表?
- 相比 TAGE,感知器在可解释性上的优势具体指什么?
- 感知器为什么在商用 CPU 里没有取代 TAGE?硬件代价卡在哪?
一、把分支预测看成线性分类问题
传统计数器类预测器的思路是「查表投票」:用分支地址(和一段历史)索引到某个两位饱和计数器,计数器大于阈值就预测跳转。gshare 把全局历史寄存器(GHR,Global History Register)和分支地址异或后索引,让同一个分支在不同历史路径下落到不同的计数器上,从而捕捉到「前面几个分支的走向决定了当前分支」这类相关性。但 gshare 的容量天花板很低:历史每加一位,模式数翻倍,表项很快被混叠(aliasing)打满,实用历史长度一般卡在十几位。
感知器换了一个视角。它把长度为 n 的全局历史看成一个 n 维向量 x,每一维取值 +1(该次分支跳了)或 -1(没跳)。预测就是学一个线性函数:y = w0 + w1·x1 + w2·x2 + … + wn·xn,其中 w0 是偏置权重(bias),其余每个 wi 对应「历史上第 i 次分支的走向对当前分支走向的影响程度」。y 的符号就是预测方向,y 的绝对值就是置信度。误预测(或置信度不足)时用一套增量规则更新权重——这就是全部。没有标记匹配,没有多层兜底,一个数学式子走天下。
| 维度 | gshare | TAGE | 感知器 |
|---|---|---|---|
| 核心机制 | 计数器查表 | 多层标记表兜底 | 权重向量点积 |
| 历史利用方式 | 异或折叠进索引 | 几何级数分层 | 每位历史一个独立权重 |
| 实用历史长度 | 约 8 到 16 位 | 分层覆盖到数百位 | 数十位(论文实测 30 到 60) |
| 输出 | 方向 | 方向 | 方向加置信度绝对值 |
| 理论基础 | 经验结构 | 经验结构加部分匹配 | 线性分类器,有收敛理论 |
这张表先给出三家的定位差异。最关键的是第三行「历史利用方式」:gshare 把历史折叠成一个索引,信息在哈希冲突里损耗;TAGE 用不同长度的多张表分别记,靠层级缓解冲突;感知器最直白——每一位历史都有自己专属的权重,互不挤占。这正是它能消化长历史的根本原因,也是全篇反复回到的主线。
二、权重表结构与一次预测的完整流程
感知器预测器的硬件是一张权重表:若干行,每行存一个权重向量(w0 到 wn),每个权重是一个带符号小整数(典型 8 位)。预测一条分支时,流程分四步。
第一步,索引。用分支地址(有时再异或上历史做混淆)对表取模,选中一行权重。注意这里只有地址参与索引,历史不进索引——这是与 gshare 的本质区别。
第二步,取向量。把 GHR 的每一位 xi 映射成 +1 或 -1,得到历史向量。
第三步,点积。把选中的权重向量与历史向量逐位相乘再求和。因为 xi 只取正负一,「乘法」退化为「取反或不取反」——硬件上就是一排加法器,wi 为加数,xi 决定符号。加上偏置 w0,得到 y。
第四步,拍板。y 非负预测跳转,为负预测不跳;|y| 同时作为置信度输出给上层(比如混合预测器的选择逻辑,见 竞赛混合预测器)。
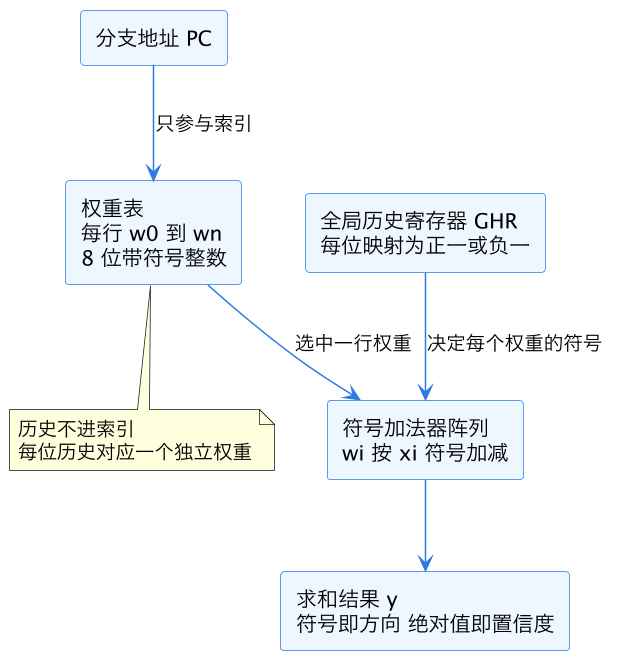
上图是预测路径的数据流。请盯住「历史不进索引」这条标注:权重表的行数只取决于想区分多少个分支,而与历史长度无关;历史长度只决定每行有多宽。行数与宽度解耦,是感知器把历史拉到几十位而表面积不爆炸的结构性原因。相比之下 gshare 的历史长度直接坐在索引位数里,每加一位表就要大一倍。
三、在线训练规则:错了就学,不够自信也学
感知器的训练发生在分支退休、真实结果揭晓的时刻。规则只有两条:
- 如果预测错了(y 的符号与真实结果 t 相反,t 取 +1 或 -1),或者预测对了但 |y| 小于一个训练阈值 θ,就更新权重。
- 更新方式:w0 加上 t(偏置向真实方向挪一步);对每个 i,如果 xi 与 t 同号,wi 加一,否则减一;权重做饱和截断,不溢出。
第二条规则的直觉非常干净:wi 在「历史上第 i 次分支的走向与当前分支走向一致」时被加强,相反时被削弱。训练足够多的轮次后,wi 的值本身就编码了「第 i 位历史对当前分支是正相关还是负相关、相关多强」。阈值 θ 的作用是让权重继续增长到有足够裕量——经典论文给出的经验公式是 θ 约等于 1.93n + 14(n 为历史长度),保证在线性可分的分支上训练一定能收敛。
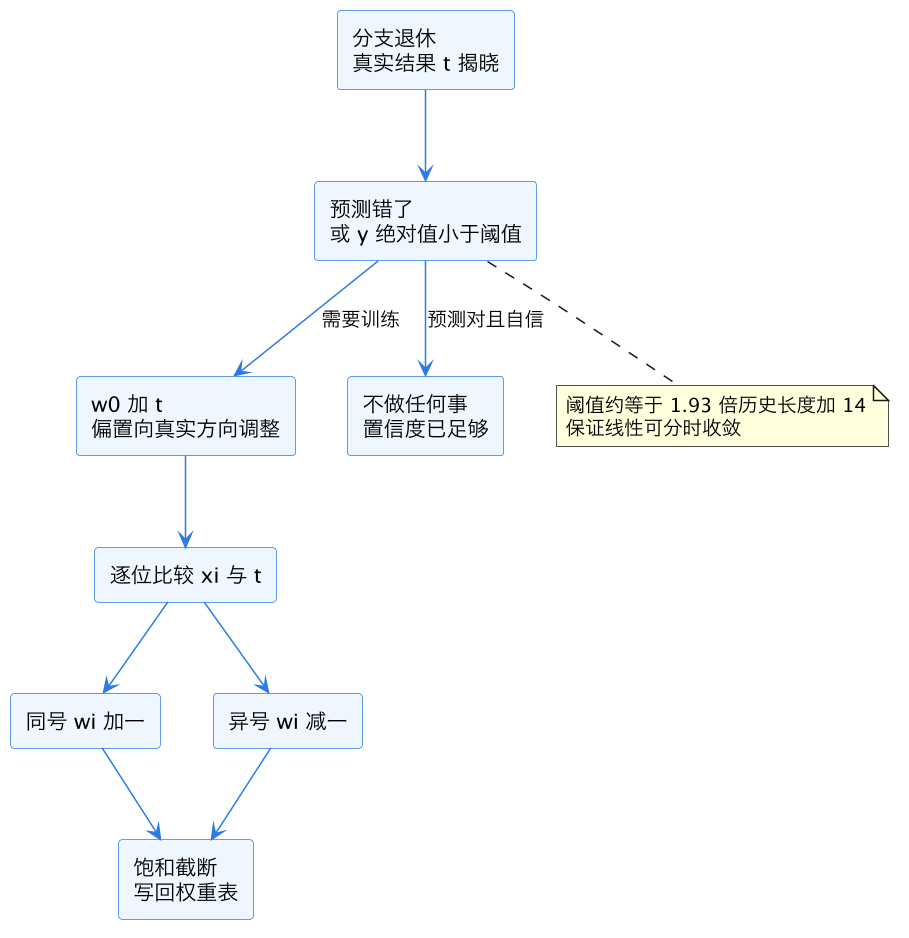
上图是训练路径的决策流。两个设计点值得多说一句。其一,「预测对了但不够自信也训练」是感知器区别于朴素感知机的地方——它让权重持续积累裕量,对抗混叠带来的干扰;其二,训练完全发生在退休阶段,不在预测关键路径上,所以训练逻辑稍复杂也无妨,这也为后面第五节的延迟问题埋下对照:预测在取指流水线上,那是真的一秒都拖不得。
四、可解释性:权重本身就是一份相关性报告
现在正面回答选题的核心对比:相比 TAGE,感知器的可解释性强在哪。
TAGE 的内部状态对人类几乎是不透明的。它的预测来自「最长匹配历史的那张表里的某个三位计数器」,这个计数器是无数次地址、历史、标记哈希混合后的沉淀物。你想知道「这个分支为什么被预测为跳」,只能回答「因为某张表的某一项当前计数大于等于 4」——至于这项被哪些历史模式训练过、和哪几次前置分支相关,全部淹没在哈希里。调预测器只能靠蒙特卡洛式地调表数、历史长度序列、计数器位宽。
感知器恰恰相反。训练收敛后,权重向量本身就是一份可以直接阅读的相关性报告:w3 是很大的正数,说明「倒数第三次分支跳了,当前分支大概率也跳」;w7 接近零,说明第七位历史与当前分支无关;w0 大而其余都小,说明这是个偏置型分支(几乎恒跳或恒不跳),与历史无关。研究人员甚至可以跑完基准测试后把权重表 dump 出来做程序分析——这是 TAGE 类结构给不出的能力。
| 可解释性维度 | 感知器 | TAGE |
|---|---|---|
| 单个预测的依据 | 权重点积,每项贡献可分解 | 某层计数器值,来源不可追溯 |
| 历史相关性 | 每位历史的权重即相关系数 | 隐含在历史长度分层里 |
| 偏置分支识别 | w0 一枝独秀,一眼看出 | 无直接表征 |
| 调参方式 | 历史长度、阈值、权重位宽,语义明确 | 表数与几何序列组合空间大 |
| 收敛行为 | 线性可分时理论上保证收敛 | 依赖混叠缓解经验设计 |
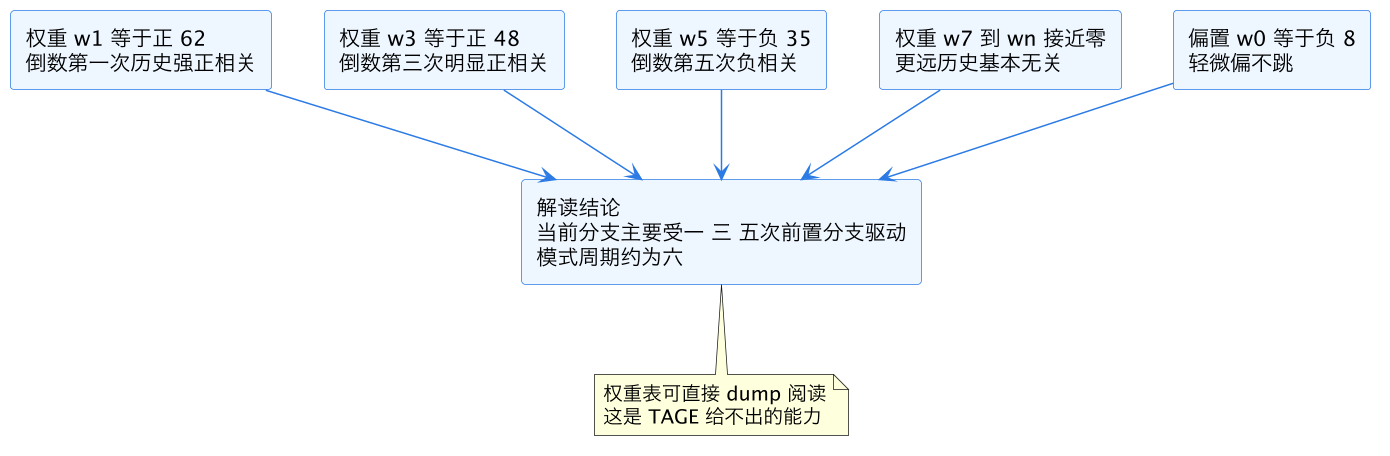
上图用一个具体权重向量演示「读权重表」的过程:六个数字凑在一起,直接讲出了这个分支受哪几次前置分支驱动、模式周期大约多长。这种把预测器内部状态翻译成程序行为描述的能力,在分析固定循环、状态机类负载时是实打实的工具价值。
五、硬件代价:为什么商用 CPU 没让它取代 TAGE
既然感知器精度更高(当年论文在相同存储预算下误预测率优于 gshare 约两到三成,也优于同期多数方案)、历史更长、还能解释,为什么今天的 Intel 和 AMD 主力方向预测器仍是 TAGE 家族?答案在三个字:关键路径。
预测延迟是分支预测器的生命线。方向预测必须在取指当拍或下一拍给出,晚一拍就是一次前端空转,前端空转与重定向的代价见 取指重定向恢复。TAGE 的预测路径是「索引一张 SRAM 表,读出一个三位计数器,看符号位」——一次 SRAM 读加一个比较,一拍以内搞定。感知器的预测路径是「索引权重表,读出一整行 8 位乘以几十位的权重,然后做几十路带符号加法」——树状加法器阵列的组合逻辑延迟,在 2000 年代初的工艺下稳稳超过一拍,插到取指流水里就是直接的前端气泡。
人们想过绕路:把点积拆成两拍流水(第一拍读表、第二拍算加),代价是方向预测晚一拍;或者路径化(path-based)组织,把历史向量的计算摊到转移路径上增量维护。这些变体能缓解但不能根除——TAGE 的「一拍出结果」标杆立在那里。再叠加几个工程账:
| 代价维度 | 感知器 | TAGE |
|---|---|---|
| 单条预测逻辑延迟 | 读表加几十路加法,超过一拍 | 一次 SRAM 读,一拍内 |
| 每分支存储 | 几十乘 8 位的一整行权重 | 3 位计数器加少量标记位 |
| 同等容量覆盖的分支数 | 少(每行太宽) | 多(每层表项极窄) |
| 只预测对的能耗 | 点积每次都全量算 | 读一项即走 |
| 对不可线性分离分支 | 结构性学不会 | 多层结构可部分兜住 |
最后一行是精度上的软肋:感知器本质上是线性分类器,XOR 型分支(走向等于前两位历史异或)理论上就无法被单个感知器学住,而 TAGE 的多层标记结构对这类模式反而能记住部分实例。后续研究(如把感知器作为 TAGE 的一层、或用 hashed perceptron 改善索引)一直在试图取两家之长。
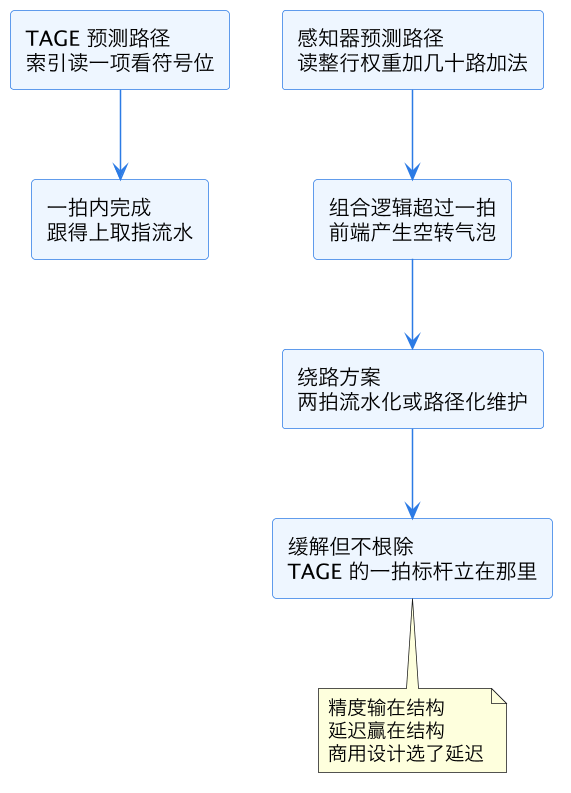
上图收束了这场对比的逻辑链:感知器输在把「算」放进了预测关键路径,TAGE 赢在把「算」全部预支成了「存」。这其实是计算机体系结构里反复上演的戏码——存储换时间。感知器的思想并未死去,它以「混合预测器里的一个成员」「间接分支预测器的变体」「长历史相关性研究的标准工具」等身份活着,间接分支侧的同类思路见 ITTAGE 间接分支预测器。实测层面,想观察长历史相关性是否被自家 CPU 学到,可以用 PMU 的分支误预测事件对比不同历史距离的工作负载,方法见 PMU 性能计数器编程。
这一篇在知识体系里的位置
本篇是微架构模块「分支预测线」的预测器专题第三篇。上游基础是 分支预测基础(预测失败的代价与指标)、双峰与 gshare 预测器(计数器类方案的上限)与 全局历史寄存器长度(历史这个输入本身)。同线主干是 TAGE 分支预测器(商用主流方案,本篇的对照系),组合方案见 竞赛混合预测器,间接分支侧见 ITTAGE 间接分支预测器,预测出错后的流水线代价见 取指重定向恢复。全景地图见 CPU 微架构总览。
总结
感知器分支预测器把分支预测重述为一个线性分类问题:用一张按分支地址索引的权重表,让全局历史的每一位拥有独立权重,预测是对历史向量做一次点积、以符号定方向、以绝对值定置信度,误预测或置信不足时按「同号加一异号减一」的规则在线训练并饱和截断;历史与索引解耦的结构让它能用数十位长历史,训练收敛后的权重向量本身就是一份可阅读的相关性报告,这是 TAGE 层层哈希的计数器给不出的可解释性;但点积的几十路加法落在取指关键路径上,单条预测延迟超不过 TAGE 的「一拍读表看符号」,加上线性不可分模式的结构性盲区,商用 CPU 最终选择了 TAGE 家族,感知器则以混合成员与研究工具的身份继续活着。