内存屏障差异:ARM dmb/dsb 与 x86 mfence 语义对照全解
更新时间:2026-10-02。内存一致性模型与 TSO 那篇建立了「硬件为什么敢把访存乱序」的框架:为了性能,处理器允许 load 和 store 以不同于程序序的次序被其他核观察到,而内存屏障(memory barrier / fence)就是程序员手里那根「到此为止不许乱」的缰绳。但同一根缰绳,在 x86 和 ARM 上长得完全不一样——x86 只有 mfence、lfence、sfence 三条,语义相对直白;ARM 有 dmb、dsb、isb 三大件,dmb 还带着 ish/nsh/sy/ld 一串选项后缀。同一段无锁队列代码,x86 上不加屏障可能跑得欢,原样编到 ARM 服务器上就开始偶发数据损坏。这一篇把两边的屏障语义、背后的硬件动机、经典翻车场景逐条对照清楚。屏障本身的性能代价见 内存屏障的开销,底层乱序的物理载体见 store buffer 与写合并。
本文要回答的问题
- x86 的 TSO 模型天然保证了哪些次序,所以 mfence/lfence/sfence 各自只需要堵哪个口子?
- ARM 弱序模型放开了哪些 x86 不敢放的乱序,dmb 为什么必须带 ish/nsh/sy/ld 这些选项?
- dmb、dsb、isb 三条 ARM 屏障指令的分工是什么,什么时候必须升级到 dsb?
- 消息传递、Dekker 互斥这些经典场景下,同一段算法在两边各需要插什么屏障?
- 移植并发代码时,一张对照表能不能覆盖 90% 的决策?
一、差异的根源:TSO 与弱序模型放开的乱序自由度不同
内存屏障差异不是指令集设计的口味问题,是内存一致性模型(Memory Consistency Model)承诺力度不同的直接结果。一致性模型规定「一个核的访存操作,在什么条件下允许以别的次序被另一个核观察到」。x86 承诺的是 TSO(Total Store Order,全存储序),ARM 承诺的是弱得多的 ARM weak-ordering 模型。
TSO 只放开一个口子:Store→Load 乱序。本核先写 A 再读 B,硬件允许读 B 先完成、写 A 还躺在 store buffer 里没进缓存——其他核可能暂时看不到 A 的新值。除此之外全保序:Load→Load 不乱、Load→Store 不乱、Store→Store 不乱,写操作在所有核眼里按同一个全局次序出现。x86 敢这么强,是因为 store buffer 之外的乱序收益小、验证成本高,Intel 从 486 时代就这么一路兼容下来了。
ARM 的弱序模型把这些口子全部放开:Load→Load 可以乱(两次读可能按反序拿到值),Load→Store 可以乱,Store→Store 可以乱,甚至连「数据依赖」之外的地址依赖、控制依赖都可能被投机执行穿透。动机同样务实:ARM 生态从手机到服务器,核数从单核到上百核,弱序给了实现最大的乱序自由度——load 可以提前发射、写可以攒在写缓冲里慢慢合并,小核省电、大核提频都受益。代价转嫁到软件:需要次序的地方,程序员自己插屏障。
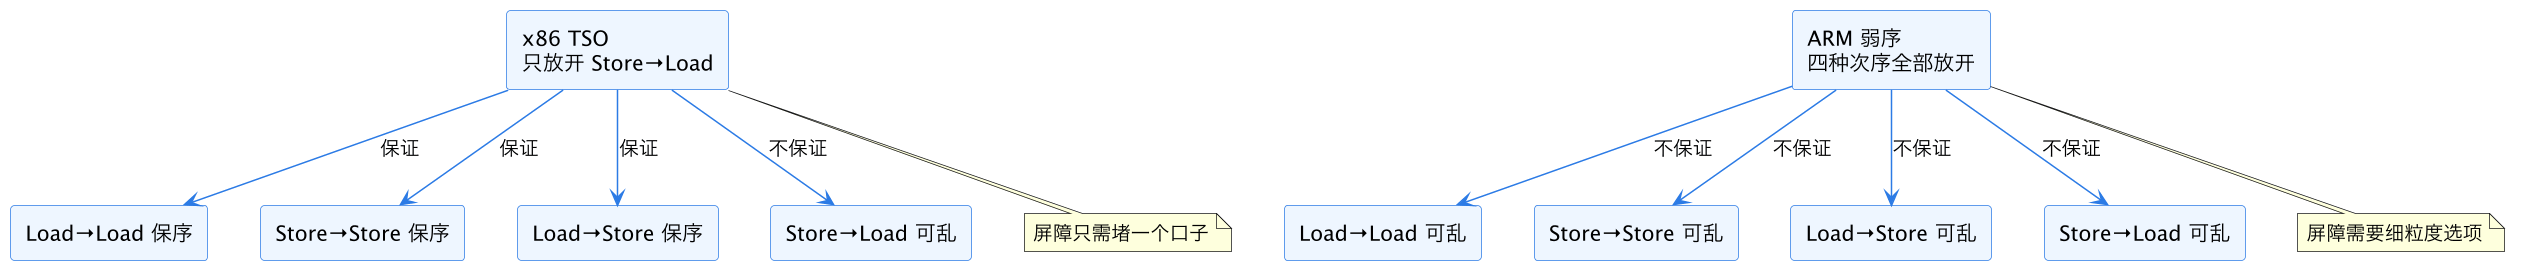
上图是两边模型承诺的对照。左边 x86 四个格子里三个是绿的(保序),只有一个口子需要 mfence 去堵;右边 ARM 四个口子全开,所以它的屏障必须带选项让程序员说清「我要堵哪个口子、堵到什么范围」。这一张图解释了后文所有指令设计的差异。
二、x86 三剑客:mfence、lfence、sfence 的分工
x86 的屏障指令少而克制,每一条对应一个明确的硬件口子。
mfence(memory fence)是全家桶:保证它之前的所有 load 和 store 全局可见之后,后面的访存才开始。实际效果就是把本核 store buffer 排空到缓存,并等待之前的 load 完成。它是 TSO 上唯一能堵 Store→Load 口子的指令,也是最贵的——现代核上几十到上百周期,具体代价的量化见 内存屏障的开销。
sfence(store fence)只约束 store:之前的写全部可见后才放行后面的写。但 TSO 本来就保证 Store→Store 次序,sfence 在普通写回(WB)内存上等于空操作。它真正的用武之地是非临时写(non-temporal store,movnt 系列)和写合并(WC)内存——这两类写绕过缓存直接进写合并缓冲,TSO 管不着,必须 sfence 兜底。做 memset 大拷贝或显存映射 I/O 的人才需要它。
lfence(load fence)约束 load:之前的读全部完成后才放行后面的访存。TSO 下 Load→Load 天然保序,lfence 的硬件语义也接近空操作;它出圈是因为 Spectre 之后被当作「序列化指令」用——堵住投机执行的取指路径,防止后面的 load 被投机发射去构造侧信道。攻防细节见 Spectre 与 Meltdown:瞬态执行攻击。
还有一条不成文的规矩:x86 上带 lock 前缀的指令(lock xchg、lock cmpxchg、lock add 等)自带完全屏障语义,执行时锁缓存行并排空 store buffer。所以 x86 的无锁代码里大量屏障是「免费」的——compare-and-swap 本身就是屏障。这一点对理解后面 ARM 的对照很关键,CAS 的原子性实现见 原子锁与缓存行实现。
三、ARM 三大件:dmb、dsb、isb 与选项参数
ARM 的屏障体系是三个动词加一个选项矩阵。
dmb(Data Memory Barrier,数据内存屏障)是日常主力:保证屏障前的访存「被观察到」先于屏障后的访存。注意措辞是「被观察到」而不是「执行完」——dmb 不排空缓冲、不等响应,只是在内存序里划一条线,硬件保证线两边不会互相穿越被其他观察者看到。这是最便宜的一档。
dsb(Data Synchronization Barrier,数据同步屏障)是加强版:不仅划线,还要求屏障前的访存真正「完成」(完成 = 写到达一致性点、读拿到值),执行 dsb 的核要停下来等。什么时候必须升级到 dsb?和系统状态交互的时候:改了页表再开 MMU、改了 GIC 中断控制器的配置、给设备寄存器写完启动命令再等它干活——这些场景里「被观察到」不够,必须「确实生效」。设备驱动和内核代码里 dsb sy 是标配。
isb(Instruction Synchronization Barrier,指令同步屏障)管的不是数据是取指:冲刷流水线,让后面的指令按最新上下文重新取。改了代码(自修改代码、JIT 写代码页)、改了系统寄存器之后,用 isb 保证后续指令看到新状态。
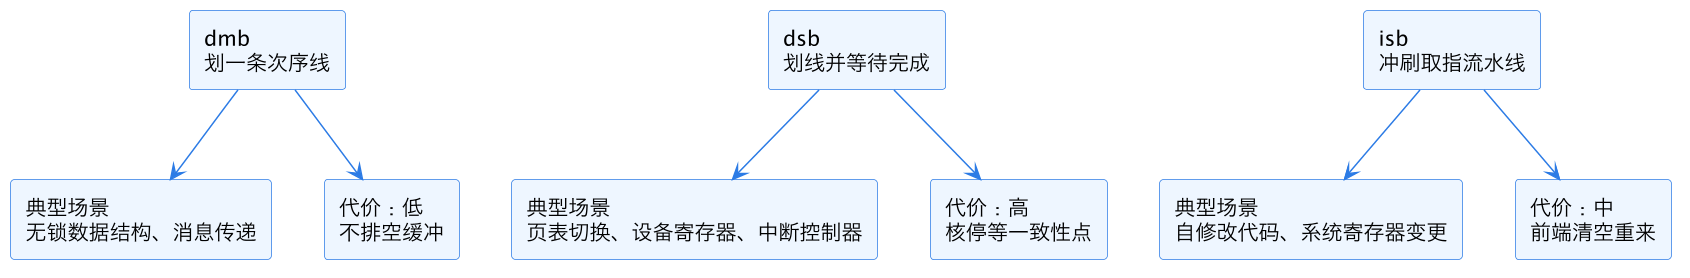
上图是三条指令的分工。记法一句话:dmb 管「次序」,dsb 管「完成」,isb 管「取指」。写普通并发代码只用 dmb;碰页表、碰设备、碰中断才升 dsb;isb 基本只在内核和 JIT 里出现。
dmb/dsb 后面还能挂两类选项,这是 x86 完全没有的概念。
第一类是共享域(shareability domain):ish(inner shareable,内部共享域,通常就是同一缓存一致性簇里的核)、nsh(non-shareable,只对本核可见)、osh(outer shareable,外部共享域,含外设)、sy(system,全系统)。多线程共享内存用 ish 就够,范围越小硬件要广播的一致性动作越小、越便宜;sy 留给跨设备场景。
第二类是访问类型:ld 后缀表示屏障只约束 load,屏障前的 load 先完成,但 store 可以越过。dmb ishld 是「读屏障」,正好对上「我只怕 Load→Load 乱序」的场景,比全屏障便宜。
于是 ARM 的屏障是一个二维矩阵:三个动词 × 若干选项。dmb ish、dmb ishld、dsb sy 是实践中最常见的三个组合,分别对应「全屏障」「读屏障」「系统级完成屏障」。
四、经典场景对照:同一段算法两边各插什么
理论讲完,落到两个教科书级场景看差异有多大。
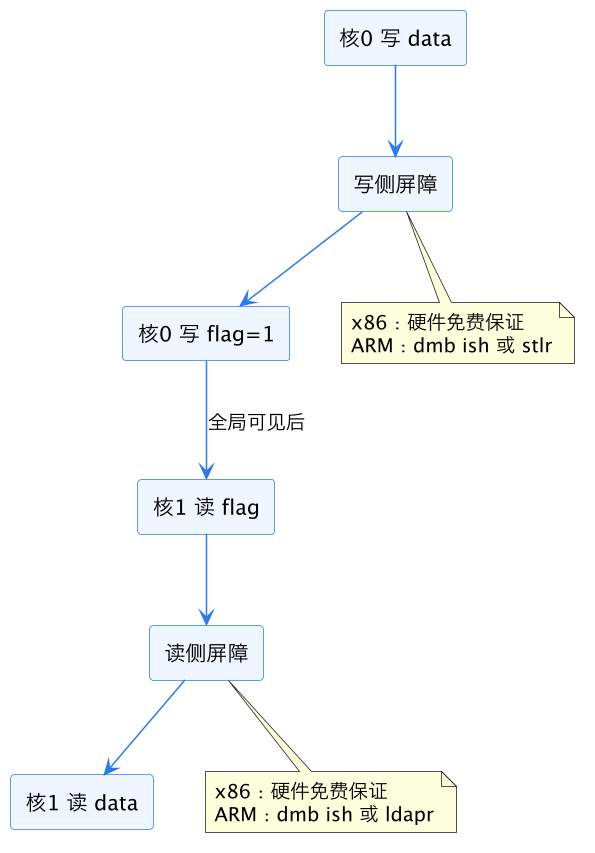
场景一:消息传递(message passing)。核 0 写数据 data 再写标志 flag=1;核 1 轮询 flag,看到 1 之后读 data。正确性要求:核 1 看到 flag=1 时,data 的写必须已经可见。
x86 上这段代码什么都不用加。写侧 Store→Store 保序,flag 不会先于 data 被看到;读侧 Load→Load 保序,读到 flag 后读 data 必然拿到新值。TSO 把两个方向的次序都保了,编译器屏障(防止编译器重排)之外硬件层面是免费的。
ARM 上两边都要插。写侧 Store→Store 可以乱,flag 可能先于 data 到达其他核,要在两次写之间插 dmb ish(这就是 C++ std::atomic_thread_fence(release) 或 store-release 的落点);读侧 Load→Load 可以乱,核 1 可能投机地提前把 data 读了,要在读到 flag 之后插 dmb ish(acquire 语义)。ARMv8 为此专门加了 ldr/stur 的 acquire/release 变体:ldapr 和 stlr,一条指令把屏障和访存合并,比单独 dmb 便宜——这也是「释放-获取」语义成为现代原子操作标准词汇的硬件背景。
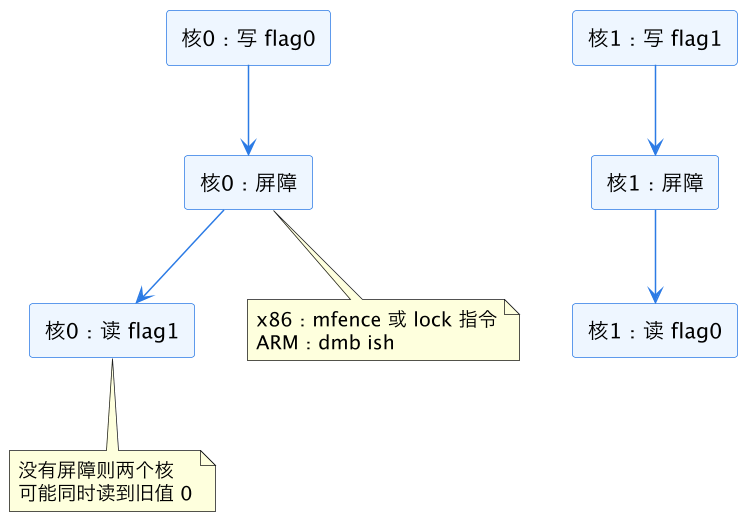
场景二:Dekker 式互斥 / 双向标志检查。核 0 写 flag0=1 再读 flag1,核 1 写 flag1=1 再读 flag0,两边都看到对方为 0 就出事。这是 Store→Load 乱序的经典猎物——写还躺在 store buffer 里,读已经发出去了,两个核都可能读到对方的旧值 0。
这个场景两边都逃不掉:x86 的 TSO 恰恰放开的就是 Store→Load,必须在写和读之间插 mfence(或用 lock 前缀指令做交换,让屏障免费);ARM 上对应 dmb ish 全屏障。差别在于代价和频度:x86 程序员只在 Dekker 这一类「写完立刻要看到别人写」的模式里付钱,日常的消息传递免费;ARM 程序员两类场景都要付,但单次 dmb ish 通常比 mfence 便宜,且可以用 ld 选项裁剪。
把两个场景合起来,就得到移植代码时的决策表:
| 场景 | 需要的次序 | x86 | ARM |
|---|---|---|---|
| 消息传递 写侧 | Store→Store | 硬件免费 | dmb ish 或 stlr |
| 消息传递 读侧 | Load→Load | 硬件免费 | dmb ish 或 ldapr |
| Dekker 双向检查 | Store→Load | mfence 或 lock 前缀 | dmb ish(全屏障) |
| 只读快照一致性 | Load→Load | 硬件免费 | dmb ishld(更省) |
| 非临时写/设备内存 | Store→Store(特殊内存) | sfence | dmb osh 或 dsb |
| 页表/系统寄存器变更 | 访存完成 | invlpg 等专用序列 | dsb ish + isb |
| 自修改代码/JIT | 取指同步 | 不需要(自一致) | dsb ish + isb |
表里最后一行值得多看一眼:x86 对自修改代码有硬件自一致性保证(写了代码再跳过去执行,硬件自动冲刷),ARM 没有,必须 dsb + isb 手动来。JIT 引擎从 x86 移植到 ARM 时漏掉这对组合,表现为「偶发执行到旧代码」,极难复现。
五、开销与心智模型:为什么两边哲学不同
把两边的屏障哲学放在一起看,差异其实是一笔总账的分摊方式不同。
x86 的思路是「硬件多花钱,软件少操心」:TSO 把大部分次序在硬件里保掉,程序员只在极少数模式(Dekker 类、非临时写)里显式付 mfence 的重价。好处是遗留代码天然安全,坏处是每次写都要维持全局序——store buffer 满了要停等,store buffer 与写合并 那篇讲过这个压力,多核高写频场景下 TSO 的保序成本实打实地反映在功耗和频率上。
ARM 的思路是「硬件放手,软件按次付费」:默认什么次序都不保,硬件实现获得最大乱序自由度;程序员用 dmb 的选项矩阵精确声明「我要哪一段次序、作用到哪个域」,需要多少付多少。dmb ishld 比 dmb ish 便宜,dmb ish 比 dsb sy 便宜得多——粒度就是金钱。坏处是程序员的心智负担全部转嫁过来:漏插一个屏障就是一颗偶发数据竞争的定时炸弹,而且这类 bug 在 x86 开发机上往往不炸,上了 ARM 服务器才炸。
还有一个容易被忽视的非对称点:编译器重排与硬件重排是两道独立的关。上面讨论的全部是硬件层面的可见次序;但即使硬件保序如 TSO,编译器依然可以把两次访存对调、把读提升出循环。所以两边的正确姿势都是「编译器屏障(如 C 的 atomic_signal_fence 或内联汇编空 barrier)加硬件屏障」双层防护,x86 上很多场景硬件层免费、但编译器层从来不免费。这也是为什么 volatile 在多线程场景救不了你——它只挡编译器,对硬件乱序一个字节都管不着。
实践层面的建议因此很直接。第一,用 C11/C++11 原子语义(memory_order_release/acquire/seq_cst)写代码,让编译器去映射两边的屏障——release 在 x86 上编成普通 mov,在 ARM 上编成 stlr 或 dmb ish,同一份源码两边都对。第二,手写汇编屏障时按上表查场景,不要「ARM 上全用 dmb sy 保险」——sy 域的广播范围比 ish 大,热点路径上白花钱;也不要「x86 上能跑就不管」,TSO 只保三种次序,Store→Load 那个口子永远在。第三,怀疑屏障问题时用 litmus 测试工具(herd7、diy)形式化验证,比肉眼推弱序交织可靠得多;观测手段上,perf 的内存采样能帮你定位屏障密集的热点,CPU 性能工具目录 下有对应入口。
这一篇在知识体系里的位置
本篇是微架构模块里内存一致性线的深水篇。上游框架文是 内存一致性模型与 TSO,建立了「模型决定乱序自由度」的总框架;屏障的硬件载体在 store buffer 与写合并 与 store-to-load forwarding,代价量化见 内存屏障的开销;同线并行的是一致性协议的实现层 MESI 与 MOESIF 缓存一致性协议(协议管「值怎么传播」,屏障管「次序怎么约束」,两者配合才构成完整的可见性语义);下游应用见 原子锁与缓存行实现 与投机侧信道的 Spectre 与 Meltdown;全图见 CPU 微架构总览。
总结
内存屏障差异的本质是内存一致性模型承诺力度的差异:x86 的 TSO 只放开 Store→Load 一个口子,所以 mfence 堵一处、lfence/sfence 补边角,消息传递类次序硬件免费;ARM 弱序四种次序全放开,于是用 dmb(管次序)/dsb(管完成)/isb(管取指)三条动词加 ish/nsh/sy 域与 ld 类型的选项矩阵,让程序员按场景精确付费——移植并发代码的正确姿势是写 C11 原子语义让编译器映射,手写屏障时按「消息传递、Dekker、设备交互」三类场景查表选指令。