MOVDIR 直接存储:MOVDIRI/MOVDIR64B 直写指令的语义与设备通信、原子发布场景速查
更新时间:2026-10-05。普通 store 指令写完,数据落在自己的缓存行里,其他核要靠一致性协议才能看见;设备 MMIO 写入又常常要求「立即上路、不许合并」。MOVDIR 直接存储家族——MOVDIRI 和 MOVDIR64B——就是 Intel 为这两类需求开的后门:一条指令把 4/8 字节或整整 64 字节直接推向目标地址,不占用本地缓存。它们是 CLFLUSHOPT 与 CLWB 持久内存刷写 的镜像:那边管「把脏行赶出缓存」,这边管「干脆不进缓存」。背景概念见 CPU 微架构总览,一致性语义对照 缓存一致性协议。
本文要回答的问题
- MOVDIRI 和 MOVDIR64B 各写多少字节、语义上与普通 store 差在哪?
- 「直接存储」到底直接到哪——排序保证有多弱,要不要自己加 fence?
- 设备通信场景为什么偏好这两条指令?
- 用户态想用它做 64 字节原子发布,需要什么前提条件?
一、两条指令的基本语义
MOVDIRI 的格式是 movdiri mem, reg:把通用寄存器里的 4 或 8 字节(取决于操作数尺寸)以「直接存储」方式写到内存地址。写的效果对其他观察者最终可见,但它走的是弱排序的写合并通路——不进入本核缓存,也不触发常规的所有权请求(RFO)流程。
MOVDIR64B 的格式是 movdir64b mem, zmm/ymm/xmm 或 512 位源:一次把整整 64 字节(一个缓存行)以直接存储方式写出去,源操作数必须按 64 字节对齐,目标地址也必须 64 字节对齐。这是 x86 上第一条「单指令写一整行」的用户态指令,而且这 64 字节的写对其他核是原子可见的——要么整行旧值、要么整行新值,不会出现撕裂。
| 维度 | MOVDIRI | MOVDIR64B | 普通 MOV store | NT store(movntdq) |
|---|---|---|---|---|
| 写入宽度 | 4 或 8 字节 | 64 字节整行 | 1–64 字节 | 16/32/64 字节 |
| 对齐要求 | 自然对齐 | 64 字节 | 无 | 按宽度对齐 |
| 是否占本地缓存行 | 否 | 否 | 是(写分配) | 否 |
| 原子可见粒度 | 写宽度 | 整行 64 字节 | 缓存行内对齐部分 | 无保证 |
| 排序强度 | 弱排序 | 弱排序 | TSB 强排序 | 弱排序,需 sfence |
| 典型用途 | MMIO 门铃 | 设备描述符、整行发布 | 通用 | 流式大块写 |
这张表是速查核心:MOVDIR64B 最独特的价值是「整行原子 + 不落缓存」的组合,这在普通 store 体系里是拿不到的。
二、直接存储的执行路径与排序保证
普通 store 的生命周期是:进入 store buffer,退役后向其他核发 RFO 拿到缓存行的 M 态,写入 L1,一致性流量在核间穿行。MOVDIR 直接存储绕开了这套——数据从 store buffer 直接送上写合并(write-combining)通路,奔着内存控制器或 MMIO 目标去,本核缓存层次被整体跳过。
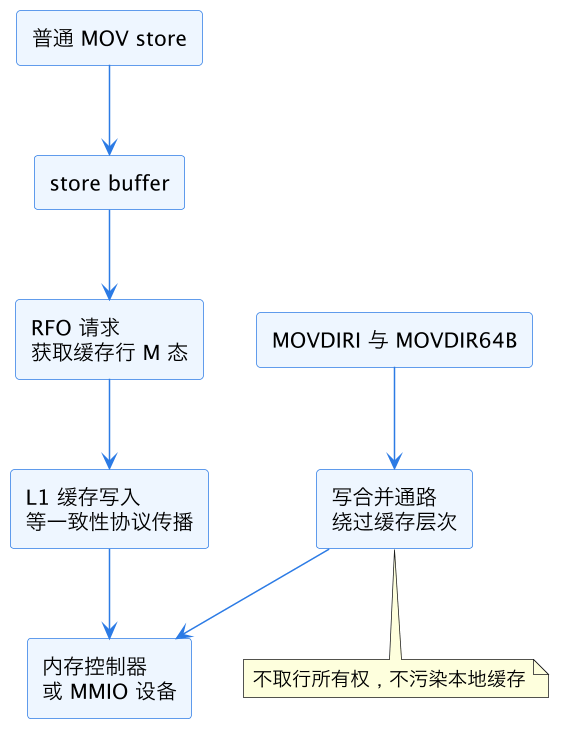
上图把两条路径画在一起:左边普通 store 必须经过「取所有权、写 L1、协议传播」三步,右边 MOVDIR 直接存储走写合并通路一步到目标。代价是排序保证降级——MOVDIR 写相对其他 store 是弱排序的,和 NT store 同一档。含义很具体:
- 连续两条 MOVDIRI 写同一个设备寄存器,到达顺序可能被重排;
- 「先写数据、再写门铃」的经典设备交互序列,如果数据用普通 store、门铃用 MOVDIRI,两者之间没有顺序保证;
- 需要顺序的地方必须显式插
sfence,或者把整段交互都设计成幂等。
内核里 CONFIG_X86_64 下对 MOVDIRI 的支持主要体现在驱动层的门铃写入;用户态要用,得确认 CPUID leaf 7 里 MOVDIRI 与 MOVDIR64B 两个特性位都在。
三、设备通信场景:门铃与描述符
设备通信是 MOVDIR 直接存储的主战场。以 NVMe 为例,提交队列的门铃寄存器是 MMIO 地址,驱动每提交一批命令就要写一次门铃通知设备。传统写法是普通 store 加必要的 fence;换成 MOVDIRI 之后,写操作不再经过本核缓存,省掉一次对只写一次数据的缓存行占据,也避免门铃地址所在行被拉进 L1 造成的无效一致性流量。
MOVDIR64B 更适合「写一整条设备描述符」的场景:64 字节恰好是很多网卡、加速器描述符的大小。一条指令把描述符整行原子推到设备可见的内存里,设备 DMA 读到的要么全是旧值要么全是新值,不需要软件再加标志位加 fence 的两段式发布。配合 CXL 内存扩展 这类把设备挂进一致性域的新互连,直接存储指令的使用面还在扩大。
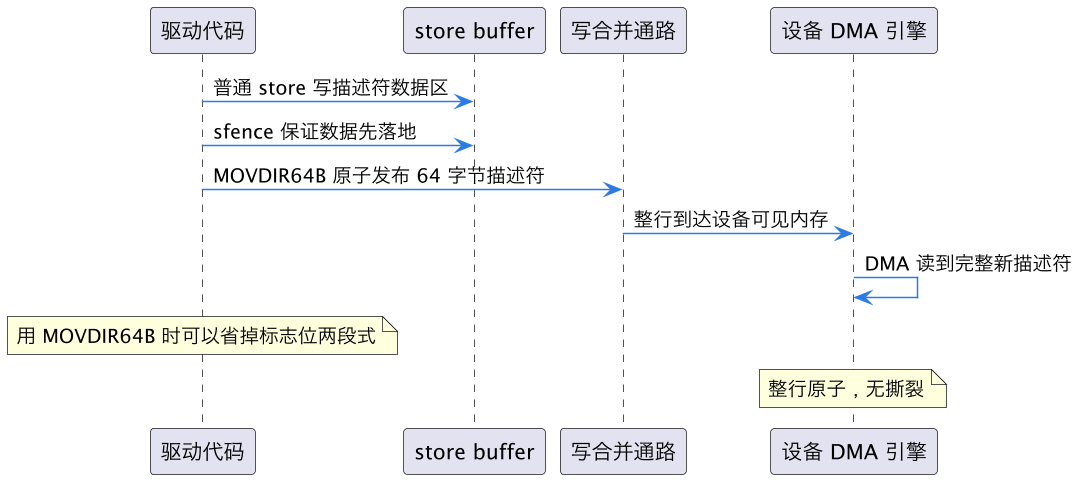
这个时序是设备驱动里的典型发布流程:数据区先行落地,描述符整行原子发布。注意时序图里的关键一点——即便有 MOVDIR64B,数据区与描述符之间那根 sfence 仍然不能省,因为数据区是普通 store 写的,弱排序的 MOVDIR 写不会等它。
四、用户态原子发布场景与使用条件
用户态最诱人的用法是「64 字节无锁消息发布」:生产者把一条不超过 64 字节的消息(含序列号或校验位打包在内)用 MOVDIR64B 一次性写出,消费者轮询读,靠整行原子性免去锁和 memory fence。这在 NUMA 跨节点、或写方不想让消息占据本地缓存的流水场景里有实际收益。
使用条件清单速查:
- 硬件:CPUID.(EAX=7,ECX=0):ECX 的 MOVDIRI 位(bit 27)与 MOVDIR64B 位(bit 28)都置位;
/proc/cpuinfo的 flags 里找movdiri movdir64b。 - 对齐:MOVDIR64B 的源和目标都必须 64 字节对齐,C 里用
__attribute__((aligned(64)))或aligned_alloc(64, ...)。 - 指令形式:没有对应的 C 语句,需要内联汇编或编译器内建函数(GCC 11 起有
_movdir64b等 intrinsic,在movdirintrin.h)。 - 回退路径:特性位不在时回退到普通 store 加锁或
lock cmpxchg16b方案,代码里要做运行时分发。
性能预期要务实:MOVDIR64B 的优势在「避免缓存污染 + 整行原子」,不在单条延迟——实测单条 MOVDIR64B 的延迟往往比普通 store 还高,因为它要走未缓存通路直到写完成点。它赢在系统级:写方缓存不脏、读方一致性流量可预测、高并发门铃下 store buffer 压力小。
最后一个容易踩的细节是与持久内存的配合:MOVDIR 直接存储到达内存控制器就算「持久化点」了吗?不是。它绕过的是 CPU 缓存,不绕过内存控制器内部的写缓冲,掉电持久性仍然要靠 sfence(把它刷到 ADR 域)来保证。所以持久内存日志场景里,MOVDIRI 可以替代「普通 store + clwb」里的 store 那一步,但 sfence 一环省不掉。
还有两个常见坑:一是虚拟化环境里 hypervisor 可能不暴露这两个特性位,云主机上先查 flags 再决定是否启用;二是 MOVDIR64B 写到 WB 类型内存才是「整行原子发布」,写到 UC/WC 类型的 MMIO 区域语义按目标区域类型走,别把两种用法混为一谈。
这一篇在知识体系里的位置
本篇属于 microarch 层「内存与一致性」专题的指令速查篇:上承 缓存一致性协议(普通 store 依赖的那套机制),与 CLFLUSHOPT 与 CLWB 持久内存刷写 互为镜像(一个赶数据出缓存、一个不进缓存),横向关联 CXL 内存扩展(设备进一致性域后的新写法),顶层索引见 CPU 微架构总览。
总结
MOVDIR 直接存储家族用两条指令覆盖两类「不想过缓存」的写:MOVDIRI 写 4/8 字节给设备门铃,MOVDIR64B 整行 64 字节原子写用于描述符和无锁消息发布;代价是弱排序——与普通 store 之间该插 sfence 还得插,用前查 movdiri movdir64b 特性位并备好回退路径。