SMT 超线程:一个物理核如何同时跑两个线程
在微架构这条线上,前面几篇已经把单核内部的乱序执行引擎拆得差不多了:cpu-out-of-order 讲了乱序五大部件,register-renaming 讲了重命名如何消除假依赖。但乱序再强,单线程的指令级并行度(ILP)终究有天花板——缓存一 miss、分支一误预测,宽宽的执行单元就空转。SMT 超线程(Simultaneous Multithreading,同步多线程,Intel 叫 Hyper-Threading)就是为填这些空窗而生的:让一个物理核同时装两个(甚至四个)硬件线程,谁的指令就绪就发谁的。
本文要回答的问题
- SMT 超线程到底在硬件层面多复制了什么、共享了什么?
- 处理器内部的资源是怎么在两个线程之间分区的——静态切半还是动态抢?
- SMT2 / SMT4 实际能带来多少性能收益,为什么很少翻倍?
- 什么场景下应该关掉超线程?
- 为什么说 SMT 是侧信道攻击的重灾区?
一、SMT 解决什么问题:执行单元的空窗
先看一个没有 SMT 的物理核在跑单个线程时的典型命运。这个核每拍最多能发射 6 条 µop,但单个线程的 ILP 有限——实测桌面/服务端 workload 的平均 IPC 往往只有 1.5~2.5。剩下的发射槽去哪了?被这几类停顿吃掉了:
- 缓存 miss:一次 L3 miss 等 40 拍,一次内存访问等 200 拍起步,期间保留站很快堆满"等数据"的 µop,前端停摆。详见 ipc-bottlenecks。
- 流水线填充深度:乱序窗口(ROB 容量 200~500 条)再大,也填不满一次内存访问的 200 拍——假设 IPC 要维持 4,200 拍需要 800 条独立指令在飞,远超任何 ROB。详见 rob。
- 分支误预测:清空流水线 15~20 拍,一切从头填充。详见 branch-prediction。
- 长延迟依赖链:除法、开方几十拍一拍不能少,依赖它的后续指令全部排队。
关键洞察是:线程 A 停顿的时候,线程 B 的指令往往完全可用。SMT 把两份架构状态塞进同一个核,发射级每拍从两个线程的就绪 µop 里挑着发——A 等内存的时候发 B 的,执行单元利用率立刻上去。它挖的不是 ILP,是线程级并行(TLP),但用的还是同一套乱序硬件。
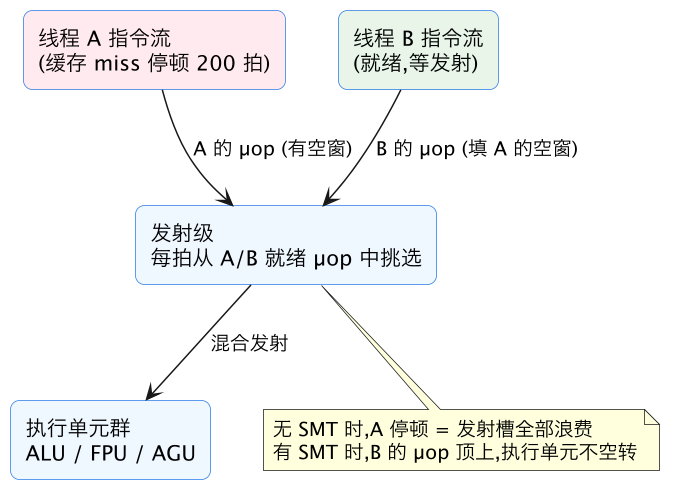
图里最关键的一点是"混合发射":SMT 不是 A 跑一拍 B 跑一拍的轮转(那叫粗粒度多线程),而是同一拍内可以从两个线程各取若干条 µop 一起发——"同时"(simultaneous)就是这么来的。
二、资源分区:复制、静态切分、动态共享三类
SMT 不是把整个核复制一份——那样就是双核了。硬件只复制"让两个线程看起来各占一个核"所必需的状态,其余大头全部共享。所有资源可以分三类:
| 资源 | 策略 | 具体内容 |
|---|---|---|
| 架构状态 | 完整复制 | 寄存器堆的架构视图、PC、控制寄存器、APIC 状态——每线程一份 |
| 乱序缓冲 | 静态切半或限量 | ROB、保留站、Load/Store Buffer:每线程最多占一半(Intel 做法),或设上限 |
| 执行与缓存 | 动态共享 | ALU/FPU/AGU、L1/L2 缓存、TLB、分支预测器:谁需要谁用,互相挤占 |
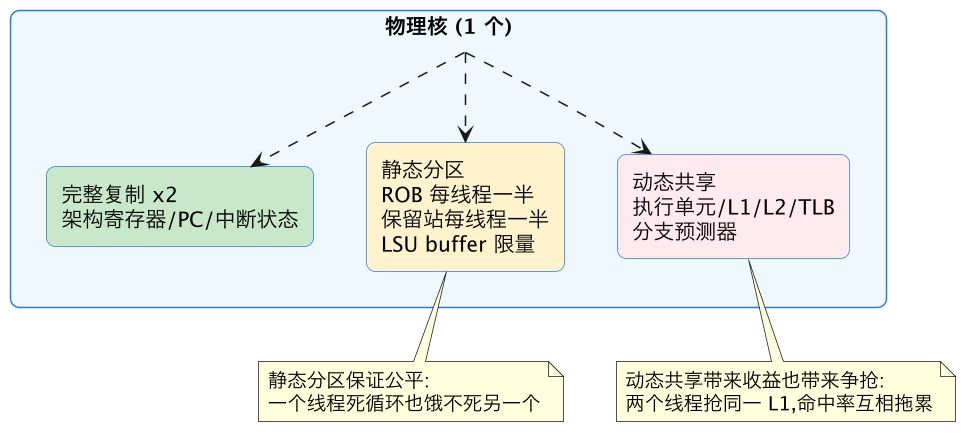
静态分区的理由是公平与可预测:ROB 如果不切半,一个线程的大量 µop 可能把整个 ROB 占满,另一个线程一条都进不去,直接饿死——这对操作系统是不可接受的,因为逻辑核对调度器而言必须表现为一个始终可用的 CPU。Intel 的做法是超线程开启时 ROB 容量对半劈——所以你会看到开了 HT 的单线程性能有时反而比关掉略低:它能用的 ROB 深度没变(独占模式下也只用自己那一半),但分区逻辑、预测器被干扰都会带来少量开销。
动态共享的部分才是收益与麻烦的共同来源。L1 数据缓存两个线程共用,A 的工作集把 B 的行挤出去是家常便饭;分支预测器(详见 branch-prediction)虽然带线程 ID 标签,容量竞争仍然存在;TLB 同理。这就是为什么 SMT 的收益高度依赖两个线程的资源"互补性":一个吃 ALU 一个等内存,是黄金搭档;两个都是缓存大胃王,就是灾难组合。
还要提一句取指级的微妙处理:分支误预测清空流水线时,只清对应线程的那部分投机 µop,兄弟线程的执行不受影响——硬件靠给每条 µop 打线程 ID 标签来区分归属,ROB、保留站里的每一项都带这个标签。这也是为什么分区策略能做得"静态切半但互不可见"。
三、SMT2 / SMT4 的收益:为什么不是翻倍
SMT2 指一个物理核跑 2 个硬件线程(Intel HT、AMD Zen 都是这个),IBM POWER 做到 SMT4 甚至 SMT8。理论很美好,实测收益却往往是 15%~30%,离翻倍很远。原因有三层:
- 发射宽度共享:核每拍只能发 6 条 µop,两个线程分。单个计算密集型线程本来就能把 IPC 撑到 3~4,留给兄弟线程的空窗本来就不多。
- 缓存互相挤占:两个线程的 L1/L2 有效容量各打对折,miss 率双双上升,停顿变多。
- 功耗墙:共享核的功耗预算,两个线程一起跑时频率可能略降。
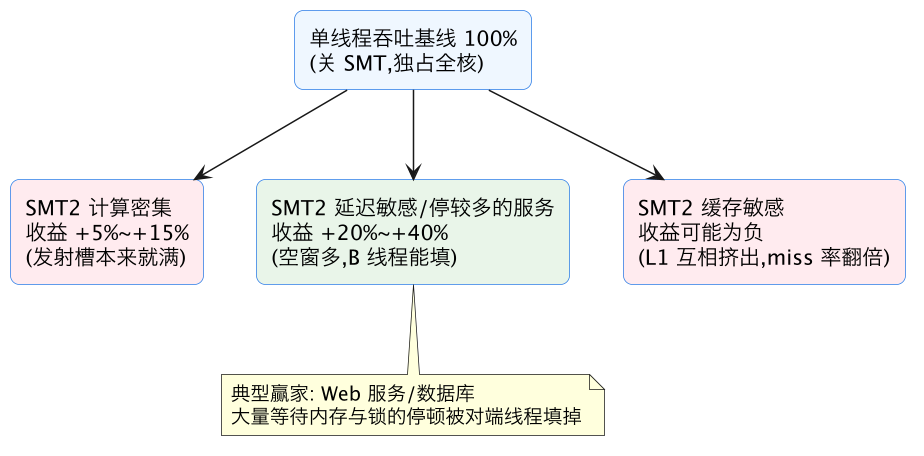
SMT4(POWER 系)的逻辑类似:从 2 线程加到 4 线程,增量收益进一步摊薄,因为发射宽度和缓存还是那一份。SMT8 更多是面向"海量轻线程、重内存延迟"的数据库负载,靠足够多的线程把内存停顿彻底遮住。
操作系统层面,每个硬件线程被呈现为一个逻辑核。lscpu 里的 Thread(s) per core: 2 就是 SMT2;调度器一般会优先把任务撒到不同物理核上,物理核占满后才往兄弟逻辑核塞。
还有一个常被忽略的微观细节:SMT 对前端的影响。取指级在两个线程之间交替(常见策略是每拍切换或按 icache miss 切换),译码带宽同样共享。这意味着两个线程的前端 footprint 加起来如果超过 L1i 容量,指令缓存的互相挤出会和数据缓存一样严重——大型 Java 服务的 JIT 代码膨胀就经常踩这个坑。
收益的快速估算方法
想不跑全量测试就粗估 SMT 收益,可以看单线程独占物理核时的 IPC:
- IPC 已经接近发射宽度上限(比如 5 以上)→ 执行槽几乎没空窗,HT 大概率无收益,直接关着测。
- IPC 在 1~2 之间 → 一半以上发射槽在空转,HT 往往有两位数收益。
- IPC 极低(< 1)且伴随高缓存 miss → 先解决数据局部性,HT 只是创可贴。
perf 里同物理核两个逻辑核的计数器是共享硬件 PMU 复用的,开启 HT 时每个逻辑核能用的通用计数器减半,复杂事件组合可能 multiplexing(轮转自旋采样),计数精度下降——做精细 PMU 分析时这也是关 HT 的一个理由。
四、什么时候应该关掉超线程
超线程不是免费的午餐,以下场景值得认真考虑在 BIOS 或内核命令行(nosmt)关掉它:
| 场景 | 为什么关 | 判断信号 |
|---|---|---|
| 安全合规/多租户云主机 | SMT 侧信道无法靠纯软件彻底封堵 | 合规要求、官方漏洞公告 |
| 实时/低延迟系统 | 兄弟线程的不可预测干扰让尾延迟抖动 | p99 延迟在 HT 开启时毛刺变多 |
| 缓存敏感的数值计算 | L1/L2 被对端线程挤占,miss 率翻倍 | 关 HT 后单作业吞吐反而上升 |
| 精确性能归因 | 逻辑核的 PMU 计数器互相污染,perf 数据难解读 | 同一物理核两个逻辑核的 IPC 都虚低 |
反过来,Web 服务、Java 后端、编译服务器这类"线程多、停等多"的负载,开着 HT 基本是白捡 20% 吞吐,关掉是纯亏。正确姿势是按 workload 实测:同一批任务,HT 开/关各跑一遍,比较总吞吐和尾延迟,再决定。
排查时还要记住:同一个物理核的两个逻辑核(如 CPU0 和 CPU16)是绑在一起的。绑核做性能实验时把两个线程绑到兄弟逻辑核上,等于自己给自己造了 SMT 竞争——数据会莫名其妙地难看。查兄弟关系可以看 /sys/devices/system/cpu/cpuN/topology/thread_siblings_list,里面列出的就是同一物理核上的逻辑核组合。
观测 SMT 争用的实用命令
lscpu | grep -E "Thread|Core|Socket"   # 确认每核线程数
mpstat -P ALL 1                         # 兄弟逻辑核的利用率是否同涨同落
perf stat -e cycles,instructions ./app  # 对比 HT 开/关下的 IPC 变化
cat /sys/devices/system/cpu/cpu0/topology/thread_siblings_list
一个实用的判读经验:如果两个兄弟逻辑核都显示 60% 利用率,真实负载可能已经接近该物理核的极限——因为 SMT 的利用率计数把"等发射槽"也算进了 busy,两个 60% 往往不等于还有 40% 余量。容量规划时把同核兄弟逻辑核的利用率取平均再乘一个经验系数(约 1.25),比直接把两个数字加起来更接近物理核的真实压力。
五、侧信道:共享即泄漏
SMT 的安全问题是结构性的:所有动态共享的部件都是潜在的信息泄漏通道,而且两个线程跑在同核同拍,时间分辨率极高,比跨核的侧信道好使得多。
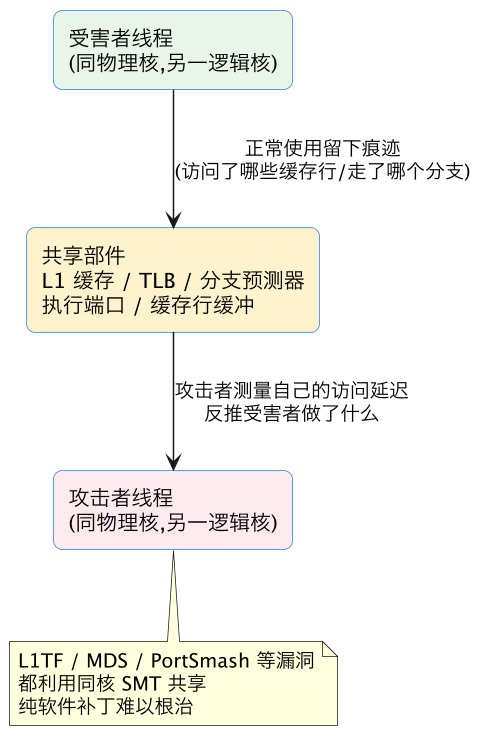
几条真实利用路径:Prime+Probe 打 L1 缓存,攻击者反复填充并测量自己的缓存行被谁挤出,就能还原受害者的内存访问模式(偷密钥的经典手法);PortSmash 利用执行端口竞争,通过测量自己指令的完成时间推断对端线程在用哪个端口、跑什么操作;L1TF、MDS 这批 2018 年前后的 CPU 漏洞更是让 OpenSSL 这类库直接建议"要么关 HT,要么别让不受信代码和敏感代码共核"。
业界的缓解手段因此分两条腿:一是内核做 core scheduling(核心调度),保证一个物理核上的两个逻辑核只跑互相信任的线程(同进程或同安全域);二是敏感场景直接 nosmt。这也是为什么公有云对"专属物理核"实例要收溢价——那等于把 SMT 侧信道从根上拔掉。
对普通开发者,侧信道这节最实际的启示有两条。第一,处理密钥、令牌这类敏感数据的进程,避免和不受信代码调度到同一物理核——容器环境里可以用 cpuset 把敏感 Pod 独占整核(连兄弟逻辑核一起圈走)。第二,评估供应商的"vCPU"时留个心眼:一个 vCPU 通常只是一个逻辑核,也就是半个物理核,两个 vCPU 的"邻居"可能挤在同一个核上和你抢执行端口。延迟敏感业务要么买独占核实例,要么自己在 guest 里按拓扑绑核。
六、和其他多线程方案的边界
SMT 常和两个邻居概念混淆,值得划清界限。粗粒度多线程(coarse-grained MT)只在长停顿(如缓存 miss)时才切换线程,同一拍内永远只有一个线程在发射——硬件简单得多,但填不满短停顿,上世纪的不少嵌入式核走这条路线。多核(CMP)则是完整复制整个核,线程间只共享末级缓存和内存,隔离性和扩展性都好,代价是面积和功耗翻倍。SMT 位于两者之间:用大约 5% 的额外面积换 20%~30% 的吞吐,是当时性价比最高的一档——这也是它在通用服务器 CPU 里胜出的原因。理解这个谱系有助于判断:当 SMT 收益不够时,下一步该加核(更多物理核)而不是加线程数(SMT4 的边际收益递减已经在前面算过账了)。
这一篇在知识体系里的位置
本篇是 concepts/microarch 乱序执行系列的延伸:单核内部机制见 cpu-out-of-order、reservation-station、rob——SMT 共享的正是这些部件;性能分析视角见 ipc-bottlenecks;想理解 SMT 共享的缓存层级细节,可以接着读 cpu-microarch-overview。多核层面的调度与绑核话题则属于 concepts 调度线,本篇不展开。
总结
SMT 超线程只复制架构状态、静态切半乱序缓冲、动态共享执行单元与缓存,用一个物理核的空窗去填另一个线程的停顿——对停较多的服务类负载能白捡 20%~30% 吞吐,对计算密集或缓存敏感的负载可能倒贴;而"共享即泄漏"让它成为侧信道重灾区,安全和低延迟场景该关就关。