x86 串行化指令代价:CPUID/IRET/序列化边界拖慢流水线的真实账单
承 rdtsc-invariant-tsc-sync 对时间戳读取的讨论,以及 fence-memory-barrier-cost 对内存屏障开销的分析。本篇聚焦另一类「让 CPU 慢下来」的边界:x86 串行化指令。它们不只为内存排序,而是把整条乱序流水线按暂停键——代价远比一条 LFENCE 大。
本文要回答的问题
- 什么是 x86 串行化指令?它们与内存屏障(fence)差在哪一层?
- CPUID 为什么成了「测量标配」?一次 CPUID 到底花多少周期?
- 流水线被串行化指令「清空」时,硬件里具体发生了什么?
- IRET、MOV CR3、WRMSR 这些特权路径上的串行化代价有多大?
- 做微基准测试和写内核热路径时,怎么避开或正确使用串行化指令?
一、串行化与屏障:两个层级的「停」
内存屏障(MFENCE/LFENCE/SFENCE)约束的是内存访问的可见顺序,流水线本身照常跑——后面的整数加法该发射还是发射。串行化指令(serializing instruction)狠得多:它要求执行到它时,前面所有指令必须彻底退休(retire),后面的指令必须等它完成后才能开始执行,效果等价于把乱序窗口整个放空、把取指/解码/重命名全部重启。
x86 手册里点名的串行化指令主要这几类:
- CPUID:唯一一条用户态可触发的完全串行化指令;
- IRET / IRETD:中断返回,特权级与栈上下文整体切换;
- MOV CR0/CR2/CR3/CR4/CR8、MOV DR:写控制寄存器、调试寄存器,可能改变分页与特权语义,必须串行化;
- WRMSR:写模型专用寄存器;
- INVD、WBINVD、INVLPG:缓存/TLB 维护类指令,天然要求机器状态稳定。
注意 RDTSC 本身不是串行化指令——它可能在流水线里提前执行,这正是为什么测量代码要用 CPUID 或 RDTSCP 夹住它,细节见 rdtsc-invariant-tsc-sync。
二、CPUID:测量者的代价
CPUID 的本职是查询 CPU 特性位,但因为「用户态 + 完全串行化」这个独特组合,它成了微基准测试的事实标准工具。典型用法:
// 测前:把流水线排空,保证计时起点干净
asm volatile("cpuid" :: "a"(0) : "ebx","ecx","edx","memory");
uint64_t t0 = rdtsc();
// 被测代码
uint64_t t1 = rdtscp();   // RDTSCP 自带部分串行化
asm volatile("cpuid" :: "a"(0) : "ebx","ecx","edx","memory");
代价账是这样的:一次 CPUID leaf 0 在现代 Intel/AMD 上大约 30-100 周期,但这只是指令本身的执行时间。真正的隐性成本是流水线清空的间接损失——乱序窗口(ROB,现代核 200-500+ 项,见 rob-size-ooo-window)里正在飞的指令全部等退休,分支预测积累的上下文被刷新,重新填满窗口又要几十到上百周期。所以一段「理论上 5 周期」的代码,用 CPUID 夹着测,读数往往是 50-200 周期——你测到的是串行化边界 + 被测代码,不是被测代码本身。
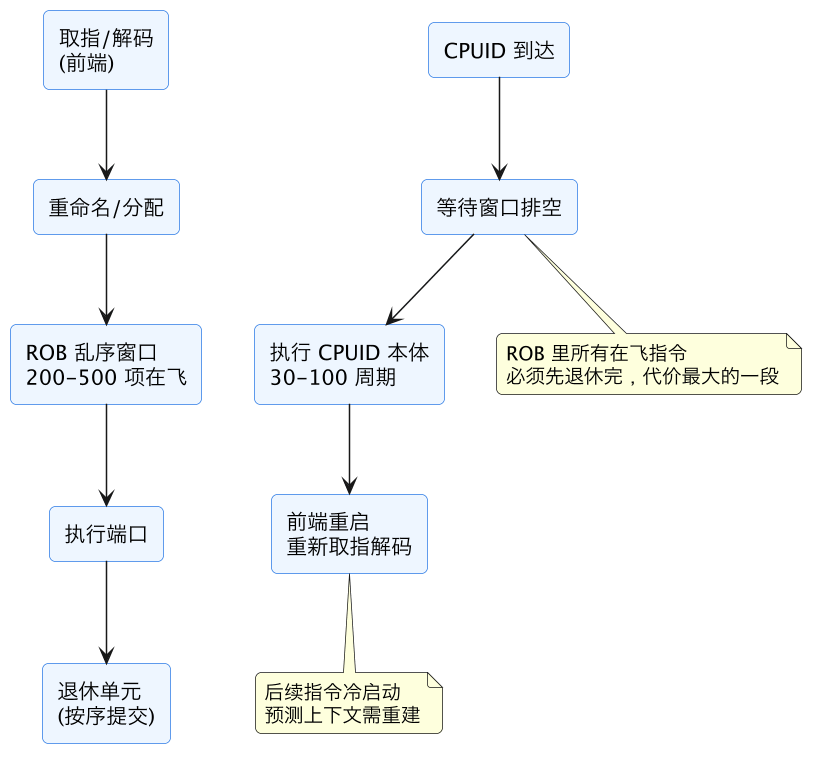
图里 drain 那一段是大头:窗口越深(IPC 越高、在飞指令越多),排空越久。这也是为什么同一条 CPUID,在空转循环里测是 40 周期,在高 IPC 的密集计算里「体感」能到 200+ 周期。
三、特权路径上的串行化:IRET 与 MOV CR3
内核开发者更常撞上的是另外几条。
IRET:每次系统调用/中断返回用户态都要走一次。IRET 要恢复 RIP/CS/RFLAGS/RSP/SS 五个寄存器,检查特权级切换,且完全串行化——典型开销 50-300 周期,开 KPTI 的页表切换场景更贵,见 kpti-pcid-microarch-cost。这就是为什么 vsyscall/vDSO 要把 gettimeofday 这类高频调用做成纯用户态:省掉的就是进出内核这一对「系统调用进入 + IRET 返回」的串行化边界。
MOV CR3(切页表):写 CR3 切换地址空间,本身串行化并隐式刷掉非全局 TLB 项。没开 PCID 时每次切换 TLB 全刷,后续页表遍历全是 miss;开 PCID 后 TLB 可以按进程标签保留,MOV CR3 的代价从「上千周期的隐性 TLB 重建」降到接近指令本身。
WRMSR:内核调频、配 PMU、写 APIC 寄存器都用它,单次 30-100+ 周期且串行化。虚拟化下更糟——大部分 MSR 写会触发 VM-exit 下陷到 hypervisor,开销直接跳到几千周期,见 vmexit-cost-microarch。
| 指令 | 特权级 | 典型代价(周期) | 隐性成本 |
|---|---|---|---|
| CPUID leaf 0 | 用户态 | 30-100 | 排空 ROB + 前端重启 |
| IRET(中断返回) | 内核 | 50-300 | KPTI 下含页表切换 |
| MOV CR3(无 PCID) | 内核 | ~100 | TLB 全刷,后续 miss 雪崩 |
| MOV CR3(有 PCID) | 内核 | ~50-100 | 仅本进程 PCID 上下文 |
| WRMSR | 内核 | 30-100 | 虚拟化下 VM-exit 数千周期 |
| WBINVD | 内核 | 数百-数千 | 全缓存回写 |
四、一个可复现的测量实验
想亲手感受串行化边界的分量,可以做一个三组对照实验(Linux 下 gcc 直编即可):
第一组:裸 RDTSC 夹空气。 t0=rdtsc(); t1=rdtsc(); 循环十万次取最小值,典型读数 20-30 个 TSC 周期——这是两条 RDTSC 背靠背在流水线里擦肩而过的开销,几乎没有任何串行化。
第二组:CPUID 夹空气。 两条 CPUID 夹着一对 RDTSC,同样取最小值,读数跳到 80-200 周期。多出来的就是 CPUID 排空窗口、前端重启的成本——注意这里「被测代码」明明是零。
第三组:CPUID 夹一段真实计算。 比如十次整数乘法(理论 ~30 周期)。读数往往只比第二组多一点点,甚至落在噪声里——因为排空成本是固定的,被测代码被「淹没」在串行化边界里了。
这个实验的教训直接改写微基准方法论:被测代码越短,串行化边界引入的系统误差占比越大。测 5 周期的指令延迟,光边界就贡献 100+ 周期,数据毫无价值;测 5000 周期的函数,边界的 100 周期只占 2%,可以接受。所以业界测短指令延迟从来不用「夹」的办法,而是用依赖链法:让被测指令自己串成长链(add rax,1 重复一万次,每次依赖上一次的结果),整段测一次再除以一万——串行化边界只出现两次,被摊到忽略不计。Agner Fog 的指令延迟表、uops.info 的数据都是这么来的。
另一个容易踩的坑是 CPUID 的 leaf 差异:leaf 0( vendor 串)最便宜,leaf 4(缓存拓扑)、leaf 0x1F(扩展拓扑)因为要遍历内部结构会贵几倍,leaf 0x80000008 之类还可能在部分微架构上触发微码辅助。写测量脚手架时固定用 leaf 0,别随手换个 leaf 就把基线测歪了。
五、工程上的三条守则
第一,微基准别滥用 CPUID。测纳秒级代码段时,用「测整段 N 次再除 N」的统计法,或用 RDTSCP + LFENCE 的轻量组合,把串行化成本摊薄到噪声以下。
第二,内核热路径减少无谓的控制寄存器写。能读出来的值先比对再写(if (old != new) write_cr3(new)),一次条件跳过就省下整轮串行化加 TLB 重建。
第三,PMU 采样代码路径要意识到 WRMSR 成本。perf 中断处理里重编程计数器是一串 WRMSR,高频采样下这部分开销本身会扭曲被测程序,相关讨论见 perf-counter-pmu-programming。
还有一条给虚拟化场景:不要把 CPUID 当「便宜的特性探测」放进热路径。云环境里 CPUID 通常不触发 VM-exit(hypervisor 直接模拟),但有些 leaf 会被拦截,一旦下陷就是几千周期;特性探测结果启动时缓存一次,之后全程查缓存。
这一篇在知识体系里的位置
本篇是 fence-memory-barrier-cost 的「加强版」姊妹篇:屏障管内存序,串行化指令管整条流水线。时间戳测量侧接 rdtsc-invariant-tsc-sync,系统调用/虚拟化代价侧接 kpti-pcid-microarch-cost 与 vmexit-cost-microarch,乱序窗口背景见 cpu-out-of-order。
总结
x86 串行化指令的本质是「把乱序流水线彻底放空再重启」——CPUID 一次几十周期只是表象,排空 ROB 与前端重启的隐性代价才是大头;测量时别把串行化成本算进被测代码,内核热路径能躲一次 MOV CR3/WRMSR 就躲一次。