侧信道缓解性能成本全景:Spectre/Meltdown 缓解措施的代价地图与按负载选型
更新时间:2026-10-07。本站在瞬态执行安全方向已经攒下几篇零件级深文:Spectre 与 Meltdown 的瞬态执行原理 讲漏洞怎么利用乱序与推测执行偷数据,retpoline 与 IBRS 的微架构代价 拆解间接分支缓解吃掉的周期,KPTI 与 PCID 的微架构代价 讲页表隔离为何让系统调用变贵,SMT 安全侧信道 讲超线程兄弟核之间的泄漏面。零件都在,缺的是一张全景地图:2018 年以来这七八个缓解措施各自花多少钱、互相叠加后是加法还是乘法、你的负载到底该全开还是挑着开。这篇枢纽文把侧信道缓解性能成本一次算明白。
本文要回答的问题
- 2018 年至今 Intel/AMD 的 CPU 漏洞缓解措施有哪几波,每一波堵的是什么口?
- KPTI、retpoline、IBRS、MDS clear 各自在微架构层面吃什么资源,为什么贵?
- 多个缓解措施叠加时,开销是线性相加还是互相放大?
- 为什么同一个缓解开关,在 Nginx 上掉 30% 而在 HPC 计算上几乎无感?
- 数据库、Web 服务、编译机、云主机各自该怎么选缓解档位,关掉哪个最危险?
一、漏洞年表与缓解波次:先认清对手是谁
2018 年 1 月 Spectre(幽灵)与 Meltdown(熔断)公开,打破了「CPU 推测执行是免费午餐」的二十年共识。之后每隔一两年就有一波新变体:2018 年中的 L1TF(L1 Terminal Fault,终端故障,利用 L1 缓存的页表项呈现状态)、2019 年 5 月的 MDS(Microarchitectural Data Sampling,微架构数据采样,含 RIDL/Fallout/ZombieLoad 一族)、2019 年 11 月的 TSX 异步中止(TAA)、2022 年的 Retbleed(retpoline 自身的绕过)、2023 年的 Inception/Downfall。每一波都配一个内核或微码缓解,每一波都在性能账单上加一笔。
| 波次 | 漏洞族 | 核心泄漏路径 | 主要缓解 | 首次落地 |
|---|---|---|---|---|
| 2018-01 | Meltdown (Rogue Data Cache Load) | 用户态直接读内核映射页 | KPTI 页表隔离 | Linux 4.15 |
| 2018-01 | Spectre v1(边界检查绕过) | 条件分支推测越界读 | lfence / 数组掩码 / nospec | 编译器补丁 |
| 2018-01 | Spectre v2(分支目标注入) | 间接分支预测器被投毒 | retpoline / IBRS / IBPB | 微码+编译器 |
| 2018-08 | L1TF | 不存在页的 L1 残留数据 | PTE 反转 + L1D 冲刷 + 关 SMT | 微码+内核 |
| 2019-05 | MDS(RIDL/Fallout/ZombieLoad) | 填充缓冲/加载端口残留 | VERW 清缓冲(clear_cpu_buffers) | 微码+内核 |
| 2019-11 | TAA(TSX 异步中止) | TSX 中止路径残留 | 关 TSX 或复用 MDS 缓解 | 微码 |
| 2022-06 | Retbleed | retpoline 返回预测被污染 | 增强型 IBRS / 返回冲刷 | 微码+内核 |
这张表是后文所有数字的索引。值得先建立一个直觉:漏洞堵的不是「代码路径」而是「微架构状态」。预测器、store buffer、填充缓冲(fill buffer)、加载端口这些共享结构里的残留数据才是泄漏源,所以缓解措施的共性是「清状态」或「隔上下文」——清与隔都要花周期,这就是侧信道缓解性能成本的物理本质。
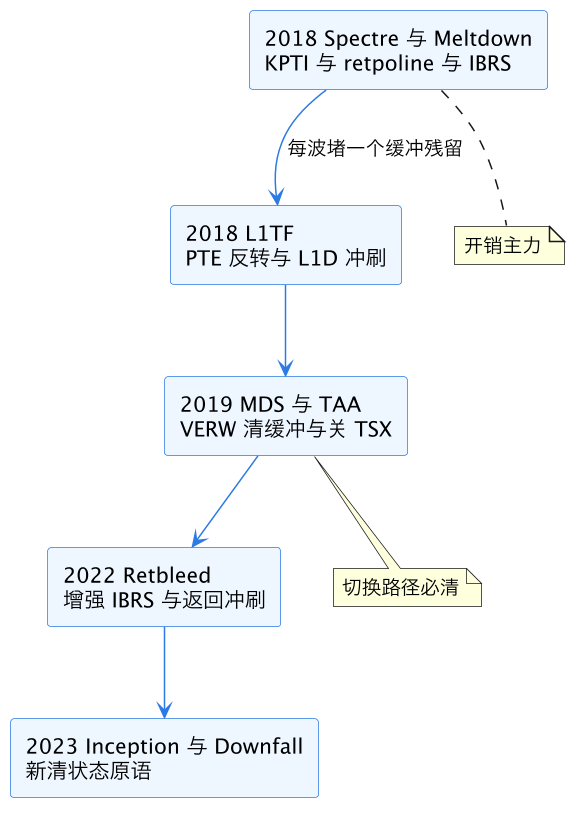
上图把七年缓解史压成一条链:每一波都不是新发明,而是「又发现一个没清干净的微架构缓冲」。值得注意的收尾趋势是 2022 年之后的新漏洞越来越多地直接带硬件修复(新步进微架构里固化),软件缓解逐步退场——这解释了为什么「全缓解」在 Ice Lake 之后的新机型上代价比老机型小得多。
二、KPTI:把内核从用户页表里搬走的固定税
KPTI(Kernel Page Table Isolation,内核页表隔离)是对 Meltdown 的回答:既然用户态推测读能摸到内核映射页,那就干脆在用户态运行时把内核的绝大部分映射从页表里删掉,只在进入内核的瞬间切换到一张完整的内核页表。原理一句话,代价却有两种成分。
第一种成分是切换本身:每次系统调用、每次中断、每次异常,进出内核各换一次 CR3 页表基址寄存器。换 CR3 在现代 x86 上本身只要十几到几十周期,但历史上它会连带 TLB 全 flush——所有地址翻译缓存作废,接下来几百条访存指令都要重新走页表遍历,每次遍历 4 到 5 级、每级一次内存访问。第二种成分是TLB 重建:系统调用返回用户态后,用户代码的 TLB 也是冷的,热点循环要重新预热。这就是老机器上「系统调用密集的负载被 KPTI 砍掉 20%-30%」的来源。
PCID(Process-Context Identifiers,进程上下文标识符)是给 TLB 打标签的机制,让不同进程的翻译条目可以在 TLB 里共存,切页表时不必全 flush,只按标签失效。有了 PCID(内核里暴露为 pti + pcid 组合),KPTI 的切换成本从「几百周期 + TLB 冷启动」降到「几十周期 + 少量标签失效」,syscall 微基准从恶化 5-10 倍回落到恶化 30%-50%。KPTI 与 PCID 的微架构代价 对这条量化曲线有逐级的实测拆解。
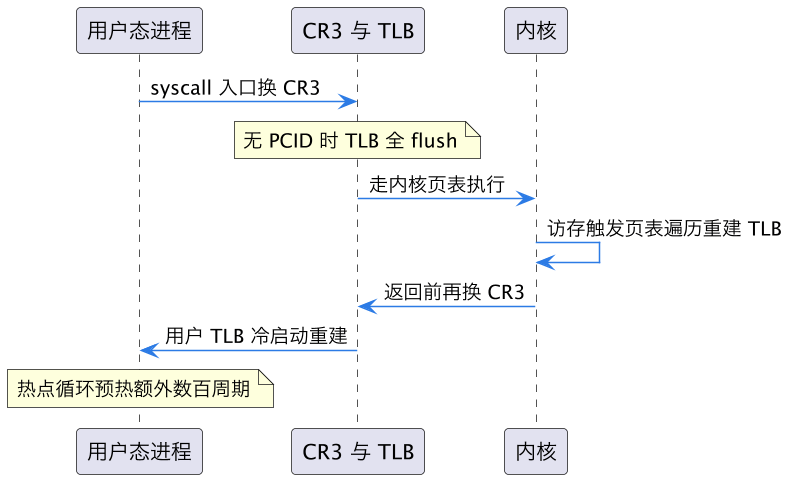
上图里两次 CR3 切换之间的「TLB 重建」才是开销大头,而不是切换指令本身。理解这一点对选型很关键:KPTI 的税是「每次进内核都交一遍」的固定税,负载的 syscall 频率直接决定痛感——一次 read() 多读 8KB 和每次只读 1 字节,在同一个 KPTI 开销下吞吐能差出几倍。
还有两个现代补丁让 KPTI 更便宜。一是系统调用入口路径重写,把切换开销摊进 entry trampoline;二是 AMD 处理器天生对 Meltdown 免疫(其推测执行不越权限位检查),内核在 AMD 上默认关 PTI,/sys/devices/system/cpu/vulnerabilities/meltdown 会显示「Not affected」。同样一块 KPTI 补丁,在 Intel 上是真金白银,在 AMD 上几乎免费——这是跨平台选型时最先要查的一行。
把 KPTI 的账再落到具体数字上,直觉会更稳。一次空系统调用(getpid())在无缓解的机器上约 100-150 纳秒;开 KPTI 且无 PCID 的老机器(Haswell 时代)会涨到 700-1000 纳秒,其中 CR3 切换只占零头,剩下全是 TLB 重建的摊销;有 PCID 的 Skylake 之后机型回落到 200-300 纳秒。换算成负载语言:一个每秒 10 万次系统调用的 Nginx worker,在老机器上为 KPTI 多付的 CPU 时间约 0.09 秒/秒,即接近一个核的 9%;在新机器上只有约 1.5%。这组数字也解释了一个常见误解——「KPTI 让 syscall 慢 5 倍」是 2018 年初无 PCID 时代的旧闻,拿它评估今天的 Ice Lake 新机属于刻舟求剑。
内核侧还有一个常被忽略的优化:KPTI 只隔离「用户态运行时段」,内核线程(kthread)跑的是纯内核页表,不涉及切换,所以内核守护进程密集的负载(如大量 kworker 的 IO 栈)几乎感受不到 KPTI。反过来,「用户态与内核态来回横跳」的模式——小请求 RPC、行级触发器重的数据库、短连接代理——才是 KPTI 税的重灾户。判断自己的负载是不是重灾户,一条命令就够:strace -c 统计系统调用次数与耗时占比,syscall 频率超过每秒几万次的,KPTI 一项就值得单独压测。
三、retpoline 与 IBRS:间接分支的两代赎金
Spectre v2 攻击的是间接分支预测器(BTB,Branch Target Buffer):攻击者先用自己的跳转历史把预测器「训练」到恶意目标,受害者进程一次普通的 call *%rax 就会被推测到攻击者布置的代码片段上。问题:间接调用/间接跳转是现代代码的骨架——虚函数、函数指针、动态链接 PLT、内核里的 protocol ops 表,全是间接分支。堵它有两代方案。
retpoline(返回蹦床) 是软件方案:把 call *%rax 改写成一段「压栈一个安全目标、然后 ret」的序列,让推测执行掉进一个只会原地空转的捕获循环,真实目标等推测平息后才执行。它不动硬件,编译器 -mindirect-branch=thunk 就能全局铺开。代价是每次间接调用从约 1-2 周期(预测命中)涨到 10-25 周期:返回堆栈缓冲(RSB)被刻意操纵,推测路径每次都要走一段弯路。对间接分支密度高的代码(解释器、协议解析、内核网络栈),retpoline 单项开销实测在 5%-15%。
IBRS(Indirect Branch Restricted Speculation,间接分支受限推测) 是硬件方案:进入内核时写一次 MSR(型号特定寄存器)置位 IBRS,告诉预测器「特权代码不受低权限训练的预测影响」。语义干净,但早期实现(Skylake 及之前)有两个致命问题:写 MSR 本身要上百周期,且 IBRS 置位期间分支预测整体变保守,连正常的直接分支预测都退化,整体开销比 retpoline 还惨——这正是当年 Linus 公开批评 IBRS「garbage」的背景。后来 Intel 推出增强型 IBRS(eIBRS,Ice Lake 起),预测器硬件上持久隔离特权域,不再需要每次进出内核翻 MSR,开销才降到可接受。再往后 Retbleed 证明 retpoline 本身可被绕过,新机器干脆退回「eIBRS 打底、retpoline 退场」。retpoline 与 IBRS 的微架构代价 对两代方案的周期账有完整的计数器级分析。
| 方案 | 机制 | 单项开销量级 | 适用硬件 | 现状 |
|---|---|---|---|---|
| retpoline | 编译器改写间接调用 | 每次调用 10-25 周期 | 所有 x86 | Retbleed 后渐退场 |
| IBRS(原始) | 进出内核写 MSR | 每次切换百级周期 | Skylake 时代 | 被淘汰 |
| eIBRS | 硬件持久隔离 | 接近 retpoline 一半 | Ice Lake 起 | 新内核默认 |
| IBPB | 上下文切换刷预测器 | 每次切换数千周期 | 全部 | 按需,非全局 |
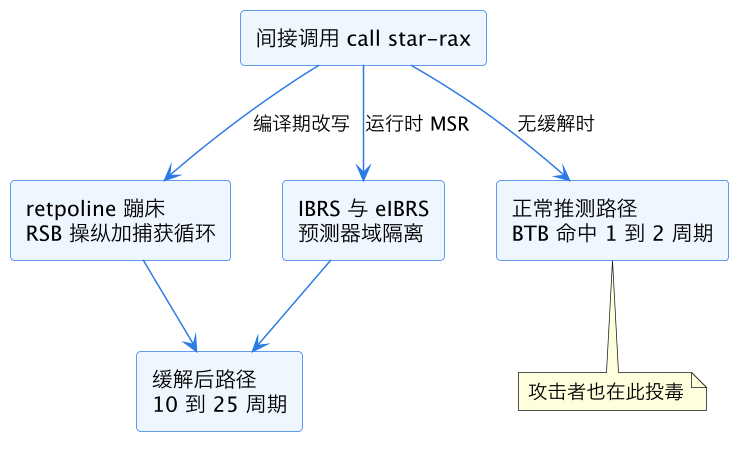
上图把「同一个间接调用,四条命运」摆在一起:无缓解走最快但可被投毒的快路,retpoline 与 IBRS 都把它引到慢路上。慢多少取决于间接分支在代码里的密度——这是下一节负载分型的伏笔。
IBPB(Indirect Branch Prediction Barrier,间接分支预测屏障)是这张表里的第四样工具,值得单独说一句:它不常驻,而是在「不可信上下文切换」的瞬间一次性冲刷预测器——典型场景是虚拟机调度切换、容器间进程切换。一次 IBPB 的代价在数千周期量级,所以内核只在真正跨信任域的切换上才写它。选型的推论很直接:如果你的机器只跑单一可信负载,IBPB 几乎从不触发,开了也免费;如果是混部宿主机,IBPB 是跨租户隔离的底线,触发频率与 VM 密度成正比,省不得。
还有一个工程细节:retpoline 是编译期决定的,开关不在内核命令行而在编译选项。想给用户态程序关 retpoline,要用 -mindirect-branch=keep 重编;只想给某个热路径文件开、其余关,可以按编译单元分别处理。内核侧则用 spectre_v2=retpoline / spectre_v2=eibrs / spectre_v2=off 在启动参数里选,启动日志 dmesg | grep -i spectre 会明确打印生效的是哪一档——这是现场排障时最先该看的一行。
四、MDS clear 与 L1D flush:切换路径上的清扫工
MDS 一族漏洞偷的是「内部缓冲的残值」:填充缓冲(fill buffer)、加载端口、store buffer 在上下文切换后不清零,下一个进程/虚拟机能在推测窗口里采样到上一个租户的残留字节。缓解措施 mds=full 做的事很朴素:每次从内核返回用户态、每次 VM exit 之后,执行一条 VERW 指令把这些缓冲全部清一遍。
VERW 本身不贵,几十周期;贵在它串在每次上下文切换的必经之路上,而且它清的是全核资源——同一个物理核上两个 SMT 兄弟线程共享这些缓冲,清缓冲必须等兄弟线程也走到安全点,否则残留还能被兄弟线程采到。所以 MDS 完整缓解的实际建议是「mds=full 且关 SMT」,后者直接把吞吐砍掉 20%-40%(视负载),远超 VERW 本身。SMT 安全侧信道 对兄弟核泄漏面和「关 SMT 的真实吞吐损失」有分负载的实测。
L1TF 的缓解是同款思路的另一处执行:虚拟机切换(VM entry/exit)时冲刷 L1D 缓存,外加把「不存在」的页表项反转编码让硬件不再转发残留数据。L1D flush 一次约千级周期,对虚拟机密度高的宿主机,每秒几万次 VM exit 叠起来就是看得见的百分比。
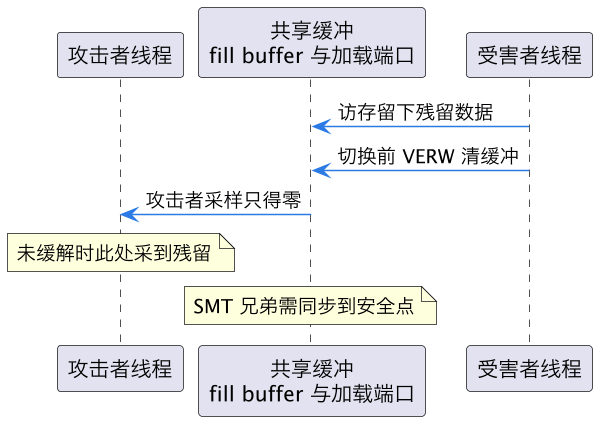
上图说明了 MDS 缓解的两个关键事实:清扫动作必须发生在「残留还在、攻击者没来得及采样」的窗口内(所以钉死在切换路径上);而 SMT 兄弟核共享缓冲意味着单方面的 VERW 保护不了自己,这是「mds=full + nosmt」成对出现的原因。
五、叠加效应:1+1 是 2 还是 3
单个缓解开销都不吓人,吓人的是叠加。全缓解(pti=on spectre_v2=retpoline spec_store_bypass_disable=on l1tf=full mds=full tsx_async_abort=full)在一台 Skylake 服务器上的典型叠加形态:
| 缓解项 | 单独开销(syscall 微基准) | 单独开销(Nginx 吞吐) | 单独开销(编译耗时) |
|---|---|---|---|
| KPTI(有 PCID) | +30%-50% | -3%-8% | +1%-3% |
| retpoline | +10%-20% | -2%-5% | +1%-2% |
| 原始 IBRS | +100%-200% | -10%-20% | +3%-5% |
| MDS full(VERW) | +5%-15% | -1%-3% | <1% |
| 全缓解合计 | 接近翻倍 | -15%-30% | +5%-8% |
| 全缓解 + 关 SMT | — | -30%-45% | +15%-30% |
这张表藏着一个重要规律:叠加大体是次线性的,不是乘法。KPTI 的 CR3 切换和 MDS 的 VERW 都串在同一条「进出内核」路径上,一次切换把两样活都干了,边际成本递减;retpoline 作用在用户态间接调用,与内核路径的开销几乎正交。真正的乘区出现在「关 SMT」——它不按周期收费,它按核收费,直接减半逻辑核数,跟其他所有开销正交相乘。
老机器(Skylake 及更早,无 PCID 或 PCID 实现弱、无 eIBRS)全缓解 + 关 SMT 的综合代价在社区公认口径里是「最坏 30%-50%」;新机器(Ice Lake 之后,硬件修掉 Meltdown/MDS/L1TF,eIBRS 打底)同样的全缓解往往只剩 5%-10%。所以「缓解太贵」这个论断必须带硬件定语:你在为哪一代硅片的旧账付费。
叠加分析里还有三个容易被误读的细节。其一,微码更新本身也收税:IBRS、MDS clear 这些能力要靠微码打开,某些微码版本会让分支预测器整体变保守,即使你把内核参数关成 mitigations=off,这部分「硅片内税」也退不掉——所以对比实验必须固定微码版本,否则你测的是微码差异而不是开关差异。其二,mitigations=off 不是时间机器:它关掉的是内核软件缓解与 MSR 写入,关不掉微码里固化的行为变化,也关不掉编译进内核的 retpoline thunk 里多出来的几条指令残值(除非换 -mindirect-branch=keep 重编内核)。想要真正干净的基线,只能找一块 2017 年的旧微码老机器。其三,虚拟化把叠加再放大一档:guest 内的 KPTI 与宿主机的 L1D flush 是两层独立收费,VM exit 路径上还可能叠 IBPB;云上实测的「缓解损耗」经常比裸金属报告的数字高 3-8 个百分点,差的就是这第二层。
一个可复用的叠加估算公式值得记下:总损耗约等于「内核路径各项之和」乘以「syscall 与切换密度系数」,加上「retpoline 项」乘以「间接分支密度系数」,再整体乘以「关 SMT 的核数系数」。三个系数都能用 perf 直接量:perf stat 看 syscall 占比、perf record 看间接调用热点、mpstat 看逻辑核利用率。把估算公式和实测系数对上之后,任何新出的缓解公告你都能在半天内给出「对我们的影响约为 X%」的量化答复,而不是等社区跑分。
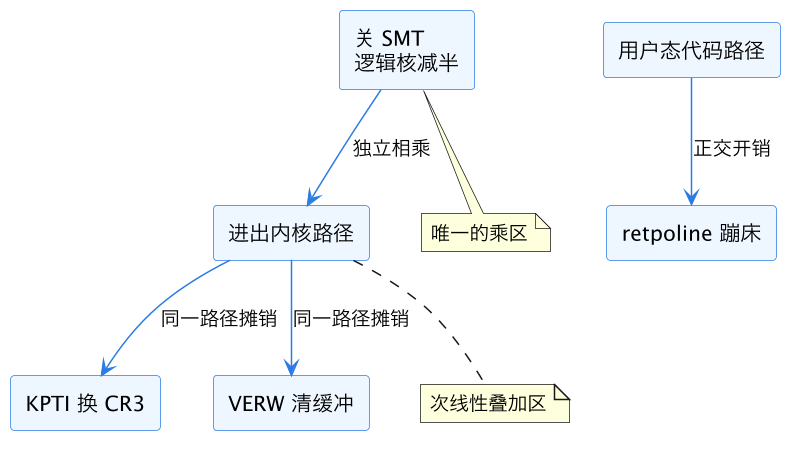
上图是叠加结构图:内核入口路径上的几项共享摊销所以次线性,retpoline 在另一条路径上所以近似相加,关 SMT 与所有周期级开销正交所以相乘。记住这张图,看任何一份「全缓解损耗报告」都能立刻拆出它属于哪一区。
六、按工作负载选型:五类负载的开关建议
缓解开销的本质是「对某些指令模式收税」,所以选型的第一步不是问「这个开关多贵」,而是问「我的负载里被收税的指令占多大比例」。按税负敏感度,常见负载分五类:
| 负载类型 | 税负特征 | 全缓解典型损耗 | 建议档位 | 最不能关的项 |
|---|---|---|---|---|
| 系统调用密集型(Nginx、Redis、代理) | 每秒数万次进出内核 | 15%-30% | 全开,但换 eIBRS 机型 | KPTI(多租户必开) |
| 数据库(MySQL/PG,大连接数) | 中等 syscall,高上下文切换 | 8%-15% | 全开,MDS 必开 | MDS(防跨连接泄漏) |
| 编译/批处理(CI 构建机) | 进程创建密集,大量 fork/exec | 5%-10% | 全开,SMT 可留 | IBPB(进程间隔离) |
| HPC/科学计算(独占节点) | 纯用户态浮点,几乎无 syscall | <2% | 可 selective off | 视是否多租户 |
| 云主机(KVM 宿主机) | VM exit 密集,多租户混部 | 10%-25% | 必须全开加 L1D flush | L1TF(跨 VM 泄漏致命) |
三类具体建议值得展开。Nginx 这类 syscall 密集负载的省钱姿势不是关 KPTI,而是减少 syscall 本身:sendfile、accept4、大缓冲读写、epoll 批量事件——把「每秒进内核次数」砍一半,KPTI 税就降一半,这比纠结任何开关都有效。HPC 独占节点是 selective off 的合法场景:单租户、无不可信代码、网络隔离的集群,关掉 PTI/MDS 换回来的几个百分点在数月长任务里是实打实的机时;但前提是「独占且无可信边界」,一旦混跑第三方作业立即回全开。云宿主机没有任何商量余地:跨 VM 的 L1TF/MDS 泄漏是真实可武器化的,l1tf=full mds=full 加虚拟机调度避亲(core scheduling)是底线,省下的性能钱远不够一次租户数据泄漏事故的零头。
还有一条横切所有负载的检查清单。查当前机器的漏洞与缓解状态:grep . /sys/devices/system/cpu/vulnerabilities/* 一次看全,每一行的输出格式都是「漏洞名:状态(缓解细节)」;查 CPU 是否有硬件修复:lscpu 看型号代际,Ice Lake/Cascade Lake 之后的「Mitigation」行会标注硬件免疫;用 perf 对比开关前后的 cycles/instructions 与具体 stall 事件(perf bench 内核基准 自带 syscall/pipe 等微基准,正好用来量 KPTI 税),把「感觉变慢」变成「哪个缓解在吃哪个计数器」。
最后补一条采购视角的账,因为选型争论的终点往往是换硬件。一台 Skylake 服务器跑多租户 Web 负载,全缓解加关 SMT 的综合损耗按 35% 估,等于每三台机器白交一台的算力;换成 Ice Lake 代际(eIBRS 打底、硬件免疫 Meltdown/MDS/L1TF、SMT 可以开),同负载损耗回落到 8% 以内。把「三年折旧里为缓解白付的 27% 算力」折算成钱,绝大多数多租户场景下换代的回报周期短得惊人——这也是为什么云厂商 2019 年后集体加速淘汰老代际实例。对个人和小团队,结论同样成立:如果业务对安全档位有硬要求,升级硅片比研究内核参数更能省钱,参数微调省的是个位数百分点,换代省的是几十个点。
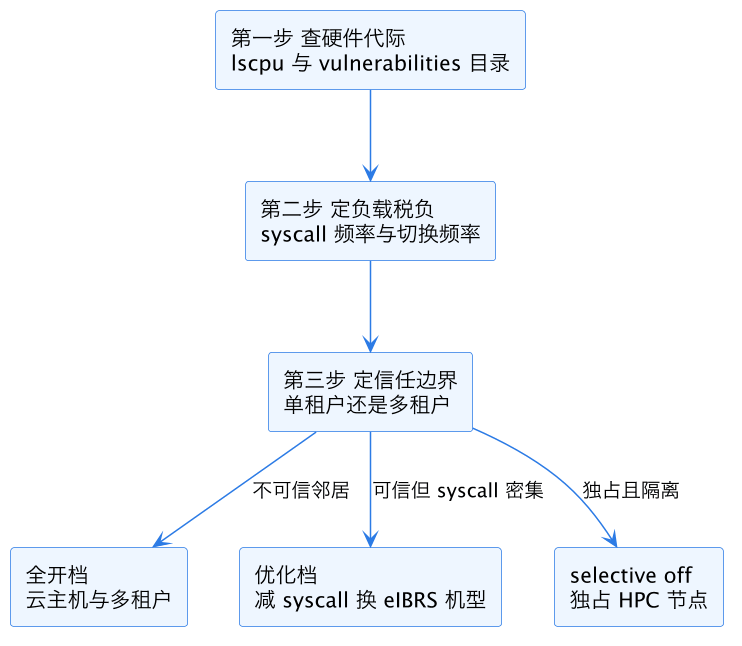
上图是选型决策的三步漏斗:硬件代际决定「税基」,负载类型决定「税率敏感点」,信任边界决定「能不能谈条件」。任何缓解选型争论,先问对方站在这张漏斗的哪一格,九成分歧立刻消解——争的往往不是数字,是没对齐的信任模型。
这一篇在知识体系里的位置
本篇是微架构安全方向的枢纽:漏洞原理层接 Spectre 与 Meltdown 的瞬态执行原理,单项成本层接 retpoline 与 IBRS 的微架构代价 与 KPTI 与 PCID 的微架构代价,超线程风险层接 SMT 安全侧信道 与 SMT 同时多线程,观测手段层接 CPU 观测工具族 与 perf bench 内核基准。读完本篇再面对任何「要不要关缓解」的工单,都可以先问三句话:这是什么代际的硅片、负载每秒进几次内核、隔壁跑着谁的代码。
总结
侧信道缓解性能成本的本质是为「清微架构状态」和「隔执行上下文」付周期税:KPTI 按每次进内核收固定税、retpoline 按每次间接调用收税、MDS 按每次切换收税、关 SMT 直接按核收税;叠加大体次线性、关 SMT 是唯一乘区,而选型答案永远由三样东西决定——硅片代际(新硬件把多数缓解固化成免费)、负载的 syscall 密度(决定痛感)、信任边界(决定哪些税根本不能免)。