缓存包含性:inclusive、exclusive、non-inclusive 三种 L2/L3 组织怎么选
在 缓存替换策略 里我们讨论过"单级缓存满了踢谁",在 写分配与写回策略 里讨论过"写 miss 怎么办"。这两篇都只看一级缓存。真实处理器有 L1/L2/L3 三级,级与级之间还藏着一个更根本的设计问题:同一行数据能不能同时躺在好几级里? 这就是缓存包含性(cache inclusiveness)要回答的问题,它直接决定了监听过滤、替换行为和有效容量。
本文要回答的问题
- 缓存包含性的三种组织——inclusive、exclusive、non-inclusive——各自是什么意思?
- 为什么 inclusive 的 L3 能当"监听过滤器",替 L1/L2 挡掉一致性流量?
- exclusive 组织如何把多级缓存容量"加满",又付出了什么代价?
- Intel 和 AMD 在真实产品里分别选了哪条路,为什么?
一、三种组织:一行数据能在几级里同时出现
先统一语境:以 L2(每核私有)和 L3(多核共享)这一层关系为例,L1 与 L2 之间同理。缓存包含性按"上级内容是否是下级的子集"分三类:
- inclusive(包含式):L3 包含 L2 的全部内容。任何一行只要在某核的 L2 里,L3 里必有它的一份拷贝。L3 是 L2 的严格超集。
- exclusive(互斥式):一行数据在整个缓存层级里只出现一次——要么在 L2,要么在 L3,绝不重复。L2 与 L3 的内容互不重叠。
- non-inclusive(非包含式,也叫 NINE):既不保证包含、也不强制互斥。一行可以在两级同时出现,也可以只在一级出现,硬件不做承诺。
一张图看懂三种组织下"行 X 的存在位置":
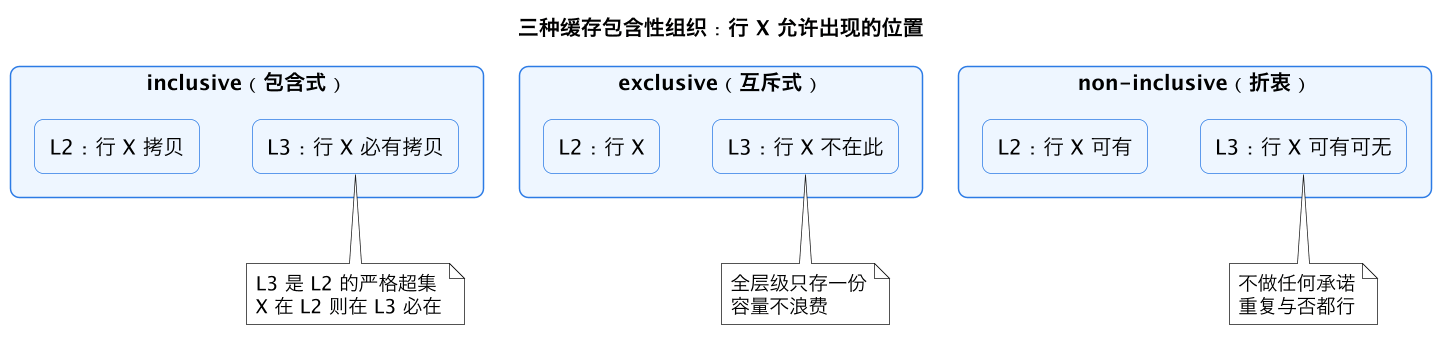
图里的关键对照:inclusive 下 L3 是"兜底大仓库",L2 里的东西它全有一份;exclusive 下两级像接力赛,行从 L2 踢出来才搬进 L3;non-inclusive 则是"随便",给硬件留最大自由度。三种选择没有绝对优劣,差别全在下面两笔账:一致性监听和有效容量。
二、inclusive 的红利:L3 当监听过滤器
多核系统里,每次某个核要读写一行,一致性协议(如 MESI,即修改/独占/共享/无效四态协议)都要确认其他核有没有这行的拷贝——这个动作叫监听(snoop)。如果每次监听都要去翻所有核的 L1 和 L2,一致性的互连流量和缓存端口争抢会随核数爆炸。
inclusive 组织给出了一招漂亮的减法:既然 L3 是所有私有缓存的超集,那么"L3 里没有"就等价于"任何核的 L1/L2 里都没有"。于是监听先到 L3 查 tag:
- L3 miss——直接判定全系统无人持有,各核私有缓存完全不用打扰;
- L3 hit——才需要去对应的 L1/L2 做反向确认(back-invalidation)。
实测负载里,大部分监听落在第一种情况——共享数据毕竟是少数。于是 inclusive 的 L3 相当于给所有私有缓存装了一道防火墙,把一致性流量挡在共享层。这也是为什么 L3 的 tag 阵列通常带一个"核存在位"(core valid bit),记录这行可能被哪些核持有,hit 时只去打扰那几核。
代价在哪?L3 驱逐一行时,必须把所有上级拷贝一并作废(这叫强制无效化)。如果 L3 踢掉一行正好是全核都在热用的共享代码,所有 L1/L2 跟着失效,下一拍全体 miss,性能瞬间塌方。L3 替换策略因此不能只看 L3 自己的访问热度,还得顾忌"这行在上级有多热"——这是 缓存替换策略 在 inclusive 层级上多出来的一层约束。
三、exclusive 的对价:容量加满,搬家繁忙
inclusive 的另一个隐形成本是容量浪费:L2 有 1MB、L3 有 8MB 且 inclusive,那么 L3 里相当一部分空间只是在"抄 L2 的作业",全系统真正装下的不同数据不到 8MB。exclusive 组织把这比浪费直接归零:一行只存一处,有效容量 ≈ 各级容量之和。
它的工作机制像接力:L2 miss 且行在 L3 里时,把行从 L3 搬进 L2,并从 L3 删掉(腾出位置);L2 驱逐一行(即使干净)时,把它"降级"写进 L3,充当 victim cache。这样 L2 踢出的旧行在 L3 里还有第二次被命中的机会。
| 维度 | inclusive | exclusive | non-inclusive |
|---|---|---|---|
| 有效容量 | L3(上级内容是重复) | L2 加 L3 之和 | 介于两者之间 |
| 监听过滤 | L3 miss 即免查私有缓存 | 无天然过滤器 | 可用目录近似实现 |
| L3 驱逐的连锁反应 | 上级拷贝强制失效 | 无(上级没有拷贝) | 视实现而定 |
| 行迁移流量 | 低 | 高(命中即搬家、踢出即降级) | 低 |
| 实现复杂度 | 中(反向无效化) | 中(victim 搬运) | 低 |
从表里能看出 exclusive 的两个软肋。一是没有天然的监听过滤器:L3 里没有不代表 L2 里没有,监听原则上要查所有级,多核下需要额外的目录结构补救。二是搬家流量大:每次 L3 命中都伴随一次"搬进 L2 加清出 L3 位置"的对调,互连带宽和能耗都上去。经典 AMD Athlon(K7/K8 时代)用的就是 exclusive L2,那是单核/双核时代,监听过滤不重要、容量寸土寸金,选 exclusive 很合理。
四、non-inclusive:现代大 L3 的现实选择
核数上去之后,两道约束开始打架:一致性流量需要 L3 继续当过滤器,但"严格超集"又要求 L3 永远保留 L2 的拷贝,容量浪费随核数线性放大。non-inclusive 是这场拔河的和解方案:不承诺包含,但通过维护"核存在位"等目录信息,近似保留监听过滤的好处。L3 miss 基本可以断定私有缓存没有(概率上成立,实现上靠目录保证),L3 驱逐时则按目录精确通知真正持有拷贝的核,而不是 inclusive 那种一刀切。
现实产品的站位很能说明问题:Intel 从 Nehalem 到 Haswell 长期坚持 inclusive L3(过滤红利实打实),到 Skylake-SP 服务器芯片换成 non-inclusive 加目录(核数 28 起跳,严格包含养不起了);AMD Zen 系列的 L3 则是 victim 式的 non-inclusive——L3 主要承接各核 L2 踢出的行,不刻意保持包含也不强制互斥。选哪条路,取决于核数、L3/L2 容量比和互连预算的当次配比,这正是 缓存组织与替换 里从体系结构视角展开的话题。
五、对性能分析的启示
缓存包含性平时不露面,但它解释了一批"反直觉"的实测现象:某代服务器 CPU 上 L3 看似很大、多实例并行跑同一个程序时有效容量却缩水(inclusive 的重复拷贝);共享只读数据被 L3 驱逐后全核同步抖动的延迟尖刺(连锁反向无效化);以及跑 perf c2c 看伪共享时,不同代际机器上 HITM 计数的系统性差异(监听过滤路径不同)。理解缓存包含性,再看这些数字就知道该怪数据布局还是怪层级组织。
这一篇在知识体系里的位置
本篇是微架构入门长尾层,向上承接 缓存替换策略(单级满了踢谁)与 写分配与写回策略(单级写 miss 怎么办),把视角从"一级缓存内部"扩展到"级与级之间";向旁连接 缓存组织与替换,从芯片设计视角看 tag 阵列、目录与互连的配套实现。
总结
缓存包含性回答"一行数据能否同时躺在多级缓存里":inclusive 让 L3 做严格超集,换来天然的监听过滤器,代价是容量浪费和驱逐时的连锁无效化;exclusive 让各级互不重复、有效容量拉满,代价是行搬家频繁且失去过滤红利;non-inclusive 不做承诺、靠目录近似保住过滤能力,成为现代多核大 L3 的主流折衷——三种组织没有高下,只有核数、容量比与一致性预算下的当次最优解。