中断投递路径:IOAPIC 到 LAPIC 到核心的完整旅程与延迟构成
更新时间:2026-10-06。做低延迟系统的人迟早会盯上中断:网卡收包、NVMe 完成队列、定时器到期,这些事件从硬件发生到 CPU 开始执行 handler,中间隔着一条比多数人想象更长的路。这条中断投递路径上有 IOAPIC 的重定向表、有把中断伪装成内存写的 MSI 事务、有每个核一个的 LAPIC 在做优先级仲裁,最后才轮到 IDT 查表进 handler。每一站都有延迟,每一站都有配置项,配错了延迟翻倍是常事。本篇把这条路径逐站拆开,上游背景见 CPU 微架构总览,相邻话题见 APIC TSC deadline 定时器(LAPIC 身上的另一项职能)和 uintr 用户态中断投递(绕过内核的那条短路)。
本文要回答的问题
- 一个外部中断从设备到 handler,到底经过哪几站,各站花多少时间?
- 传统的 INTx 引脚中断和 MSI 在投递路径上有什么本质差别?
- LAPIC 的优先级仲裁和 EOI 是怎么工作的,为什么会成为瓶颈?
- 中断亲和性(IRQ affinity)怎么影响路径长度和缓存行为?
一、路径全景:四站接力
先把整条中断投递路径画出来。外部设备要打断一个核,事件要经过四站:设备/IOAPIC 产生中断消息、互连网络(UPI/PCIe/片上总线)把它送到目标核所在位置、该核的 LAPIC 做优先级仲裁并决定何时递进去、最后 CPU 流水线在指令边界响应,查 IDT 跳到 handler。

这条链上真正的大头不在任何一站的「处理时间」,而在互连网络的传输和 LAPIC 等待流水线到下一个指令边界。站数多意味着任何一站的拥塞都会直接加到中断延迟上,这也是为什么大机器(多路、多 die)上跨路中断的延迟明显差于同核本地投递。
先给一个直觉量纲:CPU 执行一条普通指令是亚纳秒级,一次 L3 命中几十纳秒,一次本地 DRAM 访问一百纳秒上下——而一次中断投递从设备到 handler 是微秒级,相当于几百到上千条指令的时间。中断在微架构账本上从来不是免费事件,高频中断源的这份固定成本是能做进容量规划里的。后面三节按从设备到核心的顺序,逐站拆开看每一站做什么、花多久、哪里能调。
二、第一站:INTx 与 MSI 两种起点
老式的 INTx 引脚中断是电平/边沿信号,设备拉一根物理引脚到 IOAPIC 的某个输入口。IOAPIC(I/O Advanced Programmable Interrupt Controller)是芯片组/南桥里的共享中断收集器,内部有一张 24 路左右的重定向表(RTE),每路记录:这个引脚来了中断,该翻译成多少号 vector、发给哪个核的 LAPIC、电平还是边沿触发。IOAPIC 收到引脚信号后查 RTE,生成一条中断消息发到总线上。
MSI(Message Signaled Interrupt,消息信号中断)则完全不走引脚:设备直接往一个约定好的物理地址写一笔数据——这个地址落在 LAPIC 的地址区间(0xFEE00000 一带),数据里编码了 vector 和目标 APIC ID。内存控制器识别出这是写 LAPIC 空间的事务,把它转成中断消息投递。MSI-X 把可用 vector 数从 MSI 的 32 个扩到 2048 个,现代网卡/NVMe 一个队列一个 vector,根子就在这里。
| 维度 | INTx 经 IOAPIC | MSI / MSI-X |
|---|---|---|
| 信号形式 | 物理引脚,电平/边沿 | 内存写事务,天然边沿语义 |
| 共享风险 | 多设备共引脚,需内核链式分发 | 每 vector 独立,无共享 |
| vector 数量 | 受 IOAPIC 输入路数限制 | MSI 32 / MSI-X 2048 每设备 |
| 路径站数 | 设备→IOAPIC→互连 | 设备→互连,少一跳 |
| 亲和性粒度 | 整个引脚绑核 | 每队列/每 vector 单独绑核 |
结论很直接:新设备全用 MSI/MSI-X,不只是为了 vector 多,而是少一跳 IOAPIC、免共享、能按队列绑核。虚拟化场景里的 posted interrupt 和 uintr 用户态中断投递 则是把这条路径再往前推一层。
共享引脚的代价值得单独说。多个设备共用一根 INTx 时,任何一个设备触发中断,内核都要遍历这条 IRQ 链上注册的所有 handler,逐个问「是不是你的」——这是纯软件开销,发生在硬中断上下文里,还伴着电平中断特有的「handler 没来得及清设备状态、中断又立刻重触发」的边沿问题。MSI 从机制上消灭了共享:每个 vector 只属于一个设备的一个队列,handler 入口就知道是谁、是什么事。从历史看,x86 服务器从 IOAPIC 时代过渡到 MSI-X 时代,中断子系统的可扩展性才真正跟上多队列网卡和多核的步伐;今天的 NVMe 盘一块就能申请几十个 vector,每个完成队列绑一个核,投递路径与应用线程的对应关系可以做到完全静态。
三、第二站:互连网络上的中断消息
中断消息在互连上就是一笔普通的事务,但路由规则值得知道。MSI 的目标地址里编码了 APIC ID 的目标字段,互连按它把消息送到对应的 socket/die/核。这里有两个实际的延迟来源:一是跨 socket 要走 UPI 链路,一次跳转大约增加上百纳秒;二是逻辑目标模式下(destination mode = logical)消息可能发给一组 LAPIC,由硬件挑一个「当前优先级最低」的核接——这个挑核动作本身要各 LAPIC 之间交换状态,大核数机器上开销不可忽略。
这张图就是中断亲和性调优的微架构依据:把网卡队列的中断绑到和网卡同 NUMA 节点、最好是同 die 的核上,省掉的就是 UPI 那一跳。绑到异 socket 的核上,每个中断都白白多付一次跨路费,高 PPS 场景下这会直接体现在吞吐和尾延迟上。
还有一个容易忽视的微架构细节:中断消息到达目标核的 LAPIC 时,如果该核正在执行,消息本身不消耗执行资源;但 handler 要跑在那个核上,意味着它的代码、它要读的设备描述符、它要写的 socket 缓冲区,最好都在这个核的缓存里是热的。跨 NUMA 绑核除了传输贵,还经常附带「handler 的内存全在远端」的二次惩罚——中断把核叫醒,核却要跨路取数据才能干活。DPDK 这类轮询方案干脆绕开整条投递路径:不投递、不仲裁、不查 IDT,核自己盯着内存里的门铃寄存器转圈,用 100% 的核占用换掉每次事件几微秒的投递成本,这是另一个极端上的取舍,适合恒定高负载、不适合稀疏事件。
四、第三站:LAPIC 的仲裁与递送
LAPIC(Local APIC)是每个逻辑核私有的中断门卫,核心数据结构是两块 256 位的位图:IRR(Interrupt Request Register,已收到还没递送的请求)和 ISR(Interrupt Service Register,正在服务中的)。新中断到达先按 vector 置 IRR 对应位;LAPIC 比较 IRR 最高优先级和 ISR 当前优先级,只有新来的更高(且 CPU 的 IF 标志允许、PPR 任务优先级寄存器放行)才打断当前执行。
递送的时机约束很关键:CPU 只在指令边界响应中断,一条执行中的长指令(比如 AVX-512 的大向量除法、rep movsb 的大块拷贝)会把递送推迟到它切到下一个可中断点。这就是「设备中断已经到了,核却没反应」那几百纳秒到几微秒的窗口来源。内核关中断的临界区同理:local_irq_disable 保护的范围越长,中断递送的排队延迟越长,这是实时内核补丁(PREEMPT_RT)拼命压缩关中断窗口的根本原因。递送动作本身是硬件行为:保存 RIP/CS/RFLAGS 等现场、按 vector 查 IDT、跳到 handler 入口,量级几十到上百个周期。如果 handler 运行在不同特权级(用户态被打断进内核),还要额外切栈,再贵一点。
handler 干完活要写 LAPIC 的 EOI(End of Interrupt)寄存器告知「服务结束」。EOI 不只是一笔普通 MMIO 写:它会让 LAPIC 清 ISR 位、并可能触发一次中断消息的广播(电平触发的 INTx 需要通知 IOAPIC)。高频中断下 EOI 写的开销和它对流水线的部分串行化效应,是中断处理成本里容易被低估的一部分——这也是 APIC TSC deadline 定时器 这类「少一次 MSR 写」的设计受欢迎的原因。
优先级这套机制还有两个寄存器值得记住:TPR(Task Priority Register,任务优先级寄存器)和 PPR(Processor Priority Register,处理器优先级寄存器,取 TPR 与 ISR 中较高者)。只有 vector 优先级高于 PPR 的中断才能立即递送,其余在 IRR 里排队。Linux 如今几乎不动 TPR(早期内核用它实现软中断屏蔽),但虚拟化场景下 hypervisor 频繁操作它,这也是虚拟中断开销的一部分来源。
访问 LAPIC 本身有两种模式:老的 xAPIC 走 MMIO(0xFEE00000 起的一段内存映射,每次读写都是一笔 uncached 事务,要真的跑到目标核上执行),新的 x2APIC 改用 MSR 读写,快得多且没有 MMIO 的页表依赖。x2APIC 还把 APIC ID 从 8 位扩到 32 位,是 256 核以上大机器的必需品。判断当前模式很简单:dmesg | grep x2apic 或看 /proc/interrupts 顶部的信息。还有一个细节:大核数机器的寻址模式(flat vs cluster)决定了广播类中断(如 TLB shootdown 的 IPI)是一次发全核还是分组发,cluster 模式在数百核机器上能明显降低 IPI 风暴的成本。
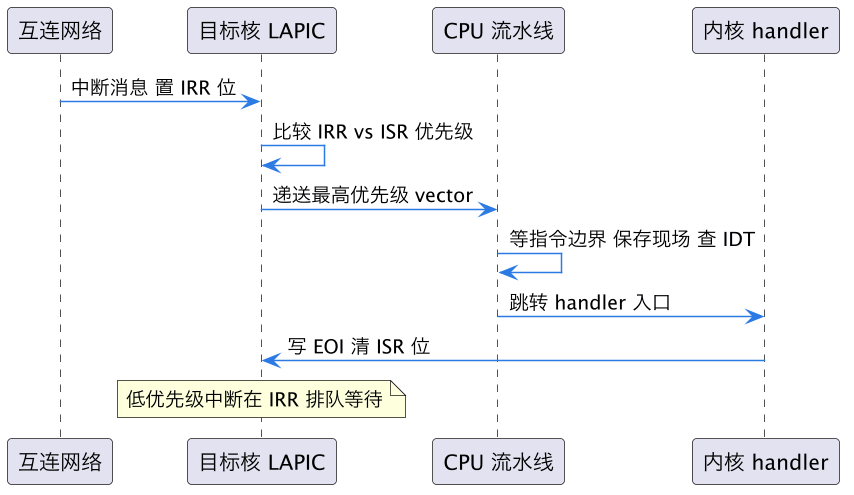
上图中「等指令边界」这一步是软件看不见的:从 perf 采样的视角,中断就像凭空出现;但从延迟剖析的视角,handler 入口时间戳减去设备时间戳,差值里就包含着流水线排空、现场保存和 IDT 查询这几段固定成本。
五、亲和性与实际延迟预算
把整条路径的数字凑起来看:同 socket 内一次 MSI 投递的典型延迟在 1-2 微秒量级(从设备发起算到 handler 第一条指令),跨 socket 加几百纳秒到一微秒,若目标核在深 C-state 睡眠还要再加唤醒时间——那部分见 C-state 退出延迟速查(待发布)一类的量级表,常见 C6 唤醒要几十微秒,往往比投递路径本身贵一个数量级。
| 路径段 | 典型量级 | 可控手段 |
|---|---|---|
| 设备产生到 MSI 发出 | 设备相关,百 ns 级 | 中断合并参数(如网卡 rx-usecs) |
| 互连传输 同 socket | 几十到一百 ns | 绑同 NUMA 核 |
| 互连传输 跨 socket | 多 100-300 ns 起 | irqaffinity / 中断均衡策略 |
| LAPIC 仲裁与递送 | 几十周期 | 减少高优先级中断源干扰 |
| 指令边界等待 | 0 到数 µs | 避免长指令临界区,关中断窗口最小化 |
| 现场保存 + IDT | 几十到上百周期 | 固定成本,不可调 |
| 目标核 C-state 唤醒 | 数 µs 到数十 µs | 绑核 + 限制 idle 深度 / polling |
工程上的标准动作因此是三板斧:一是用 /proc/irq/<n>/smp_affinity_list 把每个中断源绑到与设备同 NUMA 的核上,并让这些核远离深睡眠;二是关掉 IRQ balance 的盲目均衡(或者给它明确的策略),避免中断被匀到跨路核上;三是用中断合并把频率压下来——投递路径的每一微秒固定成本,摊到越少的中断上越划算。
观测与验证给出一条可操作的清单:
/proc/interrupts按核分列每个 vector 的累计计数,前后采样对比就能看出中断实际落在哪些核上、绑核是否生效。perf stat -e irq_vectors:local_timer_entry之类的 tracepoint 可以统计某窗口内各类 vector 的次数,算中断频率。- handler 执行成本用
perf record -g采样软/硬中断上下文,或直接看/proc/softirqs的 NET_RX 列增长速率。 - 端到端延迟用硬件时间戳最准:网卡支持 PHC 的话,收包时间戳与 handler 内读的
ktime_get之差就包含完整投递路径。 - 绑核对比实验最容易做:同一份百万 PPS 打流负载,分别把中断绑到同 NUMA 核和跨 NUMA 核,看吞吐与 P99 延迟的差异,跨路绑核的劣化通常肉眼可见。
最后一个常被忽略的点:中断合并(interrupt coalescing,如网卡的 rx-usecs/rx-frames 参数)本质上是拿投递路径的固定成本做摊销——设备攒几个包再发一次中断,每次中断的 1-2 微秒路径成本就摊到了多个包上。延迟敏感场景要把合并调小甚至关掉,吞吐优先场景则相反,这个旋钮没有普适最优值,只有按负载实测出来的平衡点。
这一篇在知识体系里的位置
本篇属于 microarch 层「中断与特权切换」专题的主干线:向上回到 CPU 微架构总览;横向与 APIC TSC deadline 定时器(LAPIC 的定时器职能)、uintr 用户态中断投递(不进内核的投递短路)、SMM 系统管理模式(比中断更霸道的固件打断)互补。功耗侧衔接 CPU 电源与频率管理(C-state 与唤醒成本的来源)。
总结
中断投递路径是设备事件到 handler 之间的四站接力——IOAPIC/MSI 产生中断消息、互连按 APIC ID 路由、目标核 LAPIC 做 IRR/ISR 优先级仲裁、流水线在指令边界响应并查 IDT;MSI 比 INTx 少一跳且可按队列绑核,跨 socket 投递要为 UPI 多付几百纳秒,而最大的延迟变量往往是目标核的 C-state 唤醒,调优的本质就是把中断绑到又近又醒着的核上。