缓存写策略决策树:write-through/write-back 与 write-allocate 的组合取舍
本篇从微架构视角回答一个看似朴素的问题:一条
mov [rbx], eax的写,到底落在哪一级、什么时候真正离开 CPU?读的缓存策略大家熟(miss 了就填充一行),但写比读多两个维度——命中时往下层同步吗?缺失时先分配行吗?这两个维度交叉出四种缓存写策略组合,直接决定写带宽、写延迟和一致性实现的复杂度。写入在流水线里的入口见 LSU(Load/Store Unit);写缺失触发的 L1 连锁停顿见 miss 连锁反应篇。缓存层次的系统性写法见 缓存写策略(缓存域)。
本文要回答的问题
- 缓存写策略的两对独立选项——write-through vs write-back、write-allocate vs no-write-allocate——各管什么事?
- 四种组合交叉之后,带宽、延迟、硬件复杂度各是什么代价?
- 为什么现代通用 CPU 几乎清一色选 write-back + write-allocate?
- 什么时候程序员要绕过默认策略(non-temporal store)?
一、写的两个独立维度
一条 store 到达 L1 D-Cache 时,硬件要回答两个互不相干的问题:
- 命中了(目标行就在 L1):要不要立刻把数据同步到下层? 立刻同步 = write-through(写穿);只改 L1、打个脏标记 = write-back(写回)。
- 没命中(目标行不在 L1):要不要先把这行从下层装进缓存再写? 先装再写 = write-allocate(写分配);直接写下层、不装 = no-write-allocate(写不分配,也叫 write-around)。
注意这两件事正交:命中策略管的是"数据已经在手边时怎么写",分配策略管的是"数据不在手边时写去哪"。把它们拼起来就是四种组合:
| 组合 | 命中行为 | 缺失行为 | 典型用户 |
|---|---|---|---|
| write-through + write-allocate | 同时写 L1 和下层 | 先装入 L1 再写 | 早期简单内核、部分 DSP |
| write-through + no-write-allocate | 同时写 L1 和下层 | 直接写下层 | 最早的缓存(如 Intel 80486 L1) |
| write-back + write-allocate | 只写 L1,置 dirty | 先装入 L1 再写 | 现代 x86/ARM 主流 |
| write-back + no-write-allocate | 只写 L1,置 dirty | 直接写下层 | 流式写优化场景 |
二、write-through vs write-back:命中时往不往下写
**write-through(写穿)**的逻辑最直白:每次写命中,数据同时更新 L1 和下一级缓存(或内存)。L1 里永远不会有"下层不知道的脏数据",多核一致性几乎不用操心,断电也不丢。代价同样直白:每一次 store 都要占用下层总线一笔带宽。写密集的程序(比如 memset 一整块内存)会把总线打满,写 1000 次同一个变量就是 1000 次总线事务。为了不至于把流水线憋死,write-through 机器必须配一个 write buffer 吸收突发写——buffer 一满,store 照样 stall。
**write-back(写回)**则反着来:命中时只改 L1,把这一行的 dirty 位置 1,下层内存暂时是旧值。只有这行将来被替换出去(evict)时,才把整行一次性写回下层。同一个变量写 1000 次,L1 里改 1000 次,总线上可能一笔事务都没有。省带宽的代价是复杂度:
- 每行多一个 dirty 位,替换时要先查脏;
- 替换一个脏行要先写回才能填新行,miss 延迟里多了一段"回写时间"(现代 CPU 用 victim buffer 把它挪出关键路径);
- 下层数据和 L1 不一致,多核下必须靠 MESI 这类一致性协议兜底——见 MESI 协议。
一个容易混淆的点:write-back 的"懒"只在缓存层次内部生效,对软件不可见。你 x = 1 之后立刻读 x,CPU 会命中 L1 里的新值,绝不会读到下层内存的旧值——一致性是硬件用协议兜住的,不需要程序员操心。程序员要操心的从来不是"写什么时候到内存",而是"什么时候到其他核的视线里",那是内存序和 fence 的话题,不是写策略能回答的。
一句话:write-through 拿带宽换简单,write-back 拿复杂度换带宽。 当片外带宽是稀缺资源(它一直都是),这笔交换几乎总是划算的。
三、write-allocate vs no-write-allocate:缺失时先不先装行
写缺失时的选择更微妙。直觉上"写缺失就直接写内存呗",但现代缓存几乎都不这么干,而是 write-allocate:先把整个 cache line(64 字节)从下层读进 L1,再把这次写的数据合并进去。为什么多此一举读一趟?
- 空间局部性:程序写了这个地址,大概率很快会读它或写它的邻居(结构体字段挨着、数组连续填充)。把行装进来,后续的读写全部变命中。
- 整行语义:缓存以行为单位管理,dirty 位也是按行记的。行在手里,后续写合并、回写都是标准路径;行不在手里,每次写都得单独往下层发一笔"部分写",总线效率极差。
no-write-allocate 只在一种情况下占优:数据写了就再也不碰。比如把一个大 buffer 清零后立刻 DMA 给网卡发走,或者 GPU 上传的像素数据。这时把行装进缓存纯属污染——挤掉了真正有用的行,还白付一趟读取带宽。x86 为此提供了 movnti 这类 non-temporal store:显式告诉 CPU"这数据不回头",走 write-combining buffer 直接写内存,绕过缓存分配。详见 streaming/nontemporal store 篇。
四、决策树:硬件到底怎么选
把两对选项串起来,一条 store 在 L1 里的完整决策路径是这样的:
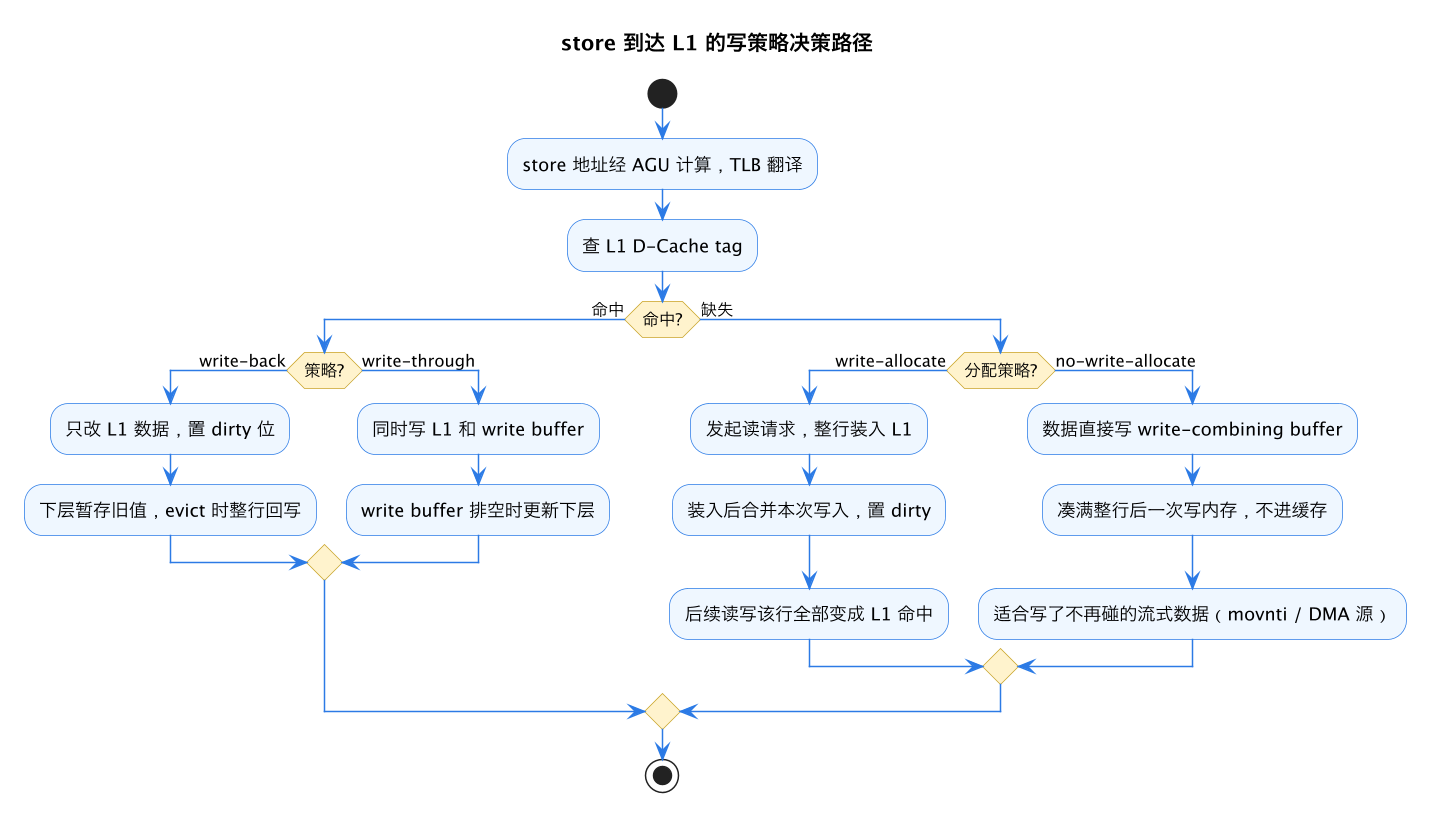
这张图值得停一下的地方有两个。第一,命中分支和缺失分支是两套独立的硬件逻辑——write-back 只管命中后"懒一点",write-allocate 只管缺失后"先拿回来",所以"write-back + write-allocate"不是绑定关系,是各占一个岔路口。第二,两条缺失路径的出口完全不同:write-allocate 的出口是"行已在缓存",no-write-allocate 的出口是"行永远不进缓存"——后者省了缓存污染,但如果判断错了(数据其实还会被读),后面每次访问都是一次完整 miss,代价翻倍。
五、为什么主流是 write-back + write-allocate
四个维度摆在一起看:
| 维度 | write-through | write-back | 说明 |
|---|---|---|---|
| 下层带宽消耗 | 高(每写一笔) | 低(合并到 evict) | 片外带宽是瓶颈资源 |
| 命中写延迟 | 受 write buffer 深度约束 | 只写 L1,最快 | store buffer 之后几乎无感 |
| 一致性复杂度 | 低(下层总是最新) | 高(要 MESI 兜底) | 复杂度一次性付清,带宽天天要付 |
| 硬件成本 | 简单 | dirty 位 + victim buffer | 晶体管比带宽便宜 |
结论几乎是算术题:带宽和延迟是每次写都要付的钱,复杂度只在设计芯片时付一次。 所以 Intel 从 Pentium 时代起 L1 就是 write-back + write-allocate,ARM 的 Cortex-A 系列同样如此。write-through 如今只活在两类地方:极简单的嵌入式内核(没有一致性协议可依赖),以及某些对外设可见的特殊映射区域。
程序员侧真正要动手的只有一件事:识别"写了不回头"的大数据量写(几百 MB 的清零、拷贝、DMA 源),把它换成 movnti 或等价 intrinsic,主动选 no-write-allocate 路径。判断依据和测量方法见 measuring-cache 篇。
这一篇在知识体系里的位置
本篇是缓存体系里"写"这一半的微架构入口:往下,写入在流水线里的排队与转发见 LSU 篇,store buffer 与内存序的关系见 store-buffer;往缓存域,write-back 引出的多核一致性由 MESI 协议 兜底,no-write-allocate 的软件形态见 nontemporal store 篇;系统性展开见 缓存写策略(缓存域)。
总结
缓存写策略就是两个岔路口:命中时选 write-back(只改 L1 置脏,evict 才回写)还是 write-through(每笔都同步下层),缺失时选 write-allocate(先装行再写)还是 no-write-allocate(直接绕缓存写内存)。现代 CPU 清一色选 write-back + write-allocate,因为带宽和延迟每次写都要付、复杂度只在流片前付一次;程序员唯一的干预点是给"写了不回头"的流式数据用 non-temporal store,主动切到 no-write-allocate 路径省掉缓存污染。