向量长度无关:ARM SVE 谓词寄存器与单份二进制跑遍 128 到 2048 位的编程模型全解
更新时间:2026-10-02。向量 SIMD 执行单元 那篇讲的是硬件侧:一条向量指令如何把 128/256/512 位的寄存器切成车道并行干活。那篇结尾留了一个疙瘩——x86 的 SSE/AVX/AVX-512 每次扩位宽,软件就得重编一份,甚至同一代里 128/256/512 要各写一套循环。ARM 在 2016 年公布的 SVE(Scalable Vector Extension,可伸缩向量扩展)对这个行业顽疾给出了一个完全不同的回答:向量长度无关(Vector Length Agnostic,VLA)编程。代码里根本不出现「向量有多宽」这个数,循环跑几轮、每轮处理几个元素,全部由硬件在运行时告知;同一份编译产物,在 128 位的手机核和 2048 位的超算核上都把向量单元喂满。这一篇把这个编程模型拆到底:谓词寄存器是什么、whilelt 驱动的循环为什么天生不怕位宽变化、gather/scatter 如何把不规则访存向量化,以及 VLA 在工程上的真实代价。
本文要回答的问题
- 传统固定位宽 SIMD(SSE/AVX/NEON)为什么每扩一次位宽就要重写或重编,「向量长度无关」到底免去了什么?
- SVE 的谓词寄存器(predicate)长什么样,它如何取代「掩码 + 分支」成为车道控制的核心机制?
- whilelt 驱动的 VLA 循环是怎么写的,为什么循环次数都不需要程序员算?
- 边界尾巴处理、gather/scatter、水平归约在 VLA 模型下各自怎么落地?
- VLA 不是免费的:编译器和程序员在哪些场景要为「不知道宽度」付出真实代价?
一、固定位宽的原罪:一条指令集扩了五次,代码跟着重写五次
先看清楚 VLA 要解决的那个老问题有多疼。x86 的 SIMD 演进史是一部「位宽军备竞赛史」:1999 年 SSE 给 128 位 XMM,2011 年 AVX 给 256 位 YMM,2016 年 AVX-512 给 512 位 ZMM。每一次扩展,想吃到新位宽的软件都要做两件事:用新指令重写内层循环(内在函数 intrinsic 全是 _mm_、_mm256_、_mm512_ 三套互不兼容的命名),以及为「元素个数不是向量宽整数倍」的尾巴再写一份标量收尾循环。一个矩阵乘法在成熟代码库里经常是三四份内核并存,运行时按 CPUID 分发。
ARM 自家的 NEON 也一样:128 位写死,想更宽只能靠 SVE。但 ARM 吸取教训的方式不是继续加宽,而是把「宽度」这个参数从指令集里彻底拿掉。SVE 规定:向量寄存器 Z0-Z31 的位宽是实现相关的,可以是 128 到 2048 之间的任何 128 的倍数;指令集里不存在任何编码了具体位宽的指令,也没有「按 512 位解释这个寄存器」的写法。一条 add z0.d, z1.d, z2.d(64 位车道双字加法)在 256 位实现上算 4 个元素,在 512 位实现上算 8 个,指令编码完全相同。
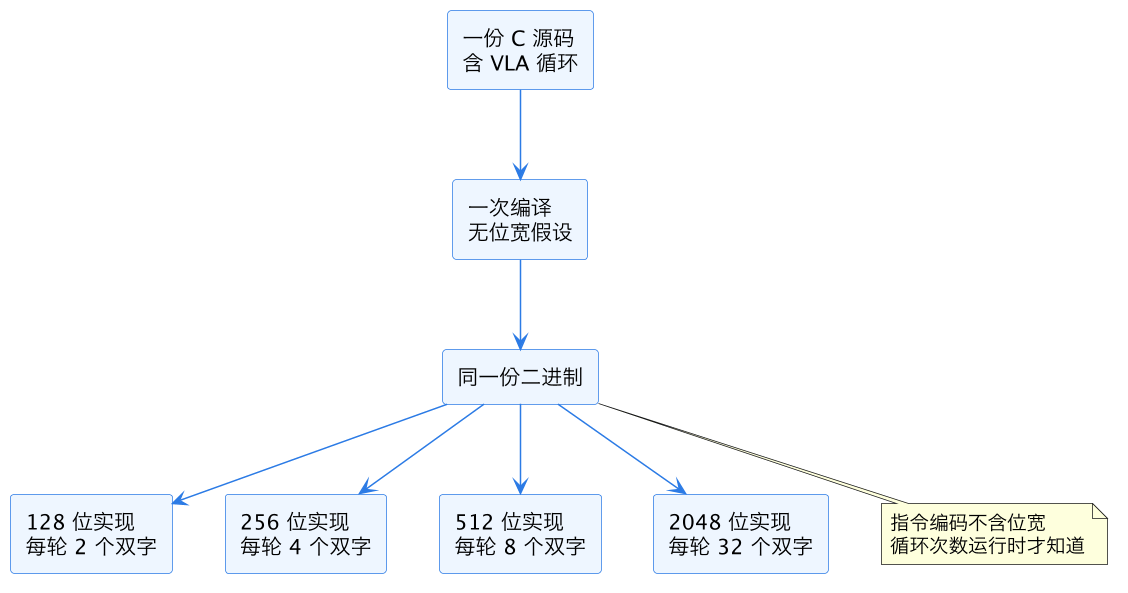
上图是 VLA 承诺的核心画面:一份源码、一次编译、一份二进制,在所有位宽的实现上各自跑满。对比一下固定位宽世界的对应画面——源码三份或一份加三层宏、二进制三份、运行时 CPUID 分发——就能理解为什么 ARM 说 SVE 是「为后三十年的向量硬件留头」的设计。位宽从「指令集属性」降级为「微架构属性」,和流水线深度、发射宽度一样,成了实现者的自由。
这里有个容易误解的点要先澄清:VLA 不是「程序员不用关心性能调优」,而是「不用关心正确性与位宽绑定」。循环展开策略、软件流水深度这些调优动作仍然和具体位宽有关,只是它们从「必须写进源码」变成了「编译器按目标机器模型去推」。
二、谓词寄存器:每条车道一个开关,分支从向量循环里消失
VLA 的第一块基石是谓词寄存器(predicate register)。SVE 提供 P0-P15 共 16 个谓词寄存器,位宽是向量寄存器的 1/8——每个向量车道对应谓词里的一个比特。比特为 1,这条车道正常执行并把结果写回;为 0,这条车道按指令语义要么不动(merging,保留旧值),要么清零(zeroing)。
为什么说谓词是 VLA 的基石而不是配角?因为在「宽度未知」的世界里,几乎所有控制流都必须转化为车道级的开关。固定位宽 SIMD 里遇到 if (a[i] > 0) 这种数据相关分支,要么靠掩码指令手工拼(AVX-512 之前 x86 连像样的掩码都没有,只能靠 blend 指令凑),要么拆回标量。SVE 的做法是把掩码提升为一等公民:cmpgt p0.d, p7/z, z1.d, #0 这类比较指令直接产出谓词,后续所有向量指令都带一个谓词操作数限定「哪些车道干活」。
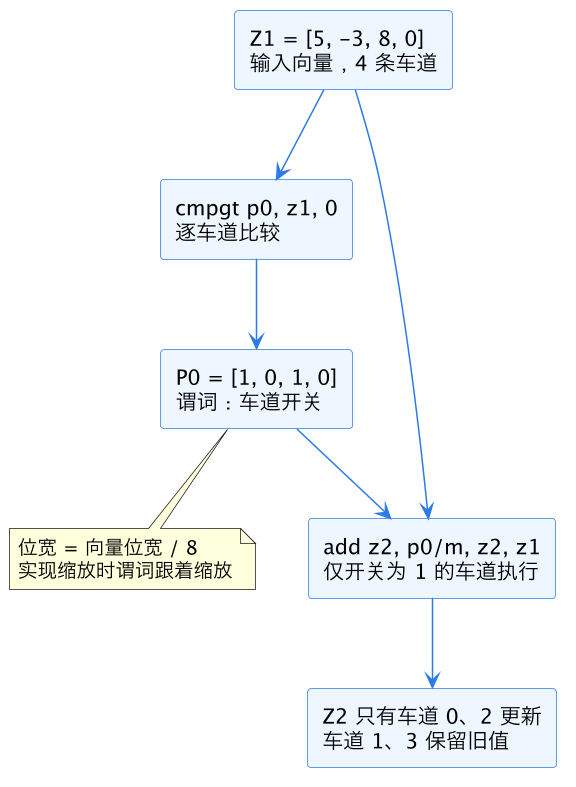
上图用一个 4 车道的玩具例子展示谓词的数据流。注意那个关键性质:谓词位宽随向量位宽同步缩放,所以「比较产出谓词、谓词控制执行」这套代码同样不含位宽假设。merging(/m)和 zeroing(/z)两种模式给了程序员选择:merging 适合做累加式的条件更新,zeroing 适合构造干净的结果向量。这套机制和 AVX-512 的 mask 寄存器神似,但 SVE 把它用得更彻底——连访存和循环推进都挂在谓词上,这就是下一节的主角。
三、whilelt 循环:循环计数器自己适应位宽
VLA 编程模型最精华的部分是循环写法。看一个对所有元素加一的 daxpy 式循环,SVE 汇编风格的骨架是这样的:
    mov   x3, #0              // i = 0
.Lloop:
    whilelt p0.d, x3, x2      // p0 车道 k = (x3 + k < x2)
    ld1d  z0, p0/z, [x0, x3, lsl #3]   // 谓词控制的加载
    ld1d  z1, p0/z, [x1, x3, lsl #3]
    fadd  z0, p0/m, z0, z1    // 谓词控制的加法
    st1d  z0, p0/z, [x0, x3, lsl #3]
    incd  x3                  // i += 本实现的每寄存器双字数
    b.first .Lloop            // 只要还有活跃车道就继续
三处机关值得逐个看。第一处是 whilelt p0.d, x3, x2:它把「索引 i 加车道号 k 是否仍小于总数 n」直接物化成谓词——第 k 条车道的比特就是 x3 + k < x2 的真假。这一条指令同时完成了「还剩多少元素」和「哪些车道本轮干活」两件事,输出天然是「前面一段车道全 1、后面全 0」的渐变形态。第二处是 incd x3:把 x3 增加「一个向量寄存器能装的双字数」——这个数是硬件位宽决定的,128 位实现加 2,512 位实现加 8,程序员写的是同一个 incd。第三处是 b.first:按谓词第一个活跃位是否为 1 决定回跳,等于「本轮还有活干就再来一轮」。
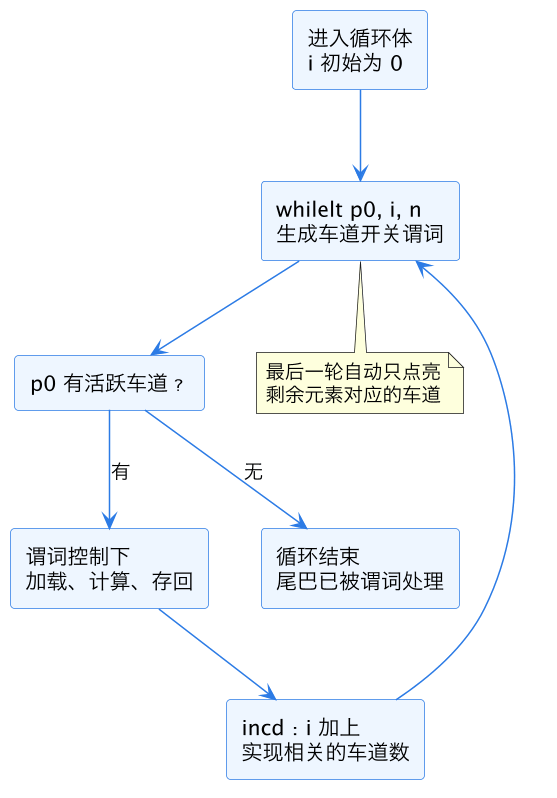
上图是这个循环的控制流。请重点看循环里没有尾巴分支:n 不是向量宽整数倍时,最后一轮的 whilelt 自动只点亮前几个车道,越界车道在加载、运算、存回三个环节全部被谓词按住,连内存都不会碰(谓词为 0 的车道访存被抑制,不会触发缺页——这是 fault-suppression 语义,对安全性至关重要)。固定位宽世界里那个臭名昭著的「主循环 + 标量尾巴循环」两段式结构,在 VLA 里被 whilelt 一条指令消化掉了。这就是「向量长度无关」在循环层面的完整含义:不写位宽、不写展开因子、不写尾巴处理,三件事全部由谓词机制在运行时自适应。
边界条件还有个小福利:n 小于一个向量宽度时,循环照样只跑一轮,谓词只点亮前 n 条车道——小数组和大数组走同一条代码路径,没有「短了就不值得向量化」的特判。
四、不规则访存与归约:gather/scatter 与谓词驱动的水平操作
光会算连续数组只是及格线。真实负载里的向量循环常被两类东西卡住:非连续访存和跨车道归约。SVE 对两者都给了 VLA 兼容的答案。
非连续访存靠 gather/scatter:ld1d z0, p0/z, [x0, z1.d] 用向量 z1 里的每条车道当偏移,从基址 x0 分散地抓数据回来,谓词依旧控制哪些车道真去访存。这对稀疏矩阵(CSR 格式的列索引)、哈希表探测、粒子模拟这类「下标本身在数据里」的负载是质变——以前这些循环是向量化的禁区,现在至少指令集层面有了表达。代价是性能:gather 在多数实现上每条不命中缓存的车道都要单独走一次访存流水线,吞吐远低于连续加载,所以工程上的正确姿势是「先尽量把数据布局改连续(AoS 转 SoA),改不了的再用 gather」。
跨车道归约(把一个向量加成一个标量)在 VLA 下有个悖论:不知道宽度怎么写归约树?答案是不写树,用专门的归约指令:faddv d0, p0, z0 一条指令把谓词点亮的所有车道归约成一个标量。实现内部是分几拍做完的、顺序如何,指令集不承诺——这也带来一个真实坑:浮点归约的结果顺序是实现相关的,同一份二进制在 256 位和 512 位机器上跑出的浮点和可能在末位不同。对 bitwise 可复现性有要求的场景(金融回测、科学计算验证),这是 VLA 模型少数要额外花心思的地方,通常的解法是用定点、或把归约顺序固定下来牺牲一点性能。
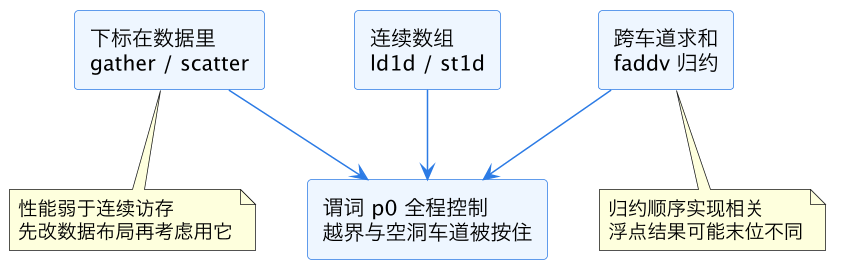
上图把三类操作的共性抽出来:不管访存模式多花哨、归约多跨车道,谓词 p0 始终是那个统一的车道开关。这是 SVE 设计上的一致性红利——学会谓词,就学会了整个指令集的控制流。
五、VLA 的真实代价:编译器难做、调试难看、性能还是要测
讲了这么多好话,得把代价摆上桌面,否则这篇就是广告。
第一笔代价落在编译器头上。自动向量化器面对 VLA 目标时,展开因子、软件流水深度、寄存器压力全部无法从位宽推出(位宽在编译期未知),LLVM 的办法是按「可伸缩向量」类型建模,把位宽相关决策推迟或参数化。这条路走了好几年才成熟,至今 SVE 自动向量化的覆盖率和调优质量仍落后于固定宽度的 AVX2 路径。手写 intrinsic 则反过来:arm_sve.h 的谓词化 intrinsic 表达力强但代码可读性差,一条 svwhilelt_b64 就要新手查半天手册。
第二笔代价在调试与验证。同一份二进制在不同位宽机器上的循环轮数不同,性能 profile 不可直接对比;上一节说的浮点归约顺序问题让「换台机器结果差一个 ulp」成为合法行为,CI 里的数值断言要改写。还有一种新型 bug:代码里偷偷假设了「一个向量至少装 4 个 float」之类的下限(128 位是实现允许的最小值,装 4 个 float 恰好成立,但装 2 个 double 也恰好成立——若有人假设 4 个 double,就在 128 位实现上翻车)。VLA 不豁免你对下限的检查。
第三笔代价是「同一份二进制跑满所有位宽」这句话有个隐含前提:你的瓶颈在向量单元。如果负载是访存受限的,2048 位实现的宽向量并不会带来 16 倍于 128 位的收益,两者可能都打不满内存带宽——这时候 VLA 的价值从「性能伸缩」退化为「代码一份,维护省心」,这依然是价值,但预期要摆正。搭配 缓存替换策略 LRU 及其变体 和 硬件预取器 里讲的内存墙背景看,会更容易想清楚自己的负载属于哪一类。
| 维度 | 固定位宽(AVX2/NEON) | 向量长度无关(SVE) |
|---|---|---|
| 位宽变化 | 重写或重编,多份二进制 | 一份二进制通吃 |
| 尾巴处理 | 手写标量尾巴循环 | whilelt 谓词自动收尾 |
| 车道控制 | 掩码指令或 blend 拼凑 | 谓词寄存器一等公民 |
| 浮点归约可复现性 | 顺序固定,跨机一致 | 顺序实现相关,末位可差 |
| 编译器成熟度 | 多年打磨,覆盖率高 | 可伸缩向量路径较新 |
| 最小位宽假设 | 编译期可知 | 128 位下限,需自查 |
这一篇在知识体系里的位置
本篇是微架构模块里向量计算线的编程模型篇,上游是硬件视角的 向量 SIMD 执行单元,讲车道、执行端口与位宽演进的硬件事实;本篇把它接到软件侧,回答「指令集怎么让软件不被位宽绑架」。理解 VLA 里的投机与谓词语义,可以和 精确异常与流水线冲刷 里「被抑制的效果不产生架构可见后果」的思想对照着读——谓词为 0 的车道不触发缺页,本质是同一种「效果抑制」哲学。向量负载的内存侧瓶颈见 硬件预取器 与 缓存替换策略 LRU 及其变体;整条微架构知识链的地图见 CPU 微架构总览。
总结
向量长度无关是 ARM SVE 的编程模型:向量位宽从指令集属性降级为微架构属性,代码用谓词寄存器做车道级开关、用 whilelt 生成「还剩多少元素」的渐变谓词、用 incd 按实现相关的车道数推进循环,尾巴处理、条件执行、gather/scatter、归约全部挂在谓词这一套机制上——换来的是一份二进制从 128 位跑到 2048 位都正确且跑满,付出的真实代价是编译器建模更难、浮点归约跨机末位可差、以及访存受限负载下「宽」并不等于「快」。