物理寄存器堆:多端口读出的面积功耗代价,与旁路网如何替它减负
在 寄存器重命名 里我们把逻辑寄存器映射到了物理寄存器,在 乱序重命名与退休 里看过物理寄存器的分配与回收。这两篇都默认了一件事:物理寄存器堆(Physical Register File,PRF)是个"随便读"的数组。这一篇把这个假设戳破——PRF 是乱序核心里单位面积功耗最高的结构之一,而它的痛点几乎全在读端口上。
本文要回答的问题
- 物理寄存器堆的读端口为什么随发射宽度"爆炸",代价到底涨多快?
- 多端口 PRF 的面积和功耗代价来自哪些物理因素?
- clustered PRF 和 register file cache 分别怎么给 PRF 降压,各自付出什么代价?
- 旁路网(bypass network)为什么能替 PRF 分担掉一大半读流量?
一、先算账:发射宽度翻倍,读端口不是翻倍而是更多
一条整数 µop 最多读 2 个源寄存器、写 1 个目的寄存器。一个 N 发射的乱序核心, worst case 下每拍要同时读出 2N 个源操作数——PRF 就得提供 2N 个读端口、N 个写端口:
| 发射宽度 N | 读端口数(最坏) | 写端口数 | 端口总数 |
|---|---|---|---|
| 2 | 4 | 2 | 6 |
| 4 | 8 | 4 | 12 |
| 6 | 12 | 6 | 18 |
| 8 | 16 | 8 | 24 |
端口数本身只是线性增长,真正的问题在存储阵列内部。寄存器堆的每个存储单元(bit cell)要挂到每一条读字线和每一条读位线上,每多一个读端口,每个单元就多一些走线和一两个额外的访问晶体管。单元面积随端口数近似线性增长,而单元总数 = 物理寄存器个数 × 位宽,所以整个阵列的面积近似是:
PRF 面积 ≈ 寄存器个数 × 位宽 × (基础单元 + 每读端口增量 × 读端口数 + 每写端口增量 × 写端口数)更狠的是延迟:端口越多,位线越长、负载越大,走线寄生电容随端口数平方级别地涨,读出延迟也跟着恶化。这就是"读端口随发射宽度爆炸"的真正含义——不是端口数量爆炸,而是每加一个端口,整个阵列的所有单元都在为它付面积和寄生电容的税。一个 8 发射核心如果只给整数 PRF 配 16 个读端口,光这一个阵列就可能吃掉核心功耗预算的几个百分点,还会卡在关键路径上。
二、数据通路全景:PRF 读口其实只服务一小撮数据
要理解怎么减负,先看清楚谁在从 PRF 读数据。下图是一个 4 发射整数簇的典型"发射—读寄存器—旁路"数据通路:
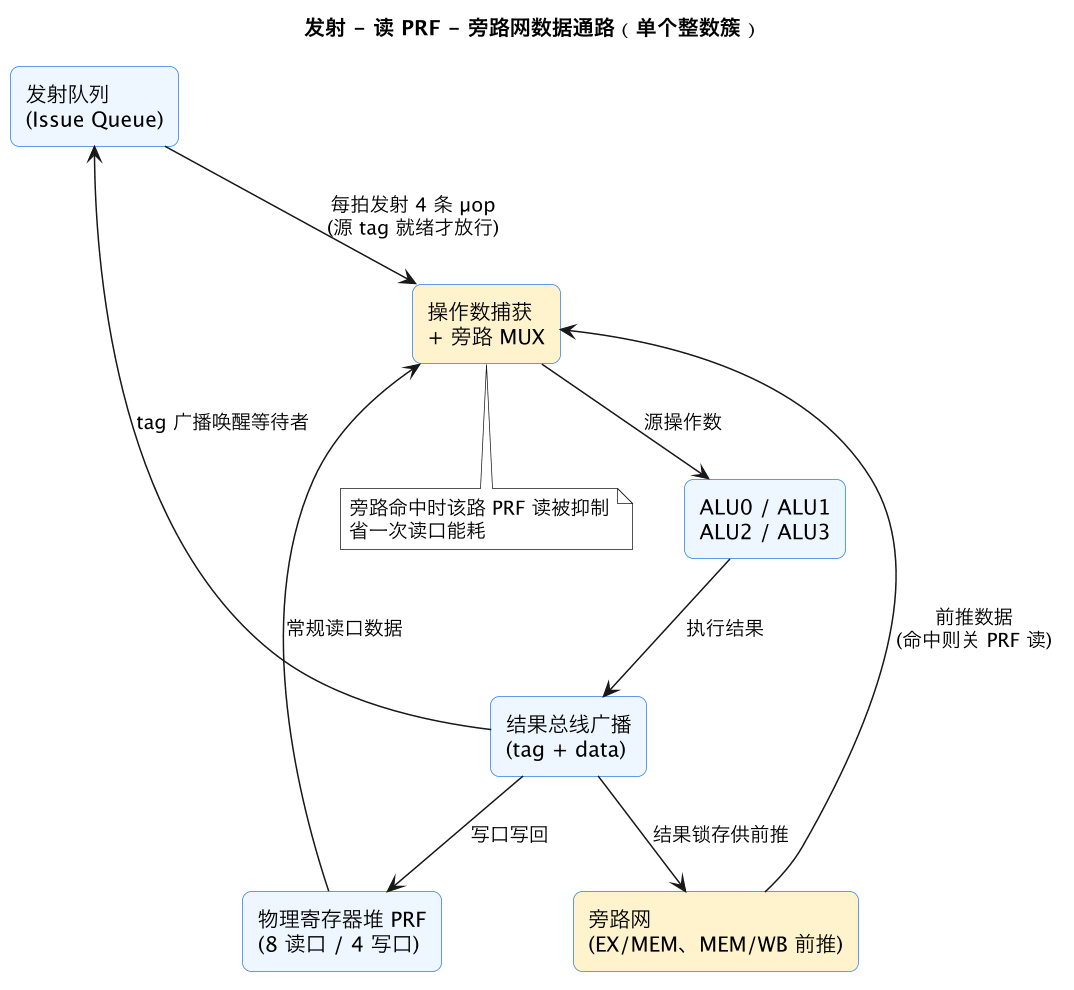
这张图的核心信息是:ALU 的源操作数有两条来路——PRF 常规读和旁路网前推,MUX 二选一。而真实程序里,ALU 的输入大部分来自"最近 1~2 拍刚算出来"的结果(想想 a=b+c; d=a+e 这种紧挨着的依赖链),也就是旁路网命中的路径。PRF 常规读口实际服务的是"生产者早就写回了、消费者隔了很久才来读"的冷数据——实测统计里,旁路网能截走一半以上甚至七成的源操作数流量。这就引出后面的两个降压方向:既然 PRF 读口大多数时候在空转,能不能少配点端口、或者把阵列拆小?
三、降压方案一:端口瘦身与 clustered PRF
最直接的观察是:worst case 的 2N 读口是为一拍内所有 µop 都是"双源冷数据"准备的,这种情况极少见。工程上有两级瘦身:
端口数不按满配。 很多设计给整数 PRF 只配 1.5N 甚至 N 个读口(比如 4 发射配 6 读口),发射逻辑发现本拍端口不够时,把多余的 µop 推迟一拍。统计上冲突率很低,换来的是整个阵列面积和寄生电容的可观收缩。代价是发射逻辑多一条仲裁路径,以及极端依赖链代码偶尔掉一拍。
clustered PRF:把一个大盘子拆成几个小盘子。 把执行单元分成 2~4 个簇(cluster),每簇配自己的小 PRF,只保存本簇执行结果;跨簇的数据传递走一条显式的簇间拷贝总线,多花一拍:
| 方案 | PRF 结构 | 读延迟 | 面积/功耗 | 跨簇代价 |
|---|---|---|---|---|
| 统一 PRF | 1 个大阵列,全端口 | 1 拍 | 高(端口税全体单元均摊) | 无 |
| clustered PRF | 每簇小阵列,端口少 | 簇内 1 拍 | 显著下降(阵列小、线短) | 跨簇 +1 拍拷贝 |
| register file cache | 主 PRF + 小型值缓存 | 命中 1 拍 | 中等 | miss 时回主 PRF +1~2 拍 |
簇内的小阵列单元少、位线短,读出能耗和延迟都远好于统一大盘——而程序里相邻 µop 往往被调度到同一簇(调度器会刻意做 cluster steering,把依赖链钉在一个簇里),所以跨簇拷贝的实际频率可控。代价是调度复杂度上去了,以及跨簇那 1 拍在关键依赖链上偶尔会咬人。
四、降压方案二:register file cache 与旁路网分担读口
另一条思路是承认"主 PRF 必须大",但给它前面加一层小型 register file cache(RFC):缓存最近写回的几十个值,发射时先查 RFC,命中就不碰主 PRF。RFC 容量小、端口便宜,等于把高频读流量从贵的大阵列挪到便宜的小阵列。它和 clustered PRF 是正交的两条路——前者按"值的新旧"分层,后者按"执行单元位置"分片,可以叠加使用。
不过最便宜、也最容易被忽视的一味药,其实在第二节那张图里已经画出来了:旁路网本身就是 PRF 的一级"缓存"。每一路旁路命中,硬件都可以抑制对应的 PRF 读口(不驱动读字线),省下一次阵列访问的动态能耗。在 ALU→ALU 紧依赖占主导的真实负载里,这一招能把 PRF 的实际读访问次数砍掉一半以上——相当于旁路网替 PRF 白打了半份工。这也是为什么现代宽发射核心愿意在旁路网那堆又长又贵的布线上砸面积:旁路网的布线成本换来的,是 PRF 端口和阵列的全面瘦身,两边的账要放在一起算。前推机制本身的时序细节见 RAW 与前推旁路。
五、对性能分析的启示
这些结构选择最后都会落到你能测到的数字上:依赖链代码的 IPC 天花板、宽发射核心在依赖密集负载下的频率回退(功耗墙)、乃至 SMT 两个线程争抢 PRF 端口时的微妙减速。看懂 PRF 的端口经济学,再回头看 IPC 瓶颈拆解 和 发射队列唤醒选择 里的调度取舍,很多"为什么不多发射一条"的问题就有了功耗与面积的底层答案。
这一篇在知识体系里的位置
本篇是微架构长尾层,向上承接 寄存器重命名 与 乱序重命名与退休(物理寄存器从哪来、到哪去),向旁连接 RAW 与前推旁路(旁路网的时序细节)、发射队列唤醒选择(发射侧怎么配合端口仲裁)与 乱序执行机制(全景图)。
总结
物理寄存器堆的真正瓶颈是读端口:端口税让阵列面积和寄生电容随发射宽度近似平方地涨,而旁路网截走大半热数据的事实给了硬件三条退路——端口不满配、clustered 拆小阵列、register file cache 分层缓存,三者共同把"每拍 2N 次全阵列读"的worst case 压回了功耗预算之内。