神经网络与深度学习
本域讲神经网络与深度学习的原理、训练、推理与部署,从硬件/工程视角切入(对应站点硬件主线:FPGA、芯片设计);AI 应用与 RAG/Agent 见 data-ai。
下面按入门 / 进阶 / 专家三层给出学习地图:每层列出该阶段要掌握的议题,建议顺着路线图由浅入深;已有成文的篇目带链接,可直接点读。
学习路线
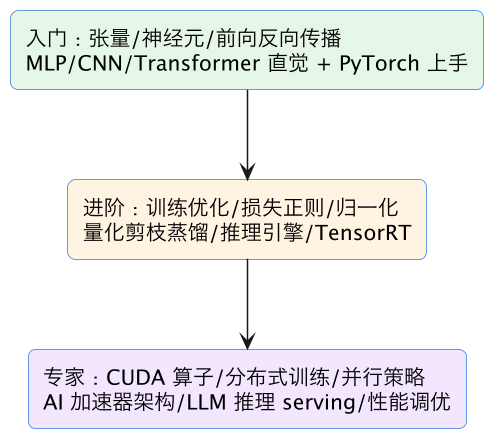
入门(beginner)
入门层建立神经网络的核心直觉,并能用 PyTorch 训练出第一个模型。
- 基础概念:神经网络解决什么问题、神经元与感知机、张量与矩阵乘法、激活函数(ReLU/Sigmoid)、前向传播、损失函数与梯度下降、反向传播直觉、学习率与超参数、过拟合与正则化、MLP
- 经典网络:卷积与特征提取、池化与感受野、CNN 图像分类、RNN/LSTM、序列与词向量、注意力机制、Transformer 直觉、自监督与预训练、BERT 与 GPT、LLM 是什么、token/embedding/softmax 与温度
- 第一次训练:批归一化、SGD/Adam 优化器、数据集与 DataLoader、训练/验证/测试划分、PyTorch 张量与自动求导、PyTorch 训练分类器、模型保存加载、GPU 为什么加速训练(对照 GPU 域)、推理是什么(对照 FPGA 推理入门)
- 评估与实用技能:准确率/F1、混淆矩阵、学习曲线诊断、数据增强、迁移学习、分类/回归/检测/分割入门、GAN 与扩散模型直觉、参数量与 FLOPs、延迟与吞吐、CUDA 环境与 Colab、常见报错排查、术语速查
进阶(intermediate)
进阶层覆盖训练工程、常见模型族与推理部署:让模型训得稳、评得准、上得了生产。
- 训练机制:计算图与 autograd、高性能矩阵乘/卷积直觉、GPU 内存层次、FP16/BF16 混合精度、梯度消失/爆炸与 Xavier/He 初始化、动量/权重衰减/warmup、cosine 学习率、Dropout、BN/LN/GN、残差连接、Multi-Head 与位置编码、Transformer 训练技巧、BPE tokenizer
- 微调与数据:fine-tuning 全流程、prompt-tuning、LoRA/PEFT、DataLoader 优化、DDP 数据并行、模型并行直觉、梯度累积/裁剪、focal loss 与类别不平衡、训练复现与随机种子、数据质量清洗、MLOps 实验管理、模型监控与漂移
- 视觉与序列任务:YOLO 目标检测、U-Net 分割与 mIoU、seq2seq 与 beam search、温度采样与解码策略
- LLM 应用衔接:RAG 检索增强、Agent 与工具调用
- 推理与压缩:INT8 量化入门(对照 FPGA 定点)、QAT、剪枝稀疏、知识蒸馏、ONNX 导出、TensorRT、ONNXRuntime/OpenVINO/TFLite 对比、Triton/vLLM 服务化、KV Cache、batching 与吞吐、Nsight profiling、显存 offload、A/B 评估、边缘部署(移动端/Jetson)、对抗样本与联邦学习
专家(expert)
专家层深入大规模训练的并行策略、LLM 推理系统与 AI 加速器硬件。
- 高性能算子:CUDA 核函数与 SIMT(对照 GPU 域)、手写 GEMM 与 tensor core、FlashAttention、kernel fusion、Triton/CUTLASS 自定义算子
- 分布式训练:3D 并行(DP/TP/PP)、ZeRO 显存分片、流水线并行与气泡、序列并行、RDMA/NCCL、Megatron/DeepSpeed、混合专家 MoE、通信量建模、loss spike 与训练稳定性
- LLM 推理:vLLM/PagedAttention、连续批处理、推测解码、GPTQ/AWQ/SmoothQuant、FP8/FP4 低精度、实时低延迟系统、长上下文与 RoPE/ALiBi、MoE 路由与负载均衡
- AI 硬件与集群:SIMT/脉动阵列/数据流(对照 FPGA 加速)、TPU/NPU、systolic array、存算一体、Roofline 与内存墙、GPU/FPGA/ASIC 选型(对照 FPGA vs GPU)、AI 集群网络、功耗 TCO、液冷供电
- 前沿与方法:大模型压缩全流程、多模态架构、扩散模型加速、RLHF/DPO、模型安全水印、数据合规、论文复现方法论、系统案例复盘
相关主题域
- gpu/ —— GPU 计算与 CUDA 编程(本域训练/推理的主要算力载体);
- fpga/ —— FPGA 设计与 AI 推理加速入门、定点/量化基础;
- chip-design/ —— AI 加速器/ASIC 设计方法;
- data-ai/ —— 机器学习应用、LLM 工程(Prompt/RAG/Agent)。
一句话总结
本页是神经网络域学习地图,按入门(张量、CNN/Transformer、PyTorch)、进阶(训练工程、量化压缩、推理引擎)、专家(分布式训练、LLM serving、AI 加速器)三层组织,从硬件与工程视角讲清深度学习全链路。