国产 AI 芯片与算力管制:买得到的卡、买不到的生态,和训练推理两本账
最后更新:2026-09-14
本文是产业观察,回答“管制到底卡了什么、国产 AI 芯片差在哪、接下来会怎样”。GPU/加速器的微架构、HBM、片上互联的工程原理属于 FPGA/芯片设计各篇(如 HBM 与存储 等),本文只讲产业结构、管制逻辑和生态壁垒。它和 设备材料国产化、HBM 与先进封装 构成上下游:AI 芯片是需求,设备、HBM 和先进封装是它脚下的地基。 这是一个政策几乎逐季变化的领域,数字来自各公司财报与管制公告的常见公开口径,2024 年及以前为已公布值,2025 年为量级估计,最新的管制清单与产品参数以官方披露为准,文末附口径说明。
先说结论
围绕国产 AI 芯片,最常见的两种误判都来自把问题简化成“芯片”本身:一种是看到一颗国产加速卡参数接近某代英伟达,就宣布“追平了”;另一种是看到先进制程和 HBM 被卡,就断言“没戏了”。
真相是,AI 算力不是一颗芯片,而是四样东西叠出来的体系:能做出来的先进逻辑(受制程限制)、喂得饱数据的 HBM、连得起来的高速互联(NVLink/InfiniBand)、以及让开发者愿意用的软件生态(CUDA)。 管制恰恰精准地逐层打击这四样:
- 芯片本体:高端 GPU 被列入管制,国产能造,但先进制程受限、单芯片良率和成本压力大;
- HBM:高带宽内存及其制造设备被纳入管制,而 HBM 是 AI 芯片性能的第一瓶颈;
- 互联:管制用“互联带宽”“性能密度”作指标,防止用降速版绕过,万卡集群所需的高速网络是另一个短板;
- 生态:这一层不靠禁令、却最牢固——CUDA 是二十几年堆出来的开发者、库和框架依赖,不是性能追平就能迁移的。
一句话:国产 AI 芯片“能用”的差距正在快速缩小,但“好用、敢用、生态认账”的差距以年计;最先突围的是推理,尤其是对生态和互联要求低、对成本和供应敏感的场景;最难的是超大模型训练集群,那里拼的是制程、HBM、互联和软件栈的全栈协同。 下面拆开。
一、先看体量:AI 算力是这轮半导体周期的总引擎
要理解为什么算力成为地缘焦点,先看它撑起了多大的生意。AI 浪潮把英伟达从一家游戏显卡公司推成了全球市值最高的公司之一:
- 英伟达数据中心业务营收,从财年 2024(截至 2024 年 1 月)的约 475 亿美元,暴增到财年 2025(截至 2025 年 1 月)的约 1150 亿美元,一年翻了一倍多;公司总营收站上约 1300 亿美元量级,毛利率长期在 70% 以上。
- 一颗高端加速卡(如 H100/H200/B200 系列)售价上万到三四万美元,而一个万卡集群的总投入(卡 + 网络 + 服务器 + 机房 + 电费)以十亿美元计。
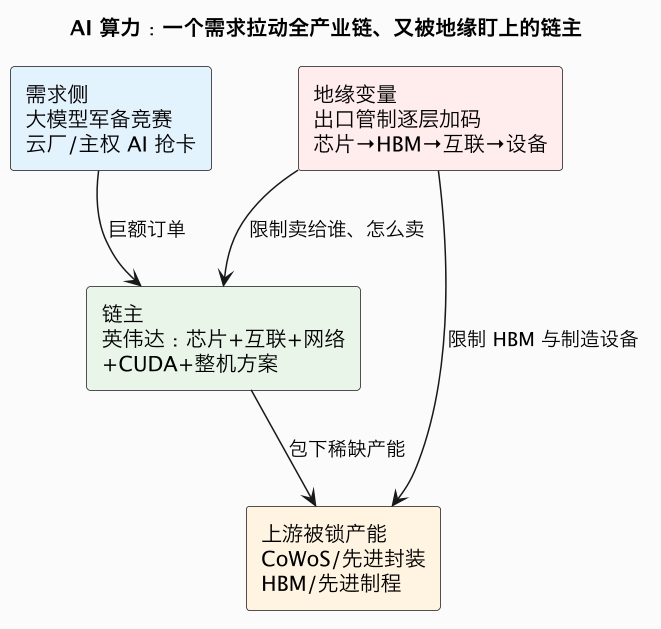
- 更关键的是链主地位:英伟达不只是卖芯片,而是卖“芯片 + NVLink/NVSwitch 互联 + InfiniBand 网络 + CUDA 软件 + 整机参考设计”的整套方案,并通过 CoWoS 先进封装、HBM 采购把 台积电、SK 海力士的产能 大量锁走。
这带来两个产业后果:
- AI 算力是这轮半导体周期的总引擎——先进制程产能、CoWoS、HBM、先进封装设备的扩产,很大程度是被这一类客户拉动的;设备、材料、封装厂的景气都挂在它身上。
- 它成为战略物资:当算力直接决定大模型能力、而大模型被视为下一代通用技术和军事/情报能力的基础时,高端 GPU 就从普通商品变成了和当年高端机床、超算一样的管制标的物。
二、出口管制卡了什么:一条逐步升级、精准堵漏洞的时间线
很多人以为管制就是“不卖最先进的卡”。实际过去几年,管制规则像补丁一样不断堵掉市场找到的绕行路径,理解这条升级线,才能看懂国产面对的真实约束。以下时间线为公开公告的概括,具体参数以官方原文为准。
2.1 第一轮(2022 年 10 月):卡高端训练卡与先进制程设备
美国出台首轮管制,同时打击“算力”和“造算力的能力”:
- 对中国禁售性能超过特定阈值的高端 GPU(直接命中 A100/H100),并要求其他高性能芯片逐单许可;
- 同步大幅收紧对中国先进半导体制造设备的出口,并引入“美国人员限制”,影响在华晶圆厂的先进制程扩产——这部分正是 设备材料国产化 的背景。
市场的应对很快:英伟达推出降速版 A800/H800,通过降低片间互联带宽(NVLink)把卡做到阈值以下,继续供货。这一步很关键——它暴露出最初规则只盯“单芯片算力”,没堵“互联”。
2.2 第二轮(2023 年 10 月):堵互联,引入“性能密度”指标
新规补上漏洞:
- 把A800/H800 也纳入管制,因为新增了对“互联带宽”和“性能密度(performance density,单位面积算力)”的考核,防止用降速或切割方式绕过;
- 同时把先进制程设备管制从“绝对参数”改为更细的阈值,进一步收紧。
这一轮后,“改个降速版继续卖”的空间基本消失。
2.3 第三轮(2024 年底—2025 年):卡 HBM、H20,规则随政策反复
- HBM 被纳入管制:高带宽内存及相关制造设备受限,SK 海力士、三星等停止向中国受管控实体供货 HBM——直接打在 AI 芯片性能的第一瓶颈上,详见 HBM 与先进封装。
- 针对为中国市场设计的降速版 H20(算力被砍、但保留大显存和部分生态兼容),2025 年初的“AI 扩散规则”将国家分三档差异化处理;随后政策出现反复——一度限制 H20、又以“许可 + 对华收入提成”等方式部分调整。这类反复说明:管制本身成为博弈筹码,供应预期变得高度不确定。
2.4 管制逻辑的精髓:卡的是“集群能力”而非单卡
把三轮连起来看,会发现管制真正想锁死的不是“某颗芯片”,而是**“用大量芯片组成超级训练集群”的能力**:
- 卡单芯片算力 → 防止单卡太强;
- 卡互联带宽 → 防止你把成千上万张卡高效连成一台超级计算机(训练大模型靠的正是线性扩展的集群,互联带宽和延迟决定了多卡能不能喂得动);
- 卡 HBM → 限制单卡能吞吐的数据量;
- 卡制造设备 → 防止你自己造出这一切。
管制的潜台词是:可以让你拥有一定的、分散的算力,但要阻止你获得“规模化、可线性扩展的顶级训练能力”。 这也解释了为什么国产替代会自然分成两个战场——对集群要求低的推理,和对全栈要求极高的训练。
三、买得到的卡,买不到的生态:CUDA 才是最深的护城河
如果管制明天全部取消,国产 AI 芯片就能立刻替代英伟达吗?短期也不能——因为最难复制的不是硅,而是软件生态。这道墙和 EDA 的统一数据库/签核认证 是同一类壁垒:用户锁死不是因为对手造不出产品,而是因为整条价值链都长在它上面。
英伟达真正的护城河是 CUDA(Compute Unified Device Architecture),自 2006 年起、比深度学习爆发早了整整十年就开始铺:
- 开发者习惯:全球数百万程序员写 GPU 通用计算,默认就是 CUDA C/C++、cuDNN、TensorRT、NCCL 这一套;
- 库的厚度:从基础线性代数(cuBLAS)、深度神经网络算子(cuDNN)、集合通信(NCCL,多卡训练的命脉)到推理优化、专业领域(医疗、EDA、科学计算)库,是二十几年沉淀的、被反复优化过的算子集合;
- 框架默认后端:PyTorch、TensorFlow 最先、最完整支持 CUDA,新模型、新算子几乎都先在 CUDA 上跑通;
- 硬件与软件协同设计:每代架构(Tensor Core、FP8、Transformer Engine、NVLink/InfiniBand 多机通信)都和软件栈一起定义,迁移不是重编译,而是重调、重验证。
这就是典型的双边网络效应:开发者越多,框架/库越完善,客户越离不开;客户越多,英伟达越有钱把生态做得更厚。国产芯片要替代,就得提供让开发者“低成本迁移”的栈:华为昇腾用 CANN + MindSpore、并提供 PyTorch 适配层;寒武纪、海光(DCU,类 CUDA 的 ROCm 路线)等也各有工具链。它们在国内特定场景已经能跑通主流模型,但长尾算子的覆盖、多机多卡通信库的成熟度、踩坑文档和社区规模,差距是按“生态年”计的,不是按芯片跑分计的。
性能可以靠架构和制程追,生态只能靠真实用户和时间喂。 这也是为什么国产 AI 芯片的突破往往从“对生态依赖低、模型固定、客户愿意一起调”的场景开始。
四、四道墙合在一起:国产 AI 芯片的真实差距地图
把前文收成一张分层表,可以看清“哪层能造、哪层难替”:
| 层 | 内容 | 国产现状 | 差距性质 |
|---|---|---|---|
| 芯片逻辑 | GPU/NPU 架构、算力、数据类型(FP16/INT8/FP8) | 昇腾、寒武纪等能做出对标上几代英伟达算力的产品 | 产品差距,靠架构+制程追 |
| 先进制程 | 先进逻辑的制造与良率 | 受设备/出口管制约束,最先进节点受限 | 地基差距,最难 |
| HBM | 高带宽内存及封装 | 主导厂在韩,设备被管制,国产 HBM 在攻关 | 性能第一瓶颈,详见 HBM 篇 |
| 高速互联 | NVLink/NVSwitch、InfiniBand、大规模集群网络 | 单卡可用,万卡级无损网络/集合通信是短板 | 工程 + 生态,随集群规模放大 |
| 软件生态 | CUDA/库/框架/开发者 | CANN 等可用并适配主流框架,长尾与社区差距大 | 生态时间,最牢固 |
| 整机/集群工程 | 供电、散热、整机、机房、稳定性 | 互联网大厂集成能力强,国产整机生态完整 | 相对最易补,中国有供应链优势 |
读这张表的关键结论:国产不是“造不出卡”,而是“造得出卡、却暂时凑不齐把万张卡变成一台高效超级计算机、并让百万开发者无痛迁移的全栈”。 而不同任务对这张表的要求天差地别——这就是下一节的两本账。
五、训练和推理是两本账:为什么推理先破,训练最难
舆论常把“AI 芯片”当成一个东西,但训练(training)和推理(inference)对硬件和生态的要求差别巨大,这决定了国产替代的现实顺序。
5.1 训练:对全栈要求最极端的场景
训练一个前沿大模型,需要成千上万张卡在数月里高频同步地更新同一组参数:
- 每一步都要做跨卡的梯度同步(all-reduce),对互联带宽和延迟极度敏感——卡越多,通信占比越高,万卡集群里网络往往比单卡算力更决定有效产出;
- 需要海量 HBM 喂数据、长时间高负荷稳定运行(个别卡掉点、位翻转都可能中断数周的训练);
- 要用最前沿的算子和框架特性,对最新 CUDA 生态依赖最深;
- 代价是,国产在这一档受 HBM、互联、制程三重制约,且集群越大,软件栈和可靠性的短板越放大。
5.2 推理:对单点更友好、成本驱动的场景
模型训完后对外提供服务(推理),要求则不同:
- 多数推理可以单卡或小规模并行,对跨机互联要求低得多;
- 主要拼单卡有效算力、显存容量、能效(每瓦每美元能跑多少 token)和供应稳定性;
- 模型一旦固定,运营商可以把算子一次性适配、固化,对 CUDA 长尾生态的依赖大幅下降——大厂有工程团队做这件事;
- 需求体量远大于训练(推理才是最终大规模、7×24 小时烧算力的环节),且对“买得到、供得稳、便宜、可控”极其敏感。
这就解释了替代的现实路径:
推理,尤其是固定模型、批量部署、对成本和自主可控敏感的场景(互联网内容推荐、政务/金融/行业私有化、端侧和边缘),会是国产 AI 芯片最先规模化的战场;超大前沿模型的训练集群,是最后、最难攻下的山头。
中间还有一块被反复验证的市场:用国产卡做“训练二供 / 推理主力”——最前沿模型可能仍在受限的高端卡上训,但微调和海量推理迁移到国产卡,既降风险又喂生态。
六、需求侧:国产算力为什么有一个真实、巨大、且被迫的市场
和 EDA、设备材料 面对的“客户怕冒险、不敢换”不同,国产 AI 芯片有一个特殊的需求结构——管制本身制造了一个“被迫但巨大”的买方市场。
- 互联网与云大厂:字节、阿里、腾讯、百度等既是最大算力买家,也有最强的软硬件适配工程能力。在高端卡供应不确定的预期下,它们大规模采购国产卡做推理和训练二供,并且自研 AI 芯片(如多家大厂的自研 ASIC)以降低对单一供应商的依赖。
- 运营商、银行、政务、能源等“国产优先”买方:对自主可控、本地化、数据安全的权重高于极致性能,昇腾等在这些领域形成了真实装机量。
- “主权 AI”之外的国内大模型公司:对算力极度渴求,愿意和国产芯片厂一起做深度软件适配,用工程投入换供应安全。
需求侧的确定性甚至强于供给侧:不管管制松紧,国内已经形成“必须建设自主算力底座”的共识,这给了国产 AI 芯片一个 EDA 和设备都羡慕的、规模庞大且愿意陪跑的真实基本盘。 风险在于阶段性的“供过于求 / 重复造轮子”,以及当外部高端卡阶段性可买时、短期成本性能比的诱惑。
七、五个变量:什么能改变方程
| 变量 | 能解决什么 | 改变不了什么 | 判断 |
|---|---|---|---|
| 推理需求爆发 | 对互联/生态要求低、体量巨大,给国产卡规模化和软件打磨机会 | 不直接解决万卡训练能力 | 最确定的突围口 |
| 云厂自研 ASIC + 深度适配 | 用大厂工程能力填平长尾算子、绑定自有业务 | 通用第三方生态仍弱 | 显著加速自用替代,催生多强 |
| 管制反复 / 高端卡阶段性可买 | 短期缓解供给 | 不改变“必须有自主底座”的共识,反而强化备货 | 短期扰动,长期方向不变 |
| 国产 HBM/先进封装进展 | 缓解性能第一瓶颈 | 制程与互联仍要单独补 | 关键变量,见 HBM 篇 |
| CUDA 兼容 / 类 CUDA 路线(ROCm、迁移工具) | 降低迁移成本 | 兼容永远慢一代、长尾算子仍要补 | 务实过渡,难成正面对等 |
一句话收口:这些变量会让国产算力在推理和行业场景里快速上量、在训练上做二供和特定集群,但“顶级训练全栈 + 通用生态对等”没有捷径,取决于制程、HBM、互联、软件四件事能否一起补齐。
八、差距清单与标注置信度的时间表
| 差距 | 性质 | 可压缩程度 | 主要靠谁 |
|---|---|---|---|
| 推理卡性能/能效/供应 | 产品 + 量产 | 高,正在放量 | 芯片厂 + 大厂 |
| 主流模型软件适配 | 生态工程 | 高,靠项目喂 | 芯片厂 + 互联网大厂 |
| HBM 供给与先进封装 | 地基 | 中低,受管制 | 存储/封测厂 + 长期投入 |
| 万卡级互联与稳定性 | 系统工程 | 中,随集群规模积累 | 芯片 + 网络 + 云厂 |
| 通用 CUDA 生态/开发者 | 生态网络效应 | 低,时间 + 用户 | 长期经营 |
| 先进制程下的单芯片性能 | 地基 | 低,绑定 设备材料 | 全产业链 |
带置信度的判断(政策敏感度高,年份比其他产业篇更不确定):
- 未来 2~3 年(高置信度):国产 AI 卡在推理、行业私有化、端侧/边缘大规模上量,成为多个云厂的推理主力或重要二供;主流开源/国产大模型在 CANN 等栈上的适配基本完备;云厂自研 ASIC 占比上升。
- 未来 3~5 年(中高置信度):国产集群能稳定训练千亿参数级模型并在生产中使用,“训练二供”常态化;国产 HBM 和先进封装取得阶段性突破,缓解显存瓶颈;形成 2~4 家有规模的国产算力平台。
- 未来 5~10 年(中置信度):在软件生态、互联和可靠性上接近“可承担前沿训练”的水平,但顶级前沿训练集群仍可能与最先进外部方案存在代差,且强依赖 国产设备材料 与 HBM/封装 的进展。
- 长期 / 低置信度:能否完全对等,取决于先进制造、HBM、互联和生态四件事的整体进度,以及管制是趋紧还是缓和。和设备、EDA 一样,AI 芯片的终极天花板仍由国产先进制造与封装能力决定。
九、对不同角色,这意味着什么
- 对用算力的公司/算法团队:把算力当作多供应组合来管理。推理和固定业务现在就可在国产栈上做适配和灰度,既降供应风险也积累迁移经验;前沿训练保留对多平台的可移植性(优先用框架高层接口,减少裸 CUDA 锁定)。
- 对 AI 芯片厂:胜负不只在跑分,在软件栈成熟度、算子覆盖、多卡通信库、稳定性和与大客户的联合打磨。绑定 1~2 个超大客户做深推理场景,比铺满市场更能沉淀生态;同时紧密绑定国产 HBM 和封装产能。
- 对云/互联网大厂:自研 + 外采国产 + 存量高端卡的混合是现实最优解;把“模型—框架—编译—硬件”的垂直优化能力做成护城河,反过来定义国产芯片的需求。
- 对政策与投资:算力是这轮产业最确定的需求,但要警惕重复造芯和阶段性产能过剩;着力点应在 HBM、先进封装、互联标准和软件生态这些“单家企业补不动”的公共短板上,而非单纯补贴造卡。
结语:买得到的卡,买不到的时间与生态
国产 AI 芯片的故事剥离情绪后很清晰:管制能一夜之间改变“买得到什么”,却改变不了“好用需要时间、生态需要用户、地基需要产业链”这三件慢变量。 芯片本体可以靠架构迭代快速追,但先进制程、HBM、万卡互联和 CUDA 生态,每一样都是以年计、甚至以十年计的积累。
但和 EDA、设备相比,它有一个独特优势:需求是被迫的、巨大的、且最有工程能力的中国互联网大厂愿意下场陪跑。 现实的画像是:推理先破、行业场景和端侧快速上量、训练做二供再逐步逼近;软件栈靠一个个真实模型喂熟,HBM 和封装随 另一条战线 推进。它不会是一场“某颗新卡发布就追平”的闪电战,而是一场需求极度确定、地基逐寸夯实、生态逐年增厚的持久战。
数据口径与延伸
- 数据口径:英伟达数据中心营收(FY2024 约 475 亿美元、FY2025 约 1150 亿美元、总营收约 1300 亿美元量级、毛利率 70%+)来自其财报常见公开口径;出口管制三轮升级(2022 年 10 月、2023 年 10 月、2024 年底—2025 年 HBM/H20/AI 扩散规则)依据美国商务部 BIS 公开规则的概括,管制阈值、产品名单和“国家分档”政策调整频繁,本文只做结构性描述,具体以 BIS 最新官方原文为准;各厂商产品参数与国产化进度为量级判断。2024 年及以前为已公布值,2025 年为量级估计。
- 相关产业观察:半导体设备与材料国产化(造算力的机器与原料)、HBM 与先进封装(AI 芯片的性能瓶颈与封装换道)、国产 EDA 的真实处境(生态与认证壁垒的姐妹篇)、中国芯片设计公司三十年。
- 工程背景:芯片产业链分工、片上存储器/Cache。
一句话总结:国产 AI 芯片面对的不是“能不能造一颗 GPU”,而是先进制程、HBM、高速互联和 CUDA 生态四道墙叠加;出口管制从单卡算力一路精准升级到互联、HBM 和制造设备,真正想锁死的是“万卡级训练集群”能力;但管制也逼出了一个巨大且有大厂陪跑的自主需求,所以最确定的突围顺序是——推理和固定场景先规模化、训练做二供再逼近,芯片性能可快速追、而生态与地基只能靠时间和真实负载喂;它的终极天花板,和设备、EDA 一样,仍由国产先进制造与 HBM/先进封装的进度决定。